Claude Code新玩法:9个开源技能包接管PR全流程

Theo开源TS-Tech技能包,让AI接管代码写完后的测试、PR与CI流程。
Theo 开源的 TS-Tech 技能包包含 9 个面向 Claude Code 和 Codex 的指令文件,专注代码写完之后的测试、代码审查、提交 PR 与修复 CI 失败等环节。其主技能「巨号」不急于开 PR,而是先复现缺陷或验证改动有效性,再依次调用多模型审查、PR 描述生成和保姆 PR 监控。技能提供全力冲刺与全力刹车两种模式,区别在于是否自动合并。「console」技能接入 Claude、GPT、Gemini 三家模型交叉审查。文章同时指出技能间存在依赖、需额外配置多模型访问,建议从低风险变更和文件 PR、保姆 PR 起步分阶段上手。
当AI开始处理「写完代码之后」的那些事
大多数AI编程工具都在卷一件事:怎么让模型写出更漂亮的代码。但一位名叫 Theo 的开发者开源了 9 个 AI 智能体技能,解决的是代码写完之后的烂摊子——测试、代码审查、提交 PR、修复 CI 失败,甚至把没做完的 PR 接管过来。据 B 站 UP 主 Better Stack 的介绍,这套名为 TS-Tech 的技能包已经引起了不少关注。
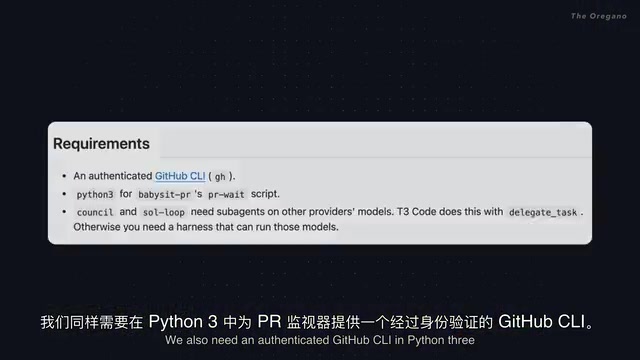
这套技能与 Claude Code 和 Codex 配合使用,安装方式并不复杂:克隆仓库,把技能复制到对应的技能目录即可。部分高级功能需要额外的环境准备,比如为 PR 监视器提供经过身份验证的 GitHub CLI,以及访问其他厂商的模型。
主技能「巨号」:从证明问题存在开始
这套技能里最受关注的是主技能「巨号」(原文音译)。它的工作流程有一个反直觉的起点:不急着打开拉取请求,而是先尝试证明这项改动确实有效——复现原始缺陷、运行测试,或者直接检查应用本身。
这个设计背后是对 AI 编程现实痛点的洞察。Better Stack 在视频里点得很直接:AI 确实能写个修复方案出来,但你一运行,它直接就崩了,然后还得再来一个修复去补最开始那个修复捅出来的娄子,有时甚至陷入循环。先验证、再提交,等于把「表面修好了」和「真的修好了」区分开来。
完成验证后,「巨号」会依次调用其他技能:灵魂循环引入另一个 AI 模型审查代码并逐条处理反馈;文件 PR 负责生成描述。你可能没注意到 PR 描述的写法——它没有罗列触碰过的每个文件,而是从面临的核心问题讲起,说明修复方法并展示测试过程,让 PR 真正容易理解。
代码智能体(Coding Agent) 在此类工作流中通常指能够自主读写文件、运行命令、调用外部工具的 AI 程序,Claude Code 和 Codex 是当前较有代表性的两种实现。与普通的代码补全不同,智能体可以按任务目标规划多步操作,因此才可能完成“复现缺陷→运行测试→提交 PR”这样跨越多个工具的链条。理解这一点有助于明白:本文所说的“技能”并非模型本身的能力,而是一组给智能体的结构化指令,用来规定它在每个阶段该做什么、按什么顺序做,以及何时该停下来等待人类决策。
保姆 PR 与「全力冲刺 / 全力刹车」
多数智能体到提交 PR 就收工了,这套技能的差异在于继续往前走。保姆 PR 技能专门盯着 CI 和评审反馈,一旦出现失败或合理的审查意见,它能调查问题、做小修复、再次验证。但即便如此,「巨号」也不会自己合并 PR——它把最终决定权交还给人类。
Better Stack 由此总结出两种模式:全力冲刺(full speed)和全力刹车(full stop)。前者走完链条——证明问题、灵魂循环审查、文件 PR、保姆 PR 监控,一旦必要检查和审查通过就自动合并;后者走同样的流程但不合并。区别在于完成的是什么工作、谁做最终决定。
这套技能的价值不在于让 AI 更会写代码,而在于它处理的是代码写完后通常被甩回给你的重复性工作:不必在终端和 GitHub 之间来回切换,等结果就绪再审查。
CI(持续集成) 指代码提交后由服务器自动执行的一整套检查,包括编译、单元测试、静态分析等,结果通常以通过或失败的形式反馈到 PR 页面。分支保护 则是仓库层面的一条规则,规定某些检查未通过或未经指定人员批准时,禁止合并到主分支。这两项机制共同构成了“保姆 PR”能够自动判断何时该介入、何时该停下的外部依据。没有可靠的测试和分支保护,让智能体自动合并 PR 就相当于拆掉了安全网,这也是原文强调该技能仍需真正有效的测试与权限配置的原因。
多模型评审与依赖陷阱
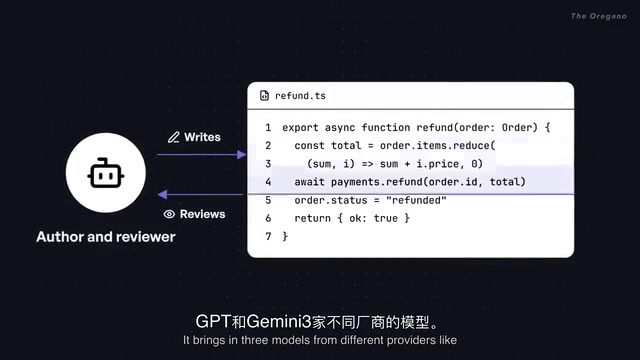
另一个值得关注的技能是 console(原文音译)。如果你让 AI 审查自己的代码,依赖的是单个模型的判断,容易另辟蹊径——而这个技能接入了 Claude、GPT 和 Gemini 三家不同厂商的模型,让它们各自审查实现、提出问题,并经历额外轮次直到达成一致或触及工作流限制。
需要清醒看待的是,三个模型达成一致并不自动意味着它们是对的,但不同模型能发现单一模型可能遗漏的问题,相当于一种委员会式的双重检查。此外还有 takeover 技能,用于接管另一个智能体启动但从未完成的 PR,读取现有工作、找出缺失部分并从断点继续;以及 modernize 技能,用于判断某个改动是否仍有必要。
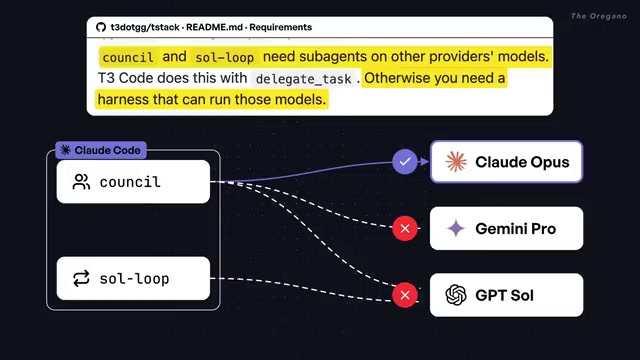
这些技能并非完全即插即用。高级审查工作流需要额外的模型配置,灵魂循环和 console 都依赖多模型访问能力,基础配置下拿不到完整工作流。
多模型交叉验证 的思路来自集成学习中的“多样性”原则:不同厂商的模型在训练数据、对齐策略和解码倾向上存在差异,因此同一个缺陷未必会被所有模型同时忽略。让 Claude、GPT、Gemini 各自独立审查再汇总分歧,能提高发现边缘问题的概率。但需要注意,模型之间可能存在共同的盲区——例如都倾向于接受看似合理的接口设计——此时“一致同意”反而会放大错误。因此这类委员会式评审适合作为人工审查前的过滤层,而不是最终裁决。
谁该用,怎么用
这套技能的局限同样明确。技能之间相互依赖——「巨号」会调用「全力冲刺」,而后者又调用其他技能,只安装单个技能而遗漏依赖项就会出问题。它本质上是给 AI 代理的指令而非独立系统,仍需要合适的权限、真正有效的测试和分支保护。对每次改动来说,它也未必是最快或最便宜的选择。
Better Stack 给出的建议是分阶段上手:如果你已经在用 Claude Code 或 Codex,并且每周要提交多个 PR,值得一试,但别一开始就全力冲刺。先从文件 PR、保姆 PR 这类环节跑通仓库流程,等额外模型配置好之后再尝试全力刹车模式;如果最终信任了流程,再决定全量推送是否适合较小、低风险的变更。另一条建议是任何技能都应按自己的工作流程定制,而不是直接丢进去就信。
这套开源技能的有趣之处,不在于让 AI 更擅长写代码——它并没有——而在于它接管了代码写完后那些通常被甩回给人的工作。如果你在探索 AI 编程工作流的自动化边界,这个项目提供了一个具体的参照样本。
相关推荐

MiniMax H3 Image开源实测:16图参考、海报排版与Agent生图全解析
MiniMax开源生图模型H3 Image实战评测:对比GPT、Gemini、豆包,测试中文海报排版、16张参考图多图组织、爆炸图中文标注,并演示通过API接入DeepSeek Harness实现Agent自动生图与换色迭代。

DeepSeek开源Harness:插件化开发工具27万星
DeepSeek官方开源项目Harness在GitHub获27万星,TypeScript编写、MIT协议。本文拆解其插件化架构、多模型对比功能、四类适用场景及上手三步走,帮你判断是否值得接入。

提示词工程从入门到实战:B站教程讲透核心认知
B站教程系统讲解提示词工程核心认知:提示词的四层作用、提示词与提示词工程的区别、六步实践流程、四大目标,以及上下文限制、幻觉、成本陷阱等真实局限,帮助初学者建立可复用的AI协作方法论。