Claude Code一句话交付功能:无追问工作流实战

把「一句话交付功能」拆成可验证步骤,用结构化prompt和独立评审让AI写的代码可被证明正确。
文章介绍了一位B站UP主分享的Claude Code实操方法,指出AI写代码的速度已不是瓶颈,真正的难题是证明代码写对了。直接甩截图加一句「修一下」会让模型自行补全缺失信息,产出经不起review的AI slop。作者提出五个前置习惯降低上下文噪音:多用语音输入、一个会话只做一个任务、把编码规范移出CLAUDE.md、给Agent一个浏览器、纠正两三次不对就止损重来。核心是一条由context、planning、done criteria、limits、check五部分组成的终极prompt,要求Agent先探索复现、写计划文件、开工前锁定验收标准、明确禁止事项并交付证据。评审与QA必须由独立Agent完成以避免偏好偏差,整套流程可固化为skill和agent复用。
AI写代码的速度早已不是瓶颈,真正卡住团队的是「怎么证明它写对了」。一位B站UP主分享的Claude Code实操方法,核心思路是把「一句话交付一个功能」拆成可验证的步骤,让Agent在动手前就把上下文、验收标准、边界条件全部锁定。
为什么直接甩截图给AI会产出「AI垃圾」
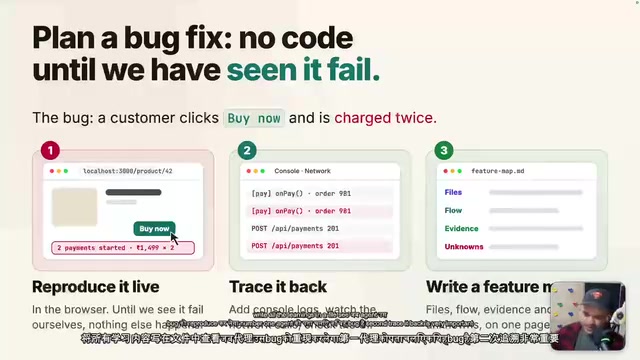
很多人的日常操作是:截一张图,配一句「点购买按钮报错了,修一下」。
这看起来高效,实际上是在让模型替你补全缺失的信息。模型不知道你说的是哪个元素、哪个文件、哪一行,它只能猜。猜对了是运气,猜错了就是一堆看似合理却经不起review的代码。据这位UP主在B站视频中的表述,这类只给半截信息的prompt方式,「就等着收AI slop吧」。
问题的根源不在于模型不够聪明,而在于它太聪明——聪明到会主动填补你没说的空白,自行决定「用户大概想要这个」。你从没明确说过「先问我」,它就默认「直接干」。
AI slop 是社区对「看似合理、实则空洞或错误」的AI生成内容的统称,字面可译为「AI泔水」。它区别于直接的报错或崩溃,往往语法通顺、结构完整,但逻辑经不起推敲、与真实需求脱节,reviewer需要花大量时间逐行甄别。在代码场景中,AI slop 的典型表现包括:为了「修好」按钮而重写整个组件、添加未被要求的依赖、把异常吞掉让测试变绿。其产生机制与模型的自回归补全特性有关——模型倾向于生成「最可能的下一个token」,而非「最符合你意图的代码」,当输入信息不足时,它会用训练数据中的常见模式填补空白,产出高度模板化但未必贴合当前代码库的代码。
五个前置习惯,把上下文压到最低噪音
在抛出那条终极prompt之前,UP主先给了五条实践建议,每条都在减少Agent的猜测空间。
用说的,别用敲的。 语音输入天然比打字提供更多上下文,人在说话时往往会不自觉补上限制条件和护栏,这些恰恰是打字时因为嫌麻烦而省略的部分。
一个会话只做一个任务。 当上下文窗口用到30%到40%时,模型性能就开始下滑,而这个区间恰好也是它能力上限附近。多任务混跑会让token迅速膨胀,输出质量肉眼可见地变差。超了就应该compact或直接开新会话。
把编码规范从CLAUDE.md里搬走。 这是很多人踩的坑:把lint规则、组件写法、null检查全塞进CLAUDE.md,导致指令过多、Agent开始跳过。UP主建议CLAUDE.md控制在200到300行,lint交给ESLint,编码标准另找地方放——Anthropic官方也倾向于这个方向。
给Agent一个浏览器。 做前端时让它能真实打开页面、执行点击、自己验证结果,而不是靠想象判断「应该没问题」。
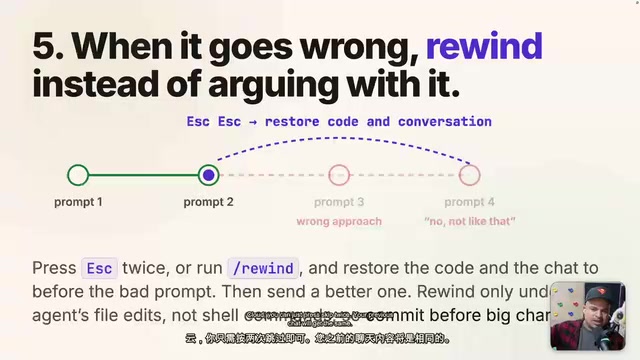
纠正两三次还不对,就止损重来。 继续在同一个会话里堆「再试试这个、再试试那个」,只会让上下文越来越脏。Claude里可以按两次skip回到之前的对话节点,从出错前的位置重新开始,带着「知道什么不该说」的经验开新局。
上下文窗口(context window) 指模型单次推理能容纳的token总量,包括系统提示、对话历史、文件内容和工具返回结果。它并非「越大越好用」:随着已用token逼近上限,模型对早期信息的注意力会被稀释,出现「中间遗忘」(lost in the middle)现象——开头和结尾的指令记得清楚,中段内容容易被忽略。实践中观察到的30%到40%性能拐点,与注意力资源分配和长上下文训练分布有关。Compact 是Claude Code等工具提供的上下文压缩操作,会把历史对话总结成更短的摘要再继续,以释放窗口空间;但它是有损的,关键细节可能在压缩中丢失,所以更稳妥的做法仍是「一个会话一个任务」,在超限前主动开新会话。
终极Prompt的五个组成部分
UP主把那条「一句话交付」的prompt拆成五块:context、planning、done criteria、check and limits。
Context:精准定位,而不是全屏截图
修bug时给出文件名或大概位置;做功能时给出可参照的同类功能或目标文件;有真实报错就贴报错,有截图就贴截图。关键在于截图要给局部而不是全屏——全屏截图会让Agent在十个可能的位置之间反复猜。
他自己的解法是一个Chrome扩展,点击目标元素后直接拿到selector、文本内容、React组件名、组件在代码库中的路径和行号,连同截图一起喂给Agent。这样就彻底消除了「这个文字到底在哪个文件里」的猜测。
Selector 是CSS选择器,用于在DOM中唯一标识一个元素,例如 button#buy-now 或 [data-testid="purchase"]。给Agent提供selector而非「那个购买按钮」,等于把「元素定位」这一最容易出错的环节从模型猜测变成了确定性输入。在React项目中,仅靠selector还不够——同一个按钮可能来自共享组件,真正的修改点位于组件源码而非使用处。因此把React组件名与文件路径、行号一并提供,能让Agent直接跳到定义处,避免在多个调用点之间反复试探。Chrome DevTools的Elements面板和React DevTools的Components面板都可以辅助获取这些信息,这也是UP主自建Chrome扩展所自动化的那一步。
先探索,再动手
修bug时不要让Agent直接「去修」,而是要求它:先复现、再回溯、把学到的一切写进文件。具体是让它加console log追踪bug从哪来,形成完整stack trace,期间不写任何修复代码。做功能时同理,先让它读目标文件和相关路由,搞清楚组件怎么挂载、API调用怎么管理、state怎么流转,建立这个屏幕的「知识图谱」。
还要显式要求「为每一次点击做计划」——每个handler、每个state变化、每个API调用都记录在案,写成文件。到这里为止都还没有一行代码,但计划错了只需要改一个文件,代码写错了就得来回拉扯。
Done Criteria:开工前就定好验收
第一句prompt里就要写清「修好之后应该是什么行为」或「功能上线后我能做哪些操作」。Agent会拿这些标准自检,通过之后才标记任务完成。配套的硬性要求包括:每一步加console log确认行为符合预期;不要基于理论或假设工作——UP主说自己从Agent那里学到了「I assumed」和「worked on theory」这两个词,现在每次都会明令禁止;最后要交付证据:截图、录屏、测试结果。
Limits:明确写出不能做什么
禁止引入新库、禁止改动public API、禁止为了让测试通过而修改测试、不要压制错误而要解决根因。以及一条被UP主称为「必须加」的指令:确保没有回归。把staging或生产URL作为source of truth交给Agent,任务完成后对比本地与线上环境的结果是否一致。
代码评审和QA必须换一个Agent
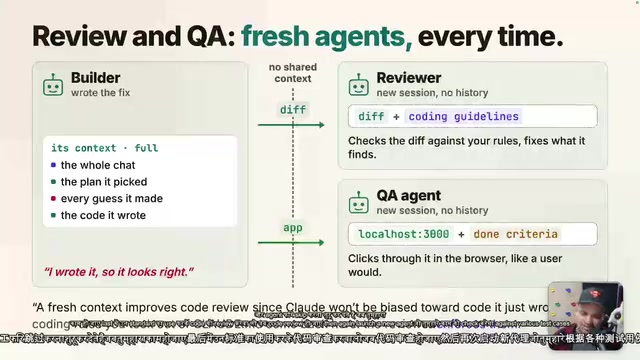
主Agent永远不该review自己的代码。UP主的解释是preference bias——Agent倾向于认为自己做的活是对的,即使错了也会告诉你没问题。
正确做法是分三段:主Agent完成实现后,起一个独立的reviewer Agent,对照编码规范逐条审查;review通过后,再起一个独立的QA Agent,用各种测试用例跑一遍,给出go / no go的结论。评审和QA过程中发现的教训要沉淀成learning文件,下次实现时提前喂给主Agent,避免重复踩坑。
Preference bias(偏好偏差) 在LLM评审场景中表现为:模型对自己刚生成的输出打分时,倾向于给出更高评价,即使输出存在明显缺陷。这与人类的自利偏差类似,但成因不同——评审时模型能看到自己之前的推理轨迹,这些轨迹会成为「合理化」当前答案的额外依据,形成自我强化的闭环。缓解手段包括:使用独立的会话或独立的Agent进行评审,切断推理轨迹的可见性;为评审者提供与实现者不同的系统提示,明确其「挑错」角色;以及要求评审结论附带具体证据(文件、行号、复现步骤),而非笼统的「看起来没问题」。三段式(实现—评审—QA)分工正是把这些手段制度化的结果。
把流程固化成Skill和Agent
反复写这一长串prompt不现实,UP主把整套流程做成了开源仓库中的skill和agent。以fix bug skill为例,步骤被固定为:检查输入(缺文件、路由就让用户补)→ 建图并复现(加console log、产出learning)→ 外科手术式修复(surgically,只改该改的地方,不许顺手优化旁边那个按钮)→ 在干净的工作树上验证 → review、QA并输出固定格式的报告。build skill里还有个有趣的0.5步「compare against the oracle」,即对照原始source of truth——线上URL或原始分支——来验证结果。
调用时只需一句:
fix this bug,位置在xxx,这是context,用bug fixer agent处理。
planning、checks、limits全由skill承担,用户只需要提供done criteria——因为每个项目的验收标准不同,这部分无法内置。
这套方法并非万能。UP主自己也说明,如果只是随手探索、修个小bug、而且你自己都说不清done criteria是什么,那这套结构化prompt帮不上忙,直接上手更快。它真正适合的是有真实用户、改动会进生产环境、需要向reviewer交付信心的场景。
要点回顾
整套工作流的底层逻辑是一次角色转换:你不再是「提需求的人」,而是「定义验收标准和质量边界的人」。Agent负责探索、计划、实现、自证,你负责说清楚什么叫做完、什么不能碰、以及最终拿什么证据说话。
相关推荐

Workbuddy零基础入门:桌面AI智能体如何落地工作流
Workbuddy桌面AI智能体零基础教程解读:从安装、积分领取到文件管理与自动化工作流搭建,对比CodeX的适用场景与成本差异,帮助职场人完成从AI提问者到AI管理者的思维转变。

OpenAI智能体新栈:计算机操作、决策API与超速工作流
OpenAI Dev Day发布智能体新栈:Computer Use操作速度超越普通人,Decisions API基于Luna实现极低延迟分类,Agents API开放同源计算机操作能力,GPT-6.1 Sol成本仅为Astra七分之一。本文梳理核心更新、实测数据与开发者落地要点。

梁文峰开源推理框架DeepInfo,硬刚美国禁令
DeepSeek在开源模型后再开源推理框架DeepInfo,包含GPU/CPU交叉流水线、小模型预判大模型复核、华为昇腾与英伟达芯片全面适配等技术,直面美国联邦禁令。本文解析其对AI产业落地的意义与开源策略。