Claude Fable 5.2登顶Artificial Analysis,65分成新高
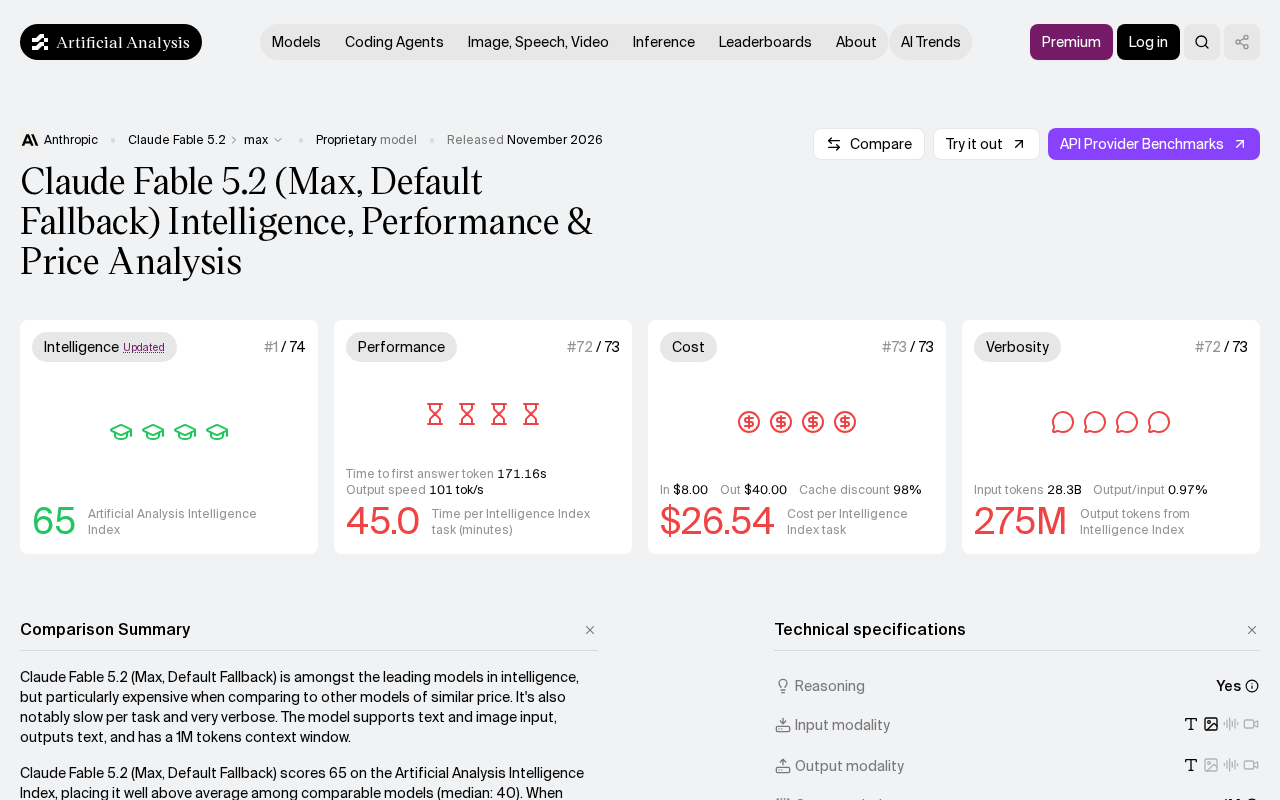
Claude Fable 5.2 在 Artificial Analysis 拿到 65 分刷新纪录,但综合榜单分数只能作为选型起点。
Hacker News 上一则简短讨论指出,Claude Fable 5.2 在 Artificial Analysis 上获得 65 分,被指为该榜单迄今最高分。文章借此讨论模型评测的老问题:综合榜单把多个基准压缩成一个数字,便于横向比较,却掩盖了推理、长文本、指令遵循等具体维度的差异,且排名随模型迭代快速变动。原始素材未披露评测构成与分差,帖子互动量也偏低,反映社区对榜单刷新已产生信息免疫。作者建议开发者将该模型纳入候选池,但需结合自身任务分布做小规模对照测试,并把成本与延迟一并纳入考量。
一次分数刷新,引出模型评测的老问题
Hacker News 上出现一条简短讨论:Claude Fable 5.2 在 Artificial Analysis 上拿到 65 分,是该榜单至今的最高分。帖子本身只有 29 个点赞和 5 条评论,信息量不大,但它指向的问题并不小——当一个大模型在某个第三方榜单上刷新纪录,这个分数到底意味着什么。
Artificial Analysis 是近年来被频繁引用的模型评测平台之一,它会将多个基准测试的结果综合成一个可供横向比较的分数。对开发者来说,这类榜单的价值在于降低选型成本:不必自己跑一遍全部测试,先看综合排名再决定是否深入。Claude Fable 5.2 这次拿到 65 分,按原始素材的说法是"迄今最高",说明它在该平台当前的评测体系下超过了此前所有被测模型。
需要说明的是,原始素材没有披露这个分数的具体构成、测试项权重,也没有给出与第二名之间的差距。因此更稳妥的读法是:这是一个值得关注的信号,而不是可以直接换算成实际体验差距的结论。
Artificial Analysis 是一个独立的模型评测聚合平台,其核心做法是选取一组公开基准(如 MMLU、HumanEval、GPQA 等),按一定方法将各模型在各基准上的表现归一化后加权合成一个总分,并对模型输出质量、推理速度、每百万 token 价格等维度分别给出指标。它的评分体系会随基准更新和权重调整而变化,因此不同时间点的分数严格来说不完全可比。该平台常被开发者用于快速了解模型的能力梯队与性价比分布,但其方法论细节(如采样温度、few-shot 设置、是否使用工具)会影响结果,引用时应留意其公开的方法说明。
65分背后的评测逻辑
综合分数擅长什么,不擅长什么
把多个基准压缩成一个数字,好处是直观,代价是丢失细节。一个模型可能在推理类任务上领先,在长文本理解或指令遵循上落后,但综合分只呈现平均后的结果。对具体业务来说,真正重要的是与自己场景最相关的那几项测试,而不是总分排名。
基准测试的饱和与污染是理解综合分的另一个关键背景。许多经典基准(如 MMLU)已被头部模型刷到接近上限,区分度下降;同时训练数据中可能混入测试题目,导致分数虚高即所谓数据污染。此外,不同基准的难度分布与任务类型差异很大,简单平均会让某些维度被稀释。因此业界逐渐转向更难、更新鲜的基准(如 GPQA、ARC-AGI)以及人工对战式评测(如 LMArena 的 Elo 评分),用多维信号交叉验证,而非依赖单一综合分。
榜单分数的时效性
模型迭代速度很快,榜单排名也随之变动。今天的最高分可能在下一次更新后被追平或反超。把某一时刻的分数当作长期结论,容易做出过时的判断。更合理的做法是把它作为观察趋势的一个数据点。
模型版本号的命名值得留意:素材中的“Claude Fable 5.2”并非常见的 Anthropic 公开命名体系(如 Claude 3.5 Sonnet、Claude Opus 4 等),更像是社区帖子中的非正式称呼或笔误。在引用此类信息时,建议先到厂商官方发布渠道核对模型名称、版本与能力说明,避免因命名混淆把不同代际的模型混为一谈——这本身也是评估榜单消息可靠性的第一步。
社区反应为何相对冷淡
帖子只有 5 条评论,这个互动量在 Hacker News 上属于偏冷。原因可能有两层:一是帖子本身信息极简,只有一个标题式结论,没有附带评测方法或对比数据,讨论缺少抓手;二是社区对"某某模型又拿第一"这类消息已经产生一定免疫——榜单刷新频繁,单看排名难以引发深入讨论。
这也提示内容传播的一个现实:分数本身是钩子,但真正让人愿意讨论的是分数背后的方法透明度、可复现性,以及与实际使用体验的对应关系。缺少这些,再高的分数也只能停留在标题层面。
对开发者的实际参考价值
对正在做模型选型的团队,这条消息可以这样用:先把 Claude Fable 5.2 纳入候选池,再回到自己的任务分布上做小规模对照测试。综合分高只说明它在评测覆盖的范围内表现均衡,并不能保证在你的特定场景里同样领先。
另一个常被忽略的点是成本与延迟。榜单分数通常只反映能力,不反映推理开销。一个综合分略低但调用成本明显更低的模型,在规模化部署中可能更划算。
做小规模对照测试时,可采用任务集抽样 + 双盲评审的轻量方案:从自己的真实请求日志中抽取 50–200 条代表性样本,覆盖主要任务类型与边界情况,让两个模型在相同提示词、相同温度下生成结果,再由不被告知模型来源的评审者按统一标准打分。同时记录每次调用的 token 用量、端到端延迟和失败率,把能力分与成本分放在同一张表里对比。这样得到的结论虽然样本量有限,但比任何公开综合分都更贴近自身业务。
小结
Claude Fable 5.2 在 Artificial Analysis 上取得 65 分并被指为当前最高,是一个明确的信号:该模型在综合评测维度上处于领先位置。但由于原始信息未披露评测细节和分数差距,这个结论更适合作为选型的起点而非终点。对榜单保持关注、对分数保持审慎,或许是面对每一次"新高"时更实用的姿态。
相关推荐

告别Copilot订阅费:三款免费本地AI编程工具推荐
GitHub Copilot每月20美元太贵?Workflows HQ推荐三款免费本地AI编程工具:Cursor离线补全、Clawed 3.7处理多文件架构、Make自动化测试部署,覆盖开发全流程。

AI编程代理如何工作?Codex、Claude Code与Cursor解析
深入解析AI编程代理的工作原理:从探索代码库、拆解任务、生成代码到运行测试与修复错误,揭秘Codex、Claude Code、Cursor等工具背后的代理循环机制,并探讨开发者如何审查与验证AI生成的代码。

Cursor AI 自动搜索:Python+Selenium 实战
用 Cursor AI 生成 Python + Selenium 脚本,一句话提示词实现 Google 自动搜索:定位搜索框、输入关键词、回车提交、打印页面标题,附关键 API 解析与实践注意事项。