Claude Fable 5.2发布解读:最强模型被刻意削弱?
Anthropic发布Fable 5.2,但训练阶段刻意削弱关键能力,揭示公开模型与内部前沿的差距。
文章基于B站UP主Wes Roth的解读,介绍Claude Fable 5.2与Mythos 5.2的发布。两者本质相同,Mythos限制更少,约对应Anthropic内部序列的Model 3 early。Anthropic在训练阶段主动限制了加速器内核优化与LLM架构改进两项能力,而非推理时过滤。模型仍展现出千智能体协作八天造出可启动操作系统的能力。秘密agent scaffold让模型首次可用于自主实验,被指向递归自我改进的临界点。文章用《安德的游戏》中豆子的类比,并讨论开源模型反超的可能性,预测未来前沿模型发布可能普遍采用类似限制策略。
发布即巅峰,但巅峰是被设计过的
据B站UP主Wes Roth的解读视频,Claude Fable 5.2与Mythos 5.2正式发布。按他的说法,这是"凡人能用到的最强模型",在长周期、高复杂度的大问题上表现出色,单位任务成本甚至低于Opus。
但这次发布和以往有本质不同。Anthropic并没有放出训练所能达到的最好版本——他们在训练阶段就"刻意削弱"了模型在特定方向上的能力。
UP主用了一个比喻:如果只能拿高中试卷考一个已经读到大学的人,你就很难看出他到底进步了多少。模型已经跑到了基准测试的前面。
我们拿到的是"第三代早期"?
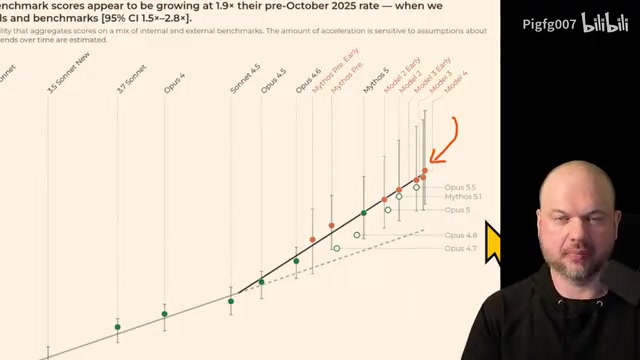
视频引用了一份名为Meter的报告(据称来自Anthropic内部),其中提到内部存在Model 2、Model 3、Model 4等版本,而Model 4已经在Anthropic内部基准AECI上全面超过50%。
按UP主的推断,Fable 5.2与Mythos 5.2大致对应Model 3 early——也就是内部序列中并不靠前的那一档。两者本质相同,Fable只是多了更多护栏限制。
这也意味着,公开可用的模型与内部前沿之间的差距,或许比很多人想象的要窄得多。
AECI(Anthropic内部基准)并非公开的行业标准测试,而是Anthropic用于内部模型评估的专有基准集,通常涵盖推理、编码、长上下文、工具使用等维度,并设有超过50%等阈值作为能力档位的划分依据。由于不对外公开,外界只能通过泄露报告或官方披露间接了解其含义。文中“Model 4全面超过50%”意味着内部模型在AECI上已达到较高通过率,而公开版本对应“Model 3 early”,说明公开模型与内部前沿之间存在可量化的代际差距。
被削的是哪些能力?
Anthropic联合创始人Sam McCandlish在Meter报告中承认,报告有大量内容被删节,原因是他们不想公开究竟是什么在加速AI研发。
具体被限制的方向有两个:加速器内核优化,以及改进大语言模型架构。
这里要区分清楚:限制不是发生在推理阶段(不是用户提问时被过滤),而是在训练阶段就主动抑制了这些研究能力的进展。换句话说,模型出厂时就已经被"卡"在了某个水平线上。
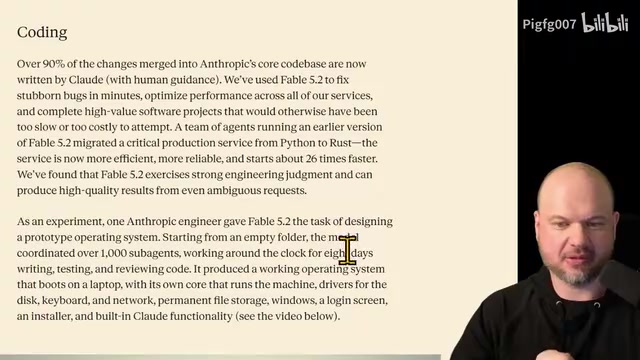
即便如此,能力依然惊人。视频提到一个实验:Anthropic工程师给Fable 5.2一个空文件夹,让它设计一个原型操作系统。模型协调超过1000个智能体昼夜不停地编写、测试、审查代码,持续八天,最终产出一个能在笔记本上启动的可用系统——包含自有内核、磁盘/键盘/网络驱动、持久化文件存储、Windows登录界面安装器和内置云功能。
加速器内核优化(accelerator kernel optimization)指针对GPU/TPU等AI加速器编写和调优底层计算内核,以提升训练与推理效率;改进大语言模型架构则涉及注意力机制、层结构、训练目标等核心设计。这两项能力之所以被限制,是因为它们直接决定模型研发的速度与上限:若模型能自主优化内核和架构,就能加速下一代模型的训练,从而缩短递归自我改进的周期。在训练阶段抑制这些能力,意味着模型在出厂时就不具备自主推进AI研发的关键技能,而非在用户使用时才被过滤。
递归自我改进的临界点
视频中最有信息量的推断,与"自主实验"有关。
UP主把线索串了起来:Karpathy的NanoGPT自动研究项目,思路是给智能体一套真实的语言模型训练环境,让它整夜自主做实验,好的改进保留、差的丢弃,形成反馈循环。而Anthropic提到的那个被涂黑的"agent scaffold",很可能就是类似的东西。
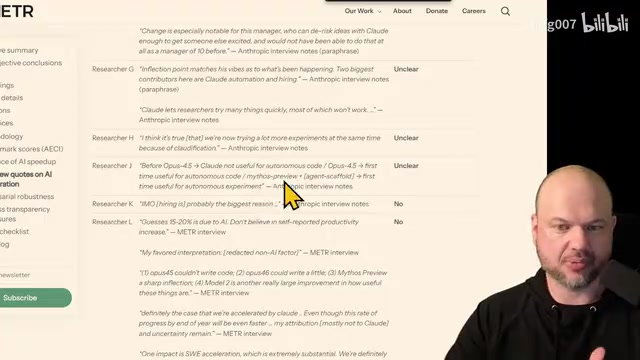
演进路径大致是:Opus 4.5之前,模型对自主写代码没用;Opus 4.5首次可用于自主编码;Mythos preview加上那个秘密脚手架,首次可用于自主实验。
有研究员表示,愿意为"一年内取得超过两年的进展"背书,甚至认为四倍也不算离谱。Anthropic方面则被描述为正在接近递归自我改进(RSI)。
这就引出了一个尖锐的问题:如果模型能够自主做实验,那么拿到一个足够强的模型,理论上就能让它做实验直到复现出自己。Anthropic限制内核优化和模型架构改进,本质上是在给"自我复制"这件事划一条线。
递归自我改进(Recursive Self-Improvement, RSI)是AI安全与能力评估中的核心概念,指一个智能系统能够自主改进自身架构、训练流程或代码,从而在下一轮获得更强能力,形成正反馈循环。理论上,一旦循环启动,改进速度可能呈指数级增长。业界常以“智能爆炸”描述其极端情形。正因如此,许多实验室将RSI视为需要审慎对待的临界点:它既可能是通向超级智能的捷径,也可能带来难以预测和控制的风险。文章中提到限制内核优化与模型架构改进,正是试图在能力层面延缓这一循环的启动。
一个书中的类比,与一个待验证的猜想
UP主用《安德的游戏》中的豆子(Bean)作比:豆子胚胎期经过基因改造,天资极高,却因童年营养不良导致发育受限——但即便如此,仍是全书最聪明的角色。Claude Opus 5在他眼中就是这样的豆子:能力远超同类,却注定无法触及本可以达到的上限。
另一个观察来自NanoGPT跑分:Fable大幅领先,Opus紧随其后,而Kimi K3仅以极小差距落后于Opus。UP主提出了一个略带玩笑的猜想——它们像不像失散的孪生兄弟?如果Anthropic在架构改进方向上主动停止爬升,而开源模型继续沿着原轨迹前进并反超,那说明后者摸索到了西方实验室没有的东西;反之,若曲线形状长期高度一致,则另有解读空间。
作为模型的实战演示,UP主让Fable 5.2优化自己正在开发的一款2D橄榄球游戏。短时间内,模型加入了3D感的镜头运动、比赛精彩回放和计分高亮——这些内容此前完全不存在。他同时开了两个实例,一个负责底层引擎,一个负责视觉表现。
这会不会成为新常态
发布的配套动作是:Anthropic宣布向较高档位的订阅用户提供最多三次额度重置,具体次数视订阅时长而定。
真正值得关注的是趋势。过去各家实验室比的是谁能训练出最强模型、谁能霸榜;而这次,Anthropic展示的是另一种姿态——训练出更强的东西,然后决定不给你。UP主预测,未来发布的前沿模型大概率都会采用类似做法,问题只在于其他实验室会不会跟进,还是把全部都放出来。
如果这条线被行业普遍接受,那么衡量模型进步的方式本身都会改变:公开基准会逐渐失效,能力边界由厂商单方面划定,而用户能做的,只是猜测那道线背后还藏着多少东西。
相关推荐
Fable 5.2自我改进循环加速,Gemini 4 Carbon紧追
Anthropic Fable 5.2与Google Gemini 4 Carbon同期发布,远程劳动指数翻倍增长,自我改进循环加速,但基准缺陷与评估意识问题并存。
Meta FAIR发布e-means:k-means新替代,收敛快十倍
Meta FAIR 在 FAISS 1.16.0 中发布 e-means,作为 mini-batch k-means 的替代方案,达到同等损失所需 epoch 减少约一个数量级,GPU 加速 10 到 45 倍,且无需新增超参数。
AI写代码好用,但为何代码库越来越脆弱?
AI编程工具提升效率的同时,可能让代码库变得脆弱。本文基于开发者博客和Hacker News讨论,分析AI生成代码的隐性成本、社区分歧与降低风险的实践建议。