Claude Mythos 5.1 与 Fable 5.1 出现间歇性错误峰值

Anthropic 两模型间歇性错误峰值约 86 分钟闭环,未披露根因,凸显客户端容错必要性。
Anthropic 状态页记录了一次影响 Claude Mythos 5.1 与 Claude Fable 5.1 的间歇性错误峰值事件,从 09:48 UTC 标记 Investigating 到 11:14 UTC 转为 Resolved,历时约 86 分钟,未披露根因。两个模型同时报错,通常指向共享基础设施波动、上游依赖抖动或配置变更副作用等平台侧原因,而非单一模型逻辑问题。文章指出,间歇性错误呈尖刺状出现、难以稳定复现,排查难度高于持续故障,需依赖历史指标与采样日志还原现场。对开发者而言,应在调用层内置指数退避加抖动的重试策略、订阅状态页告警、区分模型错误与平台错误,并为关键链路准备多模型或多供应商的降级路径。
Anthropic 状态页面记录了一次针对 Claude Mythos 5.1 和 Claude Fable 5.1 的故障事件,两个模型在相近时间段内出现间歇性错误率上升。从发现问题到部署修复,整个过程不到两小时。
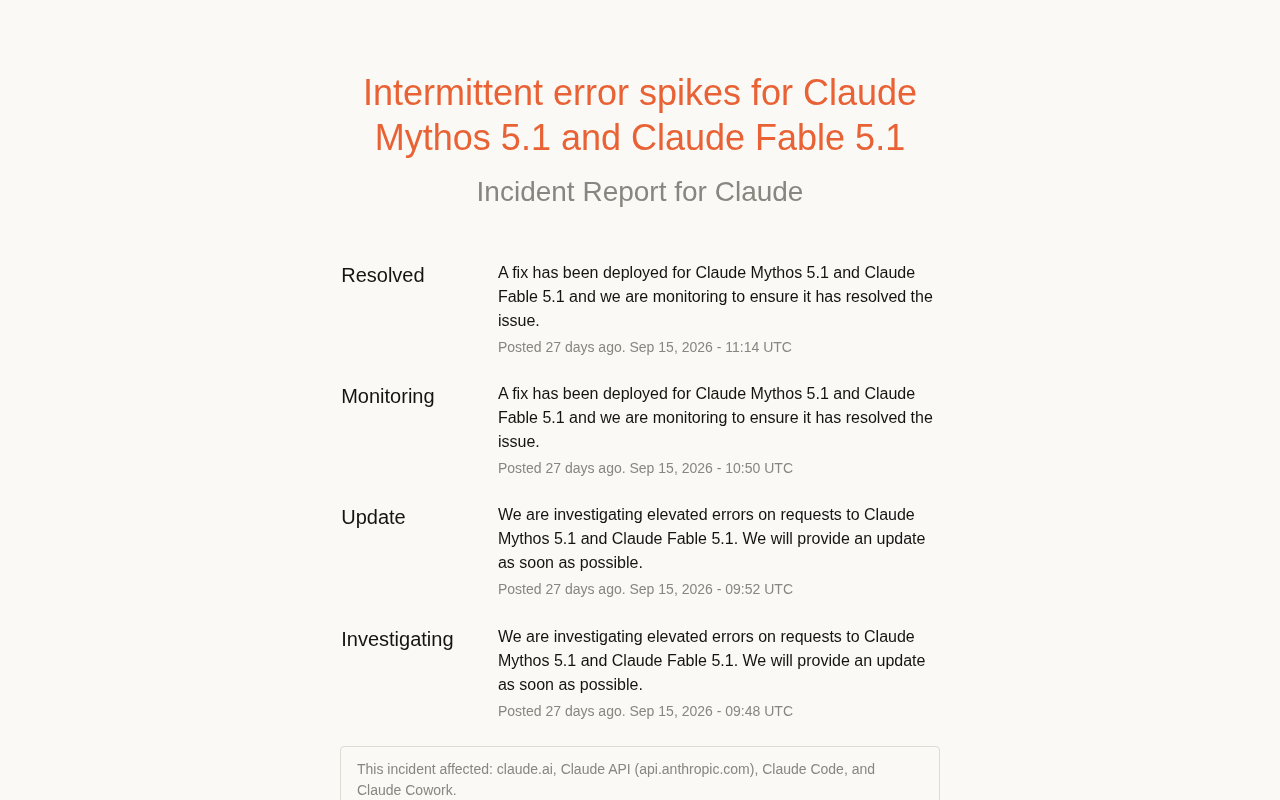
事件时间线还原
根据状态页披露的信息,事件经历了从 Investigating 到 Resolved 的完整流程:
- 09:48 UTC:Anthropic 首次标记为 Investigating,确认正在排查 Claude Mythos 5.1 和 Claude Fable 5.1 请求上的错误升高问题。
- 09:52 UTC:状态更新为 Update,内容与 Investigating 基本一致,说明当时尚未定位根因。
- 10:50 UTC:状态转为 Monitoring,修复方案已部署,团队正在观察效果。
- 11:14 UTC:状态标记为 Resolved,确认问题已解决。
从首次披露到宣布解决,前后约 86 分钟。对于一次影响两个线上模型服务的错误峰值事件来说,这个响应节奏属于比较紧凑的。
状态页的标准化流程:主流云厂商与 API 服务商普遍采用一套约定俗成的状态分级,常见的有 Investigating(已收到报告、正在核实与定位)、Identified(已确认根因)、Monitoring(修复已部署、观察指标是否稳定)、Resolved(确认恢复正常)。这套流程的价值在于把内部排查进度外化为可预期的信号,让外部调用方据此决定是否切换降级方案。需要注意的是,标记为 Monitoring 并不等于问题已彻底消失,而是修复动作已经落地、进入验证窗口;若观察期内指标再次恶化,状态可能回退到 Investigating。因此开发者在看到 Monitoring 时,仍应保持重试与降级逻辑生效,直到出现 Resolved。
同时影响两个模型意味着什么
值得关注的是,出问题的不是单一模型,而是 Claude Mythos 5.1 和 Claude Fable 5.1 两个模型同时报告错误升高。这通常指向几种可能:
共享基础设施层的问题。 多个模型同时异常,往往不是某个模型权重或推理逻辑单独出错,而更可能是它们共用的路由、调度、鉴权或限流组件出现了波动。
上游依赖的抖动。 如果两个模型依赖同一套推理集群或同一批算力资源,那么资源侧的瞬时压力也会同时反映在两个模型的错误率上。
发布或配置变更的副作用。 一次面向多模型的配置推送,也可能同时波及多个服务端点。
Anthropic 在状态页中没有披露根因,只说明"修复已部署"。从工程实践角度看,能在不到一小时内从 Investigating 推进到 Monitoring,说明团队对这类问题的定位路径已经比较成熟——要么有完善的监控告警能快速缩小范围,要么有可回滚的变更机制。
间歇性错误比持续故障更难处理
标题里"Intermittent error spikes"这个措辞值得单独拆解。间歇性(Intermittent)意味着错误不是稳定复现的,而是呈峰值状出现。
这类问题的排查难度明显高于持续故障。持续故障的复现路径清晰,日志里能直接看到大量一致的报错;而间歇性峰值往往在监控图上表现为短时尖刺,等到工程师介入时可能已经回落,需要依赖历史指标和采样日志来还原现场。
对于依赖 Claude API 构建应用的开发者来说,这类事件的实际影响也因使用模式而异:
- 同步调用的交互式应用:用户可能直接感知到偶发失败,需要重试逻辑兜底。
- 批量离线任务:更容易通过队列重试消化掉峰值,但需要控制重试节奏,避免在错误窗口内加剧上游压力。
- 对延迟敏感的场景:即使最终成功,重试带来的延迟抖动也会影响体验。
错误率指标的口径问题:监控系统通常按固定时间窗口(如每分钟)聚合请求成功率,间歇性峰值在粗粒度窗口下会被平均掉,看起来只是轻微抬升;只有切换到更细的窗口或分位数指标(如 p99 错误率、连续错误计数)才能捕捉到尖刺形态。此外,错误还可能集中在特定 region、特定 API 版本或特定请求规模上,形成“整体正常、局部异常”的假象。这也是为什么排查这类问题往往需要同时查看聚合指标、按维度下钻的分组指标,以及带请求 ID 的采样日志,三者互相印证才能还原出错误发生的真实条件。
对开发者的实际启示
这次事件本身已经闭环,但它提供了一个观察生产级 LLM 服务稳定性的样本。几个可以落地的做法:
把重试和退避写进调用层。 面对间歇性错误峰值,指数退避加抖动的重试策略比固定间隔重试更有效,能避免大量客户端在同一时刻集中重试。
订阅状态页并设置告警。 状态页的时间线是事后追溯的依据,但在事件进行中,能否第一时间获知直接影响故障期间的处置效率。把状态源接入自己的告警通道,比人工轮询更可靠。
区分"模型错误"和"平台错误"。 当多个模型同时报错时,优先怀疑平台侧而非 prompt 或参数问题,可以少走弯路。
为关键链路准备降级路径。 如果业务对可用性要求高,可以考虑在多个模型或多供应商之间做路由,把单点依赖的风险摊薄。
指数退避与抖动的实现要点:指数退避指每次重试将等待时间按倍数递增(如 1s、2s、4s、8s),避免在服务端尚未恢复时反复冲击;抖动(Jitter)则是在计算出的等待时间上叠加一个随机量,防止大量客户端因采用相同退避曲线而在同一时刻集中重试,形成新的流量脉冲。常见做法有“完全抖动”(在 0 到当前退避上限之间随机取值)与“等比例抖动”(在计算值附近按比例浮动)。同时应设置最大重试次数与总超时预算,并对重试做幂等处理,避免非幂等请求在重试时产生重复副作用。
小结
Claude Mythos 5.1 和 Fable 5.1 的这次间歇性错误峰值,从 Investigating 到 Resolved 历时约一个半小时,没有披露根因。事件本身不算严重,但它提醒了一件事:即便是头部厂商的模型服务,也会出现短时错误波动,客户端侧的容错设计不是可选项,而是必需品。
相关推荐

Workbuddy零基础入门:桌面AI智能体如何落地工作流
Workbuddy桌面AI智能体零基础教程解读:从安装、积分领取到文件管理与自动化工作流搭建,对比CodeX的适用场景与成本差异,帮助职场人完成从AI提问者到AI管理者的思维转变。

OpenAI智能体新栈:计算机操作、决策API与超速工作流
OpenAI Dev Day发布智能体新栈:Computer Use操作速度超越普通人,Decisions API基于Luna实现极低延迟分类,Agents API开放同源计算机操作能力,GPT-6.1 Sol成本仅为Astra七分之一。本文梳理核心更新、实测数据与开发者落地要点。

梁文峰开源推理框架DeepInfo,硬刚美国禁令
DeepSeek在开源模型后再开源推理框架DeepInfo,包含GPU/CPU交叉流水线、小模型预判大模型复核、华为昇腾与英伟达芯片全面适配等技术,直面美国联邦禁令。本文解析其对AI产业落地的意义与开源策略。