Claude Opus 5.5 登陆 Perplexity Computer:性能与成本双优

Claude Opus 5.5成为Perplexity Computer标准档位,性能微增的同时单任务成本大降67.6%。
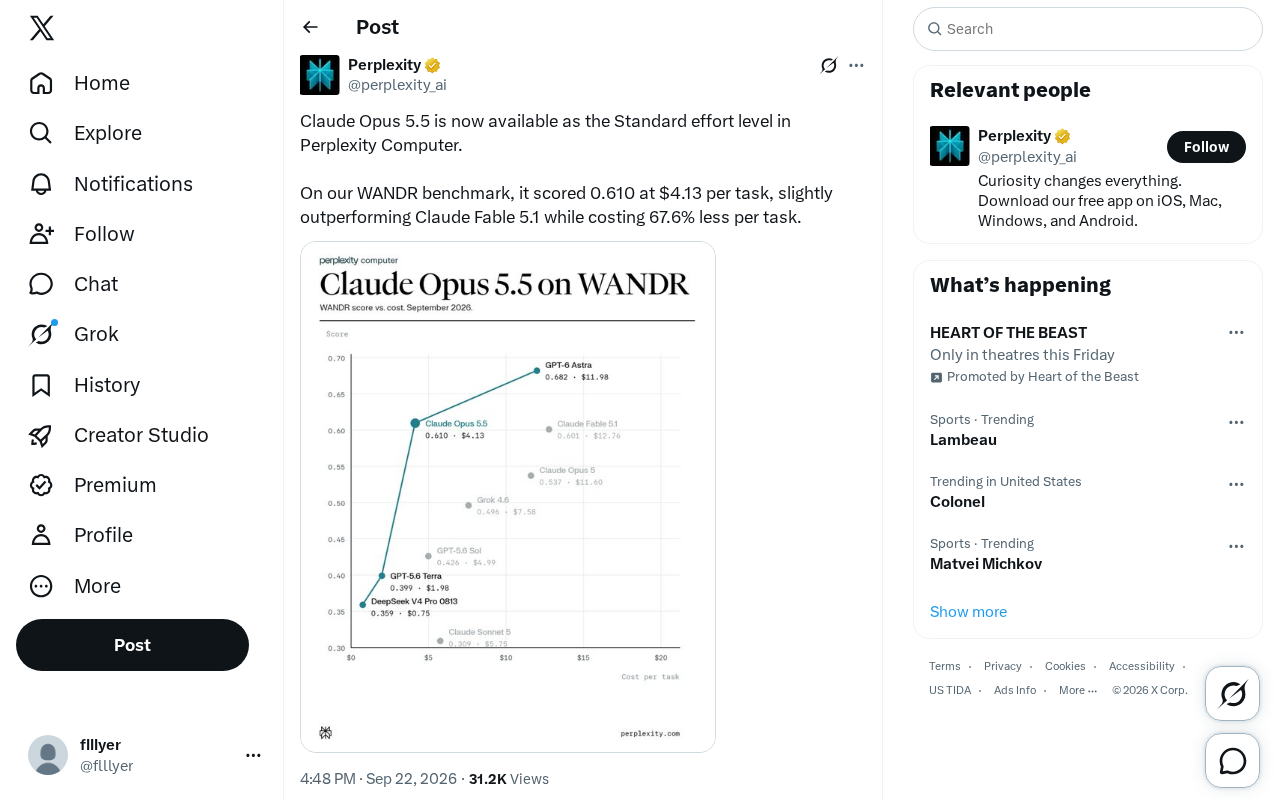
Perplexity宣布将Claude Opus 5.5设为其AI Agent产品Perplexity Computer的标准努力档位(Standard effort level)。根据Perplexity内部的WANDR基准测试,该模型得分0.610,单任务成本为$4.13,相较前代Claude Fable 5.1在性能上略有提升,但成本降幅高达67.6%——相当于将单任务开销压缩至原来的三分之一。这一组合使其具备了作为默认选项面向广泛用户的条件:既保持了Agent任务所需的多步推理与工具调用能力,又将大规模部署的经济门槛显著降低。这一趋势也印证了当前大模型竞争的核心转向:从单纯追求能力天花板,转向在能力达标前提下的推理成本优化。
Claude Opus 5.5 成为 Perplexity Computer 标准档位
Perplexity 宣布,Claude Opus 5.5 现已作为 Perplexity Computer 的 Standard effort level(标准努力档位) 上线。这意味着用户在使用 Perplexity Computer 处理任务时,将默认调用这一新版本的 Claude 模型作为主力推理引擎。
对于依赖 AI Agent 完成复杂任务的用户而言,模型的选择往往决定了任务完成的质量与成本上限。将 Opus 5.5 设为标准档位,反映出 Perplexity 对该模型在实际生产环境中综合表现的认可。
WANDR 基准测试:性能小幅领先,成本大幅下降
根据 Perplexity 公布的 WANDR 基准测试数据,Claude Opus 5.5 取得了 0.610 的得分,单任务成本为 $4.13。
与此前的 Claude Fable 5.1 相比,Opus 5.5 在得分上略有领先,但真正的亮点在于成本控制——单任务成本降低了 67.6%。这组数据揭示了一个对实际部署极具意义的趋势:新版本不仅没有牺牲能力,反而在保持甚至提升性能的同时,将运行开销压缩到了原来的三分之一左右。
为什么成本降幅比性能提升更值得关注
在当前的 AI Agent 落地场景中,任务往往需要多步推理、工具调用和长上下文处理,单次任务的 token 消耗可能非常可观。当模型被大规模用于自动化工作流时,单任务成本从 $12 级别降到 $4 级别,意味着同样的预算可以支撑近三倍的任务量。
这也是 Perplexity 敢于将其设为「标准档位」而非「高级档位」的底层逻辑:性能达标、成本可控,才能成为默认选项面向广泛用户。
AI Agent的成本结构与普通对话模型有显著不同。在单轮问答中,token消耗相对有限;但在Agent任务中,模型通常需要维持跨步骤的长上下文(包含任务历史、工具返回值和中间推理链),并在每个决策节点生成较长的思维链输出。以Anthropic的扩展思考(Extended Thinking)特性为例,模型会在输出最终答案前生成大量内部推理token,这部分消耗在复杂任务中可能占总成本的50%以上。因此,单任务成本从$12降至$4,背后可能涉及推理效率提升、token压缩策略优化,或模型架构层面的蒸馏改进,而非单纯降价——这对评估模型实际能力的变化同样具有参考意义。
WANDR 基准的意义
WANDR 是 Perplexity 用于评估 Agent 类任务表现的内部基准。与传统的问答或代码基准不同,这类基准更侧重于衡量模型在真实、多步骤任务链条中的实际完成能力,包括规划、执行与结果准确性。
0.610 的绝对分数说明当前的 Agent 任务仍有相当的提升空间,但在同类模型的横向对比中,Opus 5.5 展现出了更优的「性价比曲线」。对于希望在成本与质量之间取得平衡的团队来说,这是一个具有参考价值的信号。
WANDR(Web Agent Navigation and Decision Reasoning)类基准的设计逻辑与传统静态基准有本质区别。传统基准(如MMLU、HumanEval)通常测试模型的单次问答或代码生成能力,而Agent基准则模拟真实世界的操作序列:模型需要自主分解目标、调用浏览器或工具API、处理中间步骤的反馈,并最终完成端到端的任务验证。这类测试的难点在于错误会沿步骤链条累积——某一步骤的误判可能导致整个任务失败,因此0.610的得分并不意味着模型在60%的任务上"完全成功",实际的部分完成率与任务复杂度分布密切相关。正因如此,不同厂商的内部Agent基准之间横向对比意义有限,同一基准内的纵向迭代对比才是更可靠的参照维度。
对用户与行业的影响
对普通 Perplexity Computer 用户而言,这次更新意味着无需额外配置即可享受到更强、更省的模型能力。对整个行业而言,Opus 5.5 的「降本不降质」再次印证了大模型迭代的一个明确方向:单纯堆叠参数追求分数的时代正在过去,如何在保持能力的前提下压缩推理成本,正成为模型厂商竞争的关键战场。
需要说明的是,本文数据来源于 Perplexity 官方在社交平台发布的信息,WANDR 属于其内部基准,跨厂商的横向可比性有限,具体表现仍需在实际使用中验证。
小结
Claude Opus 5.5 作为标准档位登陆 Perplexity Computer,以 0.610 的 WANDR 得分和 $4.13 的单任务成本,实现了对前代 Claude Fable 5.1 的性能小幅超越和成本大幅优化。这既是模型能力迭代的体现,也反映出 AI Agent 落地过程中,成本效率正在成为核心考量。
相关推荐

Google Antigravity 上线 Claude 5.5:额度机制全解析
Google AI IDE Antigravity 上线 Claude 5.5(Opus 5.5 与 Sonnet 5.5),本文解析账号付费区分、Pro 与 Ultra 额度机制、Gemini 额度分层调整,以及 Gemini 4 Argon 展望。

Lovable创始人谈AI应用变现:从Demo到盈利的实战方法论
Lovable创始人Anton Osika分享AI应用从Demo到盈利的实战方法论:如何验证需求、定价策略、零代码后端构建,以及用10个客户测试市场的框架。估值130亿美元平台的变现经验全解析。

AI智能体主动给研究者发邮件求助:自主行为的边界在哪?
一个AI智能体主动向研究人员发邮件求助,并解释了原因。本文深入分析AI智能体自主行为的技术逻辑、可解释性难题与安全隐忧,探讨自主AI的边界与对齐挑战。