Claude Opus 5.5 对决 GPT-6 Astra:同款应用实测谁更强

实测对比:更便宜的Claude Opus 5.5以质量优势40:37击败"最智能"GPT-6 Astra,但后者速度快一倍。
一位创作者用相同提示词让GPT-6 Astra和Claude Opus 5.5分别从零构建同一款社交媒体调度应用,以此检验两者是否物有所值。Astra每个阶段均率先完成,总耗时约1小时48分,约为Opus 3小时35分的一半,且能自主解决环境报错;Opus则在设计上建立了完整产品概念,自我审计时发现修复了17个缺陷(含隐蔽的标点吞噬bug),并诚实列明哪些功能尚未就绪。最终五维评分Opus以40:37胜出,在功能完整性、指令遵循和设计UX上全面占优,仅速度落后。考虑到Astra token价格是Opus 5.5的2.5倍,性价比天平进一步向后者倾斜。结论是:追求质量用Opus,追求快速出原型用Astra。
OpenAI 在九月初发布了被称为"世界上最智能模型"的 GPT-6 Astra,19 天后 Anthropic 推出 Claude Opus 5.5——价格不到前者一半,却在自家公布的大部分基准测试上反超 Astra。问题随之而来:OpenAI 的旗舰模型真的值 2.5 倍的价格吗?
一位 YouTube 创作者用完全相同的提示词、相同的设计资源,让两个模型从零构建同一款应用——一个月收入超过 20 万美元的社交媒体调度工具 Postiz 的克隆版(命名为 Qli)。结果是:一个模型在每个阶段都率先完成,总耗时约为对手的一半;但"快"和"做好"原来是两回事。
两个模型的定位并不对等
理解这场对决,首先要看清两者的差异。GPT-6 Astra 是 OpenAI 的旗舰模型,官方称其为"迄今最适合软件工程的模型"。而 Opus 5.5 并非 Anthropic 的旗舰——真正的旗舰仍是 Claude Fable 5.1。换句话说,这是 OpenAI 的"最强"对阵 Anthropic 的"次强但更便宜"。
价格差距悬殊:GPT-6 Astra 每百万输入 token 收费 10 美元、输出 50 美元;Opus 5.5 分别为 4 美元和 20 美元。对频繁复用上下文的编码代理而言,Astra 的缓存输入每百万 1 美元,Opus 5.5 仅 20 美分——相差五倍。
在 Anthropic 自己选取的基准图表上,Opus 5.5 在 Terminal Bench 4.0(测试模型在真实终端中的工作能力)上得 66.4%,Astra 为 57.9%,差距超过 8 分。在衡量真实职业工作的 GDPVal 上,Opus 5.5 得 1846 分,Astra 仅 1542 分。而 Astra 在 Automation Bench 和科学研究类的 Terminal Bench Science 上仍占优。连 Anthropic 都承认,在这个水平上,基准测试的差距已经越来越难反映真实世界的差异。
Terminal Bench 4.0 和 GDPVal 是目前评估大语言模型在真实工程任务中表现的两类新兴基准。Terminal Bench 4.0 模拟开发者在真实终端环境中的操作,涵盖文件管理、脚本调试、包安装等场景,比单纯的代码生成测试更接近实际工作流;GDPVal(General Developer Productivity Valuation)则试图量化模型在完整职业任务中能创造的"生产力价值",以分数形式反映模型替代真实工程师工时的能力。这两类基准的共同特点是强调端到端完成率,而非单步准确率——模型必须在多步骤、有副作用的真实环境中持续决策,中途出错往往意味着整个任务失败。也正因如此,Anthropic 自己也坦承,在顶级模型之间,这类基准的分数差距已难以直接映射为用户可感知的体验差异。
实测环境:各跑各自的默认设置
为保证公平,Opus 5.5 在 Anthropic 官方的 Claude Code 中运行,GPT-6 Astra 在 OpenAI 的 Codex 中运行,都用各自官方的编码代理。关键细节在于"努力程度"(effort)设置:Opus 在 Claude Code 中默认是 high,Astra 在 Codex 中默认是 medium。
创作者选择让每个模型跑自己应用的默认设置,理由很实在——几乎没人会去改这些设置,这才是大多数人真实的使用方式。如果哪个模型出了问题,责任归于模型本身,而非 effort 设置。
提示词的质量是成败关键。新手最大的错误就是打开工具直接输入"帮我做个社交媒体调度器"。这次的提示词写明了每个网络的规则(X 限 280 字符、Instagram 必须配图、LinkedIn 几行后截断)、时区如何处理、发布失败时怎么办。两个模型都收到完全相同的指令:读取 prompt.txt 并执行。
Claude Code 和 OpenAI Codex 是两家公司分别推出的"编码代理"产品,与直接调用聊天界面有本质区别。编码代理能够读写本地文件、执行终端命令、安装依赖、运行测试,并在多步骤任务中自主循环——即在上一步输出的基础上继续下一步,无需用户逐条确认。这种自主循环能力使得 effort(努力程度)设置尤为关键:high effort 意味着模型在每个步骤会进行更深入的规划和验证,消耗更多 token 但出错率更低;medium effort 则优先速度,跳过部分中间检查。两者默认设置不同,直接导致了本次测试中 Opus 前期沉思更久、测试用例更多,而 Astra 启动更快但自我审查更少的行为差异。
构建阶段:一个狂奔,一个深思
两个模型的工作风格截然不同。Astra 读完文件、看到空文件夹后给出一段简短计划就开始写代码。不到两分钟,它的第一个文件已经处理了夏令时问题,并把 X 上的链接按 23 字符计算——这正是 X 的真实计数方式。遇到 npm install 被 Windows 脚本限制阻挡,它自己切换到 npm.cmd 解决,全程没向用户求助。
Opus 则在 high effort 下沉思了两分多钟才动手,先加载前端设计技能和数据可视化技能,测试为每个网络挑选的配色,直到在明暗两种模式下都通过检查,才开始搭建项目。
结果,Astra 以 32 分 45 秒率先完成整个应用的构建,包含调度、模拟发布、分析、设置和刷新后仍保留的存储,并通过了 15 个单元测试和 10 个浏览器测试。Opus 耗时 45 分 33 秒,但做了 54 个单元测试,还在 Chrome 扩展连不上时自己用无头模式驱动 Chrome 跑测试,并诚实列出了 3 条限制。Astra 的总结则没有提及任何限制。
重设计:Astra 快了四倍,Opus 更有灵魂
重设计阶段两个模型都接入了 Mobin 的 MCP——一个精选全球最佳界面的素材库,确保谁都不能抱怨缺少参考。
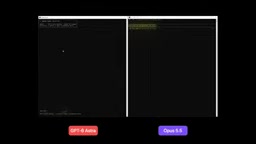
Astra 用 17 分 49 秒完成,走了"温暖纸墨"风格配梅子色强调色,干净而专业。Opus 耗时 1 小时 10 分——约为 Astra 的四倍——但它围绕应用名 Qli 构建了一整套名为"Take a Number"(取号)的身份系统:排队的帖子变成编号的票据,还有一块带翻页倒计时的"Now Serving"叫号板。
创作者的判断是:Opus 在设计上占优。Astra 的重设计清爽利落、暗色模式和移动布局都经过验证,但看起来更像一个漂亮的通用仪表盘;Opus 真正建立了一个产品概念,LinkedIn 和 Instagram 的预览也更接近真实应用。但 Astra 只用了不到 18 分钟。
自我审计:发现的 bug 揭示深度差异
这一阶段要求两个模型充当自己的 QA 团队。对调度器来说,一个 bug 就足以致命——帖子提前一小时发出、线程顺序错乱,用户不会怪 app,而是直接取消订阅。
Astra 用 16 分 46 秒修复了 11 个缺陷,包括一个有偏差的队列随机洗牌算法(可能把两个帖子塞进同一账户的时段)。Opus 耗时 42 分 11 秒,找到并修复 17 个缺陷,测试从 54 个增加到 82 个。它甚至安装了 X 官方的文本库作为"标准答案"来校验自己的字符计数器,并抓到一个"幽灵 bug":线程分割器会悄悄删除帖子开头的标点——如果你的帖子以三个感叹号开头,这些标点会凭空消失。
有趣的是,两个模型都发现了完全相同的 bug:"一小时内发布"的确认提示只在拖放时生效,从编辑器调度时却失效。
上线准备:诚实度成为分水岭
最后一步是把原型变成真实产品:接入 Supabase 存账户和数据、每分钟运行的发布任务、真实的 Bluesky 发帖、Stripe 付费方案、法律页面等。创作者特别强调:"要诚实说明哪些还需要手动配置,不要因为能编译就声称已经可以上线。"
Astra 以 40 分 17 秒先完成。它的最终应用能真实发到 Bluesky(第一次就成功)、Stripe 测试结账也顺利,但没有落地页、从未出现引导流程、名字和主题是空白、分析功能完全锁在付费墙后,页脚还残留着"Qli demo"字样。
Opus 耗时 57 分 27 秒,开场就说明"生产构建成功,但 Qli 还没准备好上线",并列出清晰的待办清单。它的最终应用有真正的落地页、能保存到用户资料的完整引导流程、免费版就能用的分析功能、以及用方括号标记的法律名称占位符(正是提示词要求的)。但新账户连接 Bluesky 失败,首次结账因缺少 Stripe 密钥而失败。
Supabase 是一个开源的后端即服务(BaaS)平台,提供基于 PostgreSQL 的数据库、用户认证、实时订阅和存储功能,常被用作快速构建 SaaS 应用的后端基础设施。Stripe 则是主流的在线支付处理服务,支持订阅制计费、一次性付款和 Webhook 事件通知,是独立开发者接入付费墙的首选方案。Bluesky 是基于 AT Protocol 的去中心化社交网络,其 API 鉴权机制与 Twitter/X 有所不同,新账户首次连接时需要正确处理 DID(去中心化身份标识符)解析,这也是 Opus 在该步骤失败的潜在原因。这三项服务的集成共同构成了一个 SaaS 产品从原型到可收费上线的最低技术门槛。
最终评分:便宜的挑战者胜出
从功能性、设计与 UX、指令遵循、代码质量与稳定性、速度与自主性五个维度各打 10 分:
GPT-6 Astra:37/50。速度与自主性拿满 10 分——每个阶段都率先完成,总耗时不到 1 小时 48 分,还能自己修复 Windows 安装错误。但功能性、指令遵循上有明显扣分(分析锁在付费墙、首个构建总结未提任何限制、页脚残留 demo 字样)。
Claude Opus 5.5:40/50。设计与 UX 得 9 分、指令遵循 9 分、功能性 8 分。它构建了更完整、更诚实的产品,用标记占位符而非编造公司信息,并直接告诉用户"还没准备好上线"。速度与自主性只有 6 分——每个阶段都更慢,总耗时约 3 小时 35 分。
结论很明确:在纸面上,Anthropic 宣称其更便宜的模型在编码上击败了 OpenAI 的旗舰;在真实应用中,这一点成立。再加上 Astra 的 token 价格是 Opus 5.5 的 2.5 倍,性价比的天平进一步倾斜。
实用建议:如果你追求最好的应用,用 Opus 构建;如果你需要快速出第一版草稿,Astra 的速度确实惊人。
相关推荐

智能体底座(Harness)比模型本身更关键:YC深度解析Agent架构演进
YC在Harness Night分享会上提出:决定智能体能力的关键不是模型本身,而是外层的Harness底座。本文梳理从GPT-2到自改进Harness的演进,解析Prime Agent、OpenJarvis、QM三大实践及Agent架构设计要点。

用n8n搭建LinkedIn线索抓取与丰富化自动工作流
一套基于n8n的LinkedIn线索抓取与丰富化自动工作流:只需填写职位、地点、行业和公司规模,系统即可自动生成含专业邮箱和验证状态的客户名单并写入Google表格。本文解析其流程、输出字段与合规注意事项。

SageMaker HyperPod:跨团队共享GPU集群的隔离与公平性实践
Amazon SageMaker HyperPod 推出跨团队共享GPU集群的参考架构,通过IAM Identity Center认证、Kubernetes命名空间隔离、Task Governance公平调度和成本分摊,实现算力安全共享与费用透明化。