Claude Opus 5.5对决GPT-6:AI模型价格战全面开打

Anthropic与OpenAI同日大幅降价,AI模型价格战进入中端档位白热化阶段。
同一天内,Anthropic发布Claude Opus 5.5、OpenAI发布GPT-6 Sol与Luna,叠加前一天的Grok 4.7,大模型市场爆发密集价格战。GPT-6 Luna定价低至0.10/0.50美元每百万token,约为上一代Luna的一半;Opus 5.5降价20%至4/20美元,缓存读取成本更大降60%,对长时agentic工作流尤为利好。此轮价格战主要集中在中端及以下档位,高端旗舰暂未卷入。开发者Simon Willison的实测还发现,Opus 5.5在最高思考强度下会过度推理,撞上128K输出上限导致简单SVG任务失败,揭示了推理模型"思考预算"管理的实际风险。随着Haiku 5.5等低端型号即将推出,价格竞争将进一步向底部延伸。
同一天内,Anthropic与OpenAI相继发布重磅新模型——Anthropic推出Claude Opus 5.5,仅一小时后OpenAI就抛出GPT-6 Sol和GPT-6 Luna。加上前一天登场的Grok 4.7和小米MiMo v2.6,整个大模型市场在极短时间内进入了新一轮激烈竞争。而这轮竞争最鲜明的主题,是价格。
开发者Simon Willison第一时间对这批新模型进行了实测,从定价结构到实际推理表现给出了细致观察。下面结合他的分析,梳理这场价格战的关键看点。
GPT-6 Luna与Sol:价格直接砍半
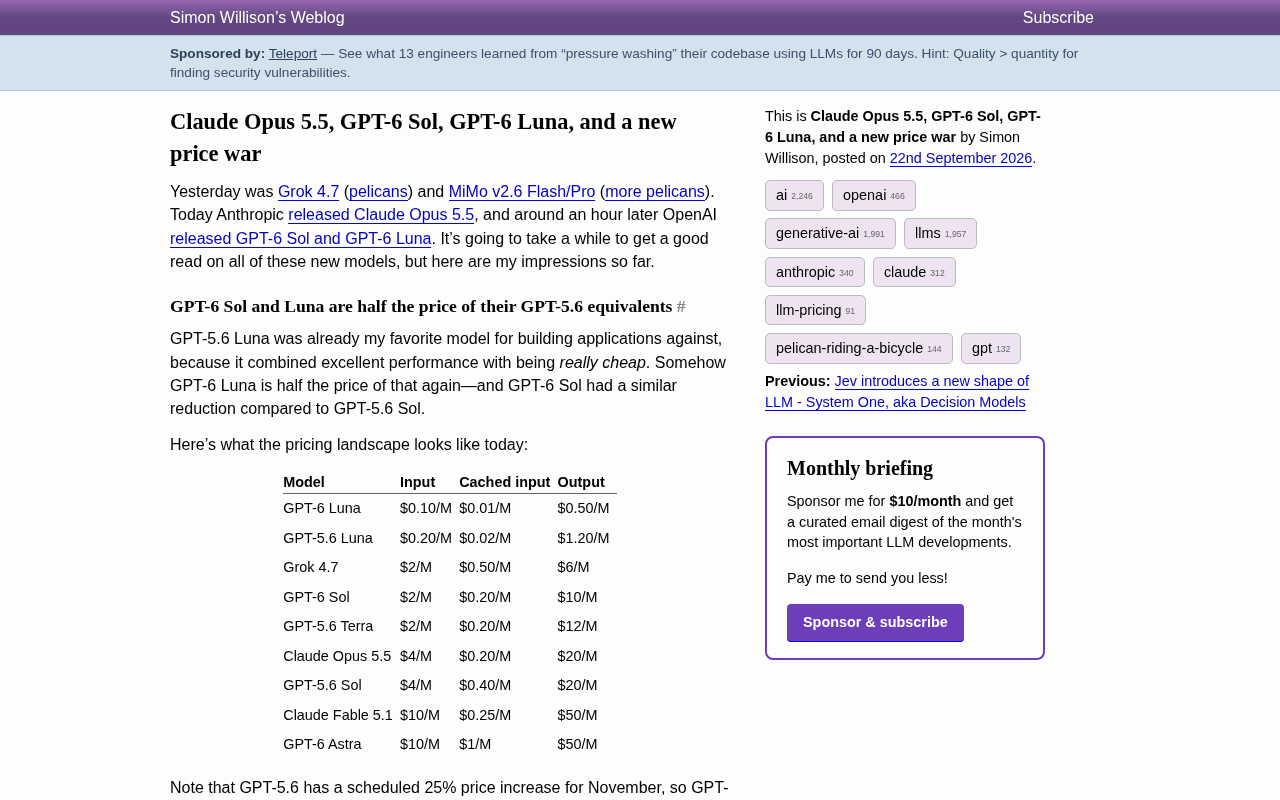
GPT-6家族最引人注目的不是能力跃升,而是价格的大幅跳水。GPT-6 Luna的定价来到每百万token输入0.10美元、缓存输入0.01美元、输出0.50美元——恰好是GPT-5.6 Luna(0.20/0.02/1.20美元)的一半。GPT-6 Sol相较GPT-5.6 Sol也有类似幅度的下调。
更值得关注的是,GPT-5.6原本计划在11月执行25%的涨价,这意味着GPT-6实际上是以GPT-5.6促销价的一半推向市场。Willison指出,0.10/0.50美元的GPT-6 Luna是OpenAI历史上最便宜的模型之一,只有能力弱得多的GPT-4.1 Nano和GPT-5 Nano价格更低。
这种定价直接改变了竞争格局。前一天Grok 4.7以2/6美元的价格试图抢占中端市场,比GPT-5.6 Sol便宜过半;但GPT-6 Sol跟进后,两者在输入端已经持平,输出端也大幅缩小差距。同时,GPT-5.6 Terra与GPT-6 Sol同价,让继续使用Terra的理由彻底消失。
Claude Opus 5.5同步降价,缓存成本大降
面对OpenAI的攻势,Anthropic的Opus 5.5也带来了降价。此前从Opus 4.5一路到Opus 5,价格都固定在输入5美元、输出25美元每百万token;5.5则下调20%至4美元和20美元。
更实质性的变化在缓存读取——价格下降了60%。对于长时间运行的agentic对话场景,这一点尤为关键,因为在这类场景下90%以上的输入token都是按缓存价格计费的。缓存成本的大幅下降,直接降低了长上下文、多轮工具调用应用的运行成本。
除了价格,Opus 5.5据称也针对用户长期抱怨的沟通风格问题做了改进。Anthropic的Thariq Shihipar表示,Opus 5.5表达更清晰,每token成本低于Opus 5.0,却拥有接近Fable 5.1的智能水平,并且在各个思考强度下都表现出很高的token效率。团队还称其在Blender等3D任务上有所提升。
不过需要注意的是,Opus 5.5降价后的价格恰好等于GPT-5.6 Sol,而OpenAI随即把Sol价格砍了一半。这场价格战目前主要集中在中高端下方的这一档位;更高端的GPT-6 Astra与Claude Fable 5.1仍维持在10/50美元,暂未卷入。
提示缓存(Prompt Caching)是大模型API中一项重要的成本优化机制:当同一段前缀文本(如系统提示、长文档、工具定义)在多次请求中重复出现时,服务商可以将其KV缓存状态保存在内存中,后续请求直接读取缓存而无需重新计算,因此按显著低于正常输入的"缓存读取价格"计费。在agentic工作流中,智能体通常需要在一次任务内发起数十乃至数百次工具调用,每次请求都携带相同的系统提示和累积的对话历史,缓存命中率极高。以Opus 5.5为例,缓存读取价格下降60%意味着一个运行一小时、持续调用工具的智能体,其实际API费用可能比表面定价低80%以上,这对判断agentic应用的经济可行性至关重要。
Opus 5.5的"max"模式:想太多反而崩了
价格之外,Willison也用他标志性的"生成一只骑自行车的鹈鹕SVG"测试考验了新模型。结果Claude Opus 5.5在"max"最高思考强度下出现了前所未有的失败——它根本没能返回结果。
模型把这个请求称为"经典测试题",然后开始极其冗长地推理:核对鹈鹕小腿长度约95.2像素、规划从髋到膝再到踝的近腿路径、确认鱼从篮子里探出的细节、检查链轮齿数和图层顺序……在这个过程中,它撞上了128,000 token的最大输出上限,还没画完SVG就被截断了。Willison重试一次得到相同结果,两次失败各花费2.56美元、耗时近20分钟。
这让他对"max"模式的实用性产生怀疑:如果在一个如此简单的SVG提示上都能过度思考到崩溃,那在更复杂的实际工作中也难以让人放心。相比之下,Fable 5.1在"max"下没有陷入过度推理,反而给出了他见过的Anthropic模型中最好的鹈鹕作品。
他也注意到不同代际模型在风格上的差异:GPT-5.6家族倾向于更大胆鲜艳的配色,而GPT-6家族则明显更加沉稳素净。虽然用画鹈鹕来横向比较不同厂商未必有太大意义,但在同一模型家族内部对比不同推理强度时,这种测试仍具参考价值。
现代推理模型(Reasoning Model)通常允许用户调节"思考预算"或"思考强度",即模型在给出最终答案前被允许消耗在内部推理链(Chain-of-Thought)上的token数量上限。强度越高,模型可以进行更深入的逐步推理,理论上在数学证明、代码调试等复杂任务上表现更好;但代价是延迟更长、费用更高,且存在"过度思考"风险——模型陷入冗长的自我验证循环,反而无法在输出限制内完成实际内容生成。Opus 5.5在"max"模式下撞上128K输出上限的案例,正是这一权衡失控的典型表现:推理token将输出窗口几乎耗尽,留给实际SVG代码的空间所剩无几。这提示开发者在实际部署中需要根据任务复杂度审慎选择思考强度,而非默认使用最高档。
价格战之下的实际选择
经过实测,Willison已把GPT-6 Sol和Claude Opus 5.5设为Codex与Claude Code中的默认模型,并将Datasette Agent演示升级到GPT-6 Luna——后者在SQL查询以及生成HTML、JavaScript方面表现得既快又靠谱。
接下来的看点在Anthropic的下一步。该公司表示Sonnet 5.5和Haiku 5.5即将推出。低端市场的压力尤其明显:现款Haiku 4.5定价1/5美元,而最新的GPT-6 Luna价格只有它的十分之一(0.10/0.50美元)。Haiku能否在低端重新夺回价格竞争力,将是这轮价格战下一个关键悬念。
对开发者而言,这轮密集的降价意味着构建AI应用的边际成本正在快速下降。模型能力的差距在收窄,而价格与token效率、缓存策略正成为选型时越来越重要的考量。
Token效率(Token Efficiency)是指模型在完成同等质量任务时所消耗的token总量,与单价共同决定实际成本。一个定价更高但token效率显著更好的模型,综合成本未必更贵。Anthropic对Opus 5.5的描述中特别强调了"每token成本低于Opus 5.0",意指在相同任务上5.5消耗的token更少,叠加定价下调后实际账单降幅超过标价差距。对开发者而言,评估模型性价比时应同时考量:单价、平均响应token数、缓存命中率以及任务完成质量,四者共同构成真实的运营成本模型,而非仅看API标价。
相关推荐

Opus 5.5实测:一个Skill把PDF变成交互式动画电子书
开发者基于 Claude Opus 5.5 打造开源 Skill「Papermorph」,通过 PDF→规划→分镜→旁白→动画测验的流水线,把静态 PDF 自动转化为带交互测验的动画网页电子书,且暂未使用图像模型。本文拆解其工作流与技术亮点。

Perplexity押注垂直整合:Vera芯片替代x86背后的Agent基建野心
Perplexity宣布垂直整合其智能体基础设施,自建沙箱并押注Vera架构替代x86,开始部署Perplexity Computer。本文解析这一战略背后的技术逻辑与行业意义。

Extra Big Ass Intelligence:一场对AI炒作的幽默反讽
Extra Big Ass Intelligence是一个在Hacker News走红的恶搞项目,用幽默反讽调侃AI行业的过度炒作与命名通胀,引发技术社区对AI营销泡沫的集体反思。