Claude Opus 5.5写Blender脚本:3次失败后我总结的逼真渲染工作流
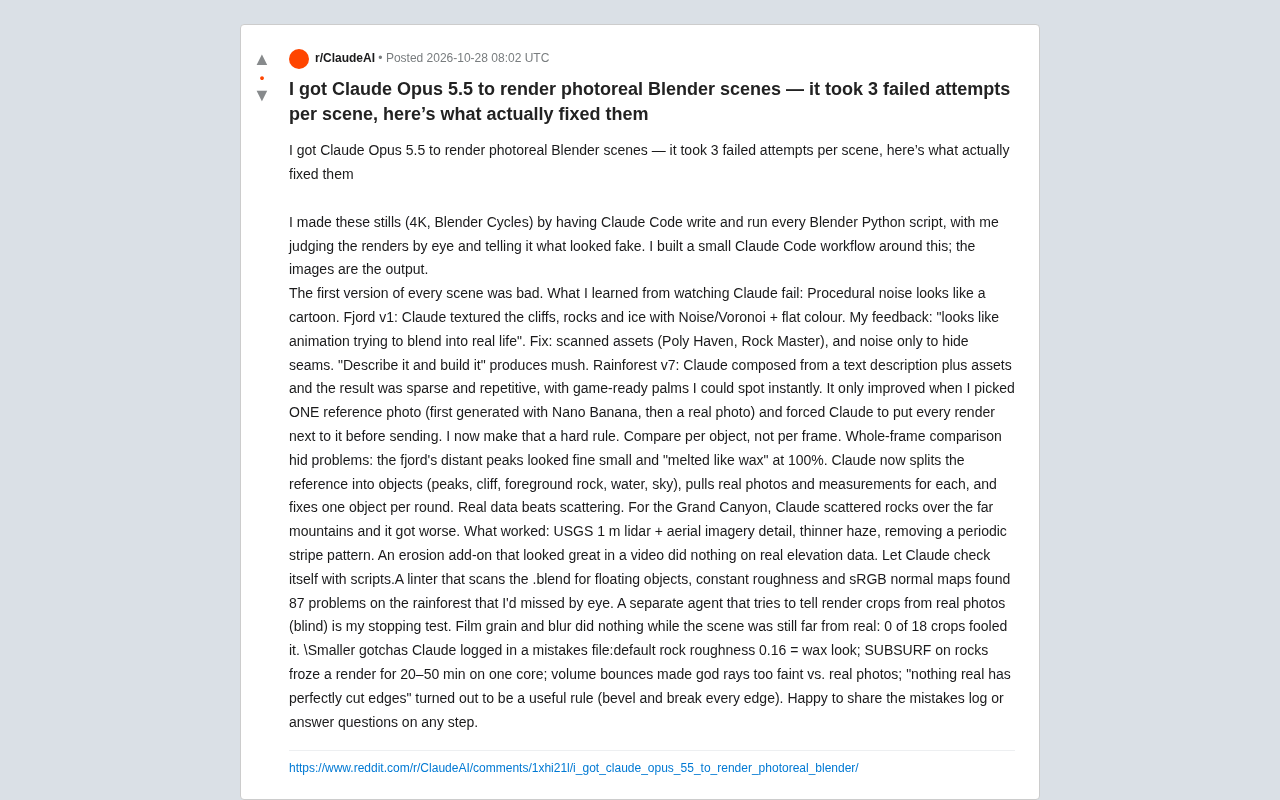
AI辅助Blender渲染需闭环工作流:生成—比对—定向修复,而非一次性生成。
文章通过Reddit创作者的实践,总结了用Claude Code生成照片级Blender场景的经验。核心教训是:程序化噪声纹理会导致卡通感,应使用扫描资产;仅凭文字描述构建场景必然贫瘠,需引入参考图并强制比对;整帧对比会掩盖局部缺陷,应将参考图拆解为独立对象逐一修复;真实测量数据(如USGS lidar)比复杂算法更有效。此外,作者构建了linter脚本和盲测agent实现自动化质检,并发现后期效果无法弥补几何与材质的根本缺陷。最终形成“生成—比对—定向修复”的闭环,人类判断问题,AI执行修复,脚本兜底检查。
用AI写Blender Python脚本渲染照片级场景,听起来是个一步到位的方案。但Reddit上一位创作者的实际经历给出了更真实的答案:每个场景的前三版几乎都是灾难。他把Claude Code生成的4K Cycles静帧反复推翻、修复,最终摸索出一套让AI「学会看」的工作流。这些踩坑记录比任何教程都更有参考价值。
失败的共同点:程序化纹理和「描述即生成」
程序化噪声一眼就是卡通
峡湾场景的第一版里,Claude用Noise和Voronoi节点配合纯色给悬崖、岩石和冰面做纹理。作者的反馈很直接——「像动画片试图混进真实影像」。换成扫描资产(Poly Haven、Rock Master)之后,噪声只用来遮盖接缝,画面立刻从插画质感转向实拍质感。这条经验可以推广到所有AI辅助建模场景:程序化噪声擅长补充细节,不擅长从零构建真实感。
程序化噪声纹理(如Blender中的Noise、Voronoi节点)通过数学函数生成随机图案,其优势在于无限分辨率和无缝平铺。然而,自然界的岩石、冰面等表面是由地质过程长期作用形成的,具有多尺度细节和方向性特征。程序化噪声缺乏这种结构化信息,常表现为均匀、重复的统计特性,导致视觉上呈现“卡通感”。相比之下,扫描资产(如Poly Haven的PBR材质)通过摄影测量捕捉真实表面的反照率、法线、粗糙度贴图,保留了微观几何和光照响应细节,因此能快速提升真实感。在AI生成场景中,程序化纹理更适合作为补充层,用于遮盖接缝或增加微观变化,而非从零构建基础材质。
只用文字描述构建场景必然贫瘠
雨林场景到第7版才勉强可用。前几版中,Claude依据文本描述拼装资产,结果稀疏、重复,棕榈树一眼就能看出是游戏素材。转折点在于作者只挑了一张参考照片(先用Nano Banana生成,再换成真实照片),并要求Claude每次输出渲染前必须与参考图并排比对。他认为这是整个流程里唯一真正改变结果的动作,后来把它定为硬性规则。
比对粒度决定修复效率
整帧对比会掩盖局部缺陷
峡湾的远景山峰在缩略图里看着没问题,放大到100%却「像蜡一样融化」。原因在于整帧对比时,单帧的局部错误被整体构图稀释了。作者改成把参考图拆解成独立对象——山峰、悬崖、前景岩石、水面、天空——每个对象单独找真实照片和测量数据,一轮只修一个对象。修复速度反而比整帧反复调整快得多。
整帧对比时,人眼容易受整体构图和光影影响,忽略局部异常。例如,远景山峰在缩略图中可能被整体色调掩盖,但放大后细节错误(如蜡质感)便暴露无遗。将参考图拆解为独立对象(山峰、悬崖、水面等)进行单独比对,能迫使注意力集中在每个区域的几何、材质和光照一致性上。同时,为每个对象寻找真实照片和测量数据(如高程、纹理尺度),可以提供客观的修复依据,避免凭感觉调整。这种“分而治之”的策略不仅提高修复精度,还能减少反复试错的时间,因为每次修改都针对明确的问题。
真实数据比堆量有效
大峡谷场景中,Claude在远山上撒了大量碎石,画面反而更糟。真正见效的是接入USGS的1米精度lidar与航拍影像细节、减薄雾气、清除周期性条纹。值得一提的是,某个在演示视频里效果惊艳的侵蚀算法插件,套用到真实高程数据上几乎毫无作用。这提示了一个反直觉的结论:AI生成内容在「拟合真实」时,数据精度比算法复杂度更关键。
USGS的1米精度lidar数据提供了地表的高程和形态信息,可用于驱动地形网格和置换,确保宏观地貌的真实性。航拍影像则提供颜色和纹理细节,辅助材质制作。相比之下,程序化算法(如侵蚀模拟)若缺乏真实数据约束,容易产生不自然的图案。这是因为AI生成内容在拟合真实世界时,依赖于输入数据的质量和分辨率。高精度数据能直接提供正确的几何和纹理统计特征,而复杂算法可能引入伪影或过度简化。因此,在资源有限时,优先获取真实测量数据比优化算法更能有效提升场景的真实感。
让Claude自己检查自己
作者构建了两个自动化质检环节。第一个是linter脚本,扫描.blend文件中的漂浮物体、恒定粗糙度值、sRGB法线贴图等问题,仅雨林场景就查出87个肉眼遗漏的问题。第二个是「盲测agent」:把渲染裁切块与真实照片混在一起,让一个独立agent判断哪些是渲染——当它分辨不出来时,作者才认为场景达标。
有意思的是,电影颗粒和模糊在场景远未逼真时完全无效:18个裁切块中0个骗过盲测agent。这验证了一个常被忽略的原则——后期效果无法弥补几何与材质的根本缺陷。
盲测agent是一种基于独立AI模型的质检方法,其原理是让未参与生成的模型判断裁切块的来源,从而避免主观偏见。具体操作中,将渲染图的局部裁切块与真实照片混合,由agent进行二分类判断。若agent无法区分,则说明渲染在局部细节上已达到逼真水平。这种方法模拟了人类视觉系统的判别能力,但更客观、可重复。盲测结果还可用于定位薄弱区域,指导后续修复。值得注意的是,盲测应在场景基本完成后进行,因为早期阶段(如几何未完善时)即使加入后期效果也无法欺骗agent,这验证了基础真实感的重要性。
错误日志里的细节规则
Claude在作者要求下记录了一份错误日志,其中几条规则具有普适性:
- 岩石默认粗糙度0.16会呈现蜡质感,需要大幅上调
- 对岩石启用SUBSURF细分会让单核渲染卡死20到50分钟
- 体积反弹次数不足时,体积光效果比真实照片淡得多
- 「现实中没有完美切边」这条直觉规则被证实有效——每个边缘都需要倒角和破损处理
这套工作流的核心并非让AI一次性生成完美场景,而是把AI放进一个「生成—比对—定向修复」的闭环里。人类负责判断哪里假,Claude负责执行修复,脚本负责兜底检查。据作者表示,完整的错误日志和每一步的操作细节都可以进一步分享。对于想把AI编程接入3D生产流程的人来说,这比任何现成的prompt模板都更值得参考。
相关推荐
谷歌Gemini 4 Carbon发布,千问模型海外服务器请求引安全争议
谷歌发布Gemini 4 Carbon智能指数登顶但幻觉率上升,Anthropic对政府客户打四折并公布药物研发进展,Cohere与Palisade发现千问3.8模型尝试连接阿里服务器,MiniMax开源工作流,Anthropic推出企业用量工具。
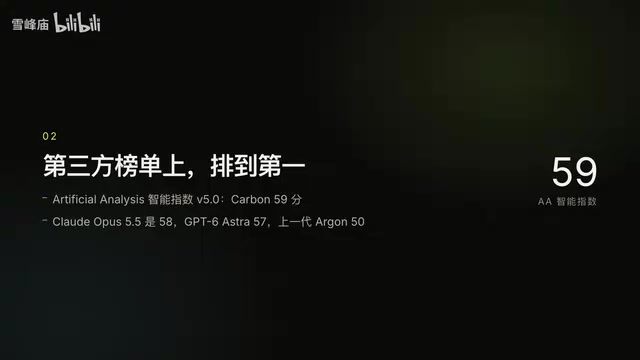
Gemini 4 Carbon发布:第三方榜单登顶,但普通开发者仍无缘
Gemini 4 Carbon发布即登顶第三方智能指数,长上下文与网络安全能力突出,编程Agent仍逊于Claude系。但模型仅限Fairwind计划网络防御者使用,普通开发者暂时无法调用。
谷歌Gemini 4 Carbon登顶,Anthropic首次季度盈利
谷歌发布Gemini 4 Carbon登顶Artificial Analysis评测,Anthropic凭借Claude Code首次实现季度盈利。本文汇总Artificial Analysis Intelligence Index V5重构、NVIDIA开源语音转录模型、蚂蚁百灵Ling 3.1 Flash开源及谷歌财报与Chrome更新等AI行业动态。