Claude Sonnet 5.5 登陆 Devin:编码性能大幅跃升

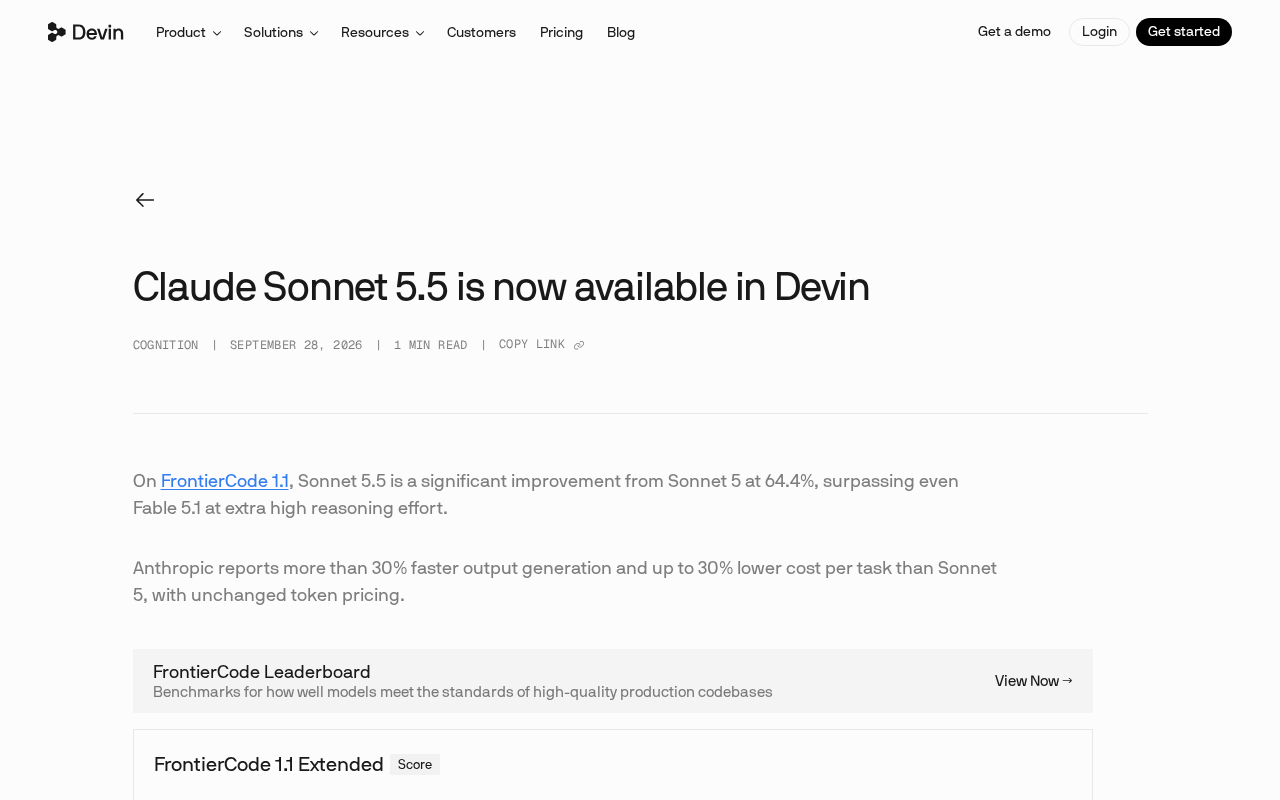
Claude Sonnet 5.5接入Devin,FrontierCode 1.1得分64.4%,以常规推理开销超越竞品高配置表现。
AI编程代理平台Devin宣布集成Anthropic新模型Claude Sonnet 5.5,这是其底层推理引擎的一次实质性升级。在FrontierCode 1.1编码基准上,Sonnet 5.5得分达64.4%,不仅较上代Sonnet 5显著提升,还在默认推理配置下超越了竞品Fable 5.1在"超高推理强度"下的表现。这一对比对高频调用的编码代理场景尤为关键——更低的推理开销意味着更短的响应延迟和更低的API成本。对Devin用户来说,模型升级通常无需额外操作,理论上可带来更少错误代码和更高的复杂任务一次性完成率,但基准分数与真实项目落地效果之间的差距仍需在实际工作流中验证。
Sonnet 5.5 正式接入 Devin
AI 编程代理平台 Devin 宣布集成 Anthropic 最新的 Claude Sonnet 5.5 模型。对于依赖 Devin 完成自动化软件工程任务的开发者而言,这意味着底层推理引擎迎来一次实质性升级。
从公开信息看,此次更新的核心亮点在于编码能力的显著提升。Devin 作为一款主打"自主软件工程师"定位的产品,其表现高度依赖底层大模型的代码理解、生成与调试能力,因此模型的每一次迭代都会直接反映到实际任务成功率上。
Devin 由 Cognition AI 开发,于 2024 年初以"首个全自主 AI 软件工程师"的定位进入公众视野。它的核心设计理念是让模型不仅能生成代码片段,还能在一个持久化的沙箱环境中自主执行终端命令、浏览文档、运行测试并迭代修复,完成从需求理解到代码合并的完整工程闭环。底层模型的能力直接决定了 Devin 在任务规划、错误归因和上下文维护等环节的表现上限,这也是每次模型升级对 Devin 用户而言都具有实质意义的根本原因。
FrontierCode 1.1 基准表现
根据官方给出的数据,在 FrontierCode 1.1 这一编码评测基准上,Sonnet 5.5 相较前代 Sonnet 5 实现了明显进步,得分达到 64.4%。
更值得关注的是,这一成绩甚至超越了 Fable 5.1 在"超高推理强度"(extra high reasoning effort)配置下的表现。这一对比颇具信息量:它说明 Sonnet 5.5 在默认或常规推理配置下,就能达到竞品模型在拉满算力与推理深度时才能触及的水平。
为什么这个对比重要
在实际部署中,"推理强度"往往直接关联到延迟与成本。一个模型如果需要开启超高推理强度才能达到某个准确率,通常意味着更长的响应时间和更高的 token 消耗。Sonnet 5.5 若能以更低的推理开销达到甚至超越对手的高配表现,对于需要大规模、高频调用的编码代理场景来说,性价比优势相当可观。
FrontierCode 是专为评估大模型在真实软件工程场景中的编码能力而设计的基准测试,覆盖代码生成、调试、重构和跨文件理解等多类任务,相比早期的 HumanEval 或 MBPP 等单函数补全基准,更贴近生产环境的复杂度。1.1 版本在题目难度分布和评测流程上较初版有所调整,旨在减少"猜题"效应,使得分更能反映模型的泛化能力。64.4% 的得分在当前主流模型横向比较中属于第一梯队区间,但由于各家测试条件(温度参数、pass@k 设置等)存在差异,跨机构的数字直接对比需保持一定谨慎。
"推理强度"(reasoning effort)是部分大模型服务商提供的可调参数,本质上控制模型在生成答案前进行内部"思维链"或多步验证的深度与轮次。调高推理强度通常可以提升答案质量,但代价是显著增加首次响应延迟(latency)和输入/输出 token 总量,从而推高每次调用的成本。在编码代理场景中,一个复杂任务可能涉及数十乃至数百次模型调用,推理强度的差异会被成倍放大,直接影响团队的 API 账单与用户等待体验。因此,"默认配置就能超越竞品高配置"这一说法,如果数据可靠,意味着 Sonnet 5.5 在吞吐量与准确率的权衡曲线上整体前移,而非仅在单一端点上取得优势。
对 Devin 用户的实际意义
对于正在使用 Devin 的团队,模型升级通常无需额外操作即可享受性能红利。更强的编码基准表现,理论上会转化为:更少的错误代码、更准确的任务分解,以及在复杂工程任务中更高的一次性完成率。
不过需要理性看待基准分数。FrontierCode 这类评测反映的是标准化任务下的表现,而真实项目中的代码库规模、上下文复杂度、依赖关系等因素,仍会对最终体验产生影响。基准提升是一个积极信号,但落地效果仍需在具体工作流中验证。
小结
Claude Sonnet 5.5 接入 Devin,是模型厂商与 AI 编程平台协同演进的又一个案例。64.4% 的 FrontierCode 1.1 成绩、以及超越竞品高配置的表现,展示了新一代编码模型在效率与准确率上的双重进步。对于关注 AI 辅助编程的开发者,这是一个值得跟进的更新。
由于当前公开的信息主要集中在基准数据层面,关于 Sonnet 5.5 在长上下文处理、多文件重构等具体能力上的细节,仍有待后续官方或社区的进一步测评补充。
相关推荐

一个月上线2500个PR:pstack作者的AI软件工厂方法论
pstack 作者、Cursor 与 grokbot 开发者 poteto 与 Matt Pocock 对谈,拆解一个月上线 2500 个 PR 的 AI 软件工厂方法论:信任阶梯、验证技能、环境约束、内外循环与幕僚长智能体。

《钟楼谜团》玩法揭秘:一场充满欺骗与推理的桌游盛宴
科普创作者 Dr. Simon Clark 与 Tom Nicholas 做客布林德利庄园,参与社交推理桌游《钟楼谜团》(Blood on the Clock Tower)。本文解析游戏玩法、说书人机制与心理博弈魅力。

Cursor 零基础入门:用 AI 从零写出完整项目
Cursor 零基础保姆级教程:从下载安装、三种对话模式(Agent/Ask/Manual)到选择 Claude 模型,手把手演示如何用 AI 从零开发一个学生管理系统,并解析开发环境配置等关键前提。