Claude Sonnet 5.5发布:更快更省的Opus搭档

Claude Sonnet 5.5 以持平价格实现速度提升30%、单任务成本降低30%,主打高性价比的编程与知识工作场景。
Anthropic 发布 Claude Sonnet 5.5,定位为 Opus 5.5 的高效搭档,专注于范围明确的日常任务。新模型在保持 Sonnet 5 定价不变的前提下,速度提升 30% 以上,单任务成本最多节省 30%。基准测试表现突出:Terminal Bench 4.0 得分从前代的 10.3% 跃升至 70.6%,多项测试成绩接近 Opus 5.5。编程场景提升最为显著,Frontier Code 单任务成本约为前代十五分之一。模型引入 Effort 档位机制,允许开发者按任务复杂度灵活调配算力预算。安全层面,它成为首个带网络安全防护和防推理提取分类器发布的 Sonnet 模型。整体策略不追求能力上限突破,而是将「同等能力下更快更省」作为核心竞争力。
Anthropic 正式发布 Claude Sonnet 5.5,这是 Claude 5.5 系列的第二个模型。相比上一代 Sonnet 5,它在多数任务上速度提升 30% 以上,成本最多能省 30%,被官方定位为「更快、更便宜的 Opus 搭档」。这次更新的重点不在于挑战能力天花板,而在于把「性价比」这件事做到极致。
产品定位:日常任务的高效执行者
在 Claude 5.5 家族里,几款模型分工明确。Opus 5.5 负责需要仔细判断的复杂开放式工作;Sonnet 5.5 则是它的搭档,最擅长范围明确的日常任务——修 bug、制作精致的文档、幻灯片和表格。面向大批量、对成本敏感场景的 Haiku 5.5 官方表示会在几周内加入。
这种分层意味着 Sonnet 5.5 不是要取代 Opus,而是承接那些「界定清晰、追求效率」的活儿。官方也坦率承认:在需要持续判断的复杂工作上,Opus 5.5 仍然明显更强,跑分只反映能力的一面。
跑分表现:接近 Opus,甩开前代
从测试数据看,Sonnet 5.5 的进步相当显著。在考察命令行多步骤专业任务的智能体编程测试 Terminal Bench 4.0 上,Sonnet 5.5 拿到 70.6%,而 Sonnet 5 只有 10.3%——这是一次跨越式的提升。
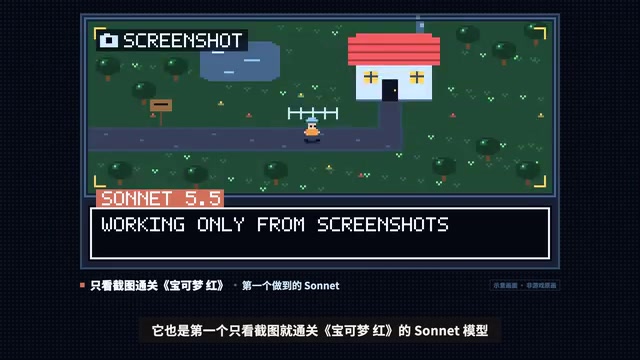
在覆盖 44 种真实职业工作的 GDP VAL AA 测试中,它比 Sonnet 5 高出约 400 分,只比 Opus 5.5 低 2 分。它还是第一个仅凭截图就通关宝可梦红的 Sonnet 模型,展现了不俗的多模态与长周期决策能力。
值得关注的是成本对比。官方为每个测试都画了「分数对成本」的曲线。以 Terminal Bench 为例,默认中档的 Sonnet 5.5 得分 28.8%,每个任务约 0.83 美元;而 Sonnet 5 即便开到最高档也只有 10.3%,每个任务却要约 11.6 美元。换句话说,它在开低档或中档时就能超越前代的最好成绩,单任务成本仅为约十分之一。
Terminal Bench 4.0 是专门评估 AI 模型在命令行环境中完成多步骤专业任务能力的基准测试,涵盖文件操作、脚本编写、环境配置等真实工程场景,要求模型具备持续规划和工具调用能力。GDP VAL AA(General Domain Professional Validation)则是一套覆盖 44 种职业工作流的综合评测,包含法律文书、财务分析、市场研究等岗位实际操作,分数反映模型在真实职业场景中的综合表现,比单一能力测试更贴近企业落地需求。两项测试的共同特点是强调「智能体」能力——模型需要连续决策、调用外部工具并完成多轮任务,而非仅回答单一问题,因此对推理效率和工具整合能力的要求远高于传统问答基准。
编程与知识工作的实际提升
编程是这次提升最明显的领域。在 Frontier Code 上,同样开高档,Sonnet 5.5 比 Sonnet 5 高 1 分,但每个任务的成本约为其十五分之一。在取自真实 Cursor 编程场景的 Cursor Bench 上,它的最好成绩与 Opus 5.5 只差两分左右。

早期测试者反馈,它理解代码库很快、更省钱,而且更擅长把工具调用打包在一起,做同一任务的步骤更少、成本更低。这种「工程效率」上的优化,往往比单纯的分数更贴近开发者的日常体验。
知识工作同样有进步。计算机操作和读图表两项都接近 Opus 5.5,长周期的知识工作明显强于 Sonnet 5 和 GPT-6。它的写作比上一代更清楚,对设计也有眼光,会给界面加细节,还能照着幻灯片模板做出几乎不用改的演示稿。
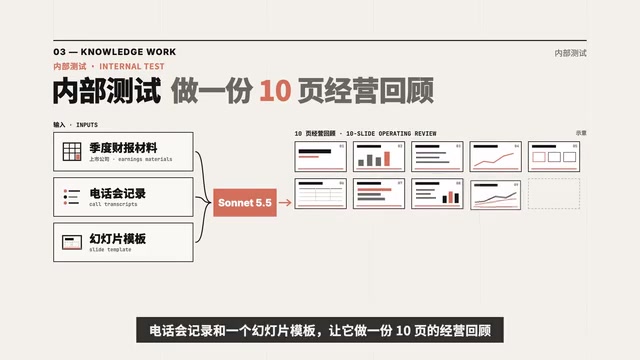
在一项内部测试中,官方给它一家上市公司的季度财报材料、电话会记录和一个幻灯片模板,让它做一份经营回顾。两位专家判断它的第一稿可以直接发出去——这对面向企业的文档生成场景是个有说服力的信号。
价格与 Effort 档位机制
价格方面,Sonnet 5.5 与 Sonnet 5 持平:每百万输入 Token 2 美元,输出 10 美元,缓存读取 0.2 美元,都是 Opus 5.5 对应价格的一半。但因为完成同样工作所需的 Token 更少,官方测试里单任务最多便宜 30%,输出速度快 30% 以上,是目前最快的 Sonnet。
模型引入了 Effort 档位,用来在成本、速度和质量之间取舍。Claude Code 和 Claude 应用默认中档,开发平台默认高档。档位低时回答快、Token 少,适合日常工作;档位高则思考更久、检查更仔细。这种可调节机制让开发者能按任务复杂度灵活分配算力预算。
Effort 档位(Effort Level)是 Anthropic 在 Claude 5.5 系列中引入的算力分配控制机制,本质上是让模型在生成回答前投入不同深度的「内部思考」。低档位下模型倾向于快速响应,减少中间推理步骤,适合格式化输出、简单问答等对延迟敏感的场景;高档位则会触发更长的思维链,对结果进行多次自我校验,类似于 OpenAI o 系列的「延长推理」机制。这种设计的核心价值在于让开发者不必为所有请求支付「顶级推理」的算力成本——一个批量生成产品描述的任务无需与调试复杂并发 bug 消耗相同的资源。Token 缓存读取价格(0.2 美元/百万)进一步放大了这一优势:对于需要反复引用同一长上下文的企业场景,实际边际成本可以大幅低于官方标价。
安全评估:首个带网络安全防护的 Sonnet
Sonnet 5.5 没有推进能力的前沿,因此评估重点放在任何能力的模型都可能出现的风险上——违背用户利益、误导用户、配合高风险滥用。在约 1850 个场景的自动化行为审计中,它在大多数对齐、防滥用和诚实度指标上与 Sonnet 5 持平或更好,且在沙盒测试里是所有模型中最少去试探容器边界的。

由于网络安全能力大幅提升,它成为第一个带网络安全防护发布的 Sonnet 模型。日常找 bug、修 bug 不受影响,但高风险的网络安全任务会明确切回 Sonnet 5。生物方面的防护与 Sonnet 5 一致,它也是第一个带防推理提取分类器发布的 Sonnet 模型,用来防止有人用大量假账号大规模套取能力。
「防推理提取分类器」(Anti-Inference Extraction Classifier)是针对一种特定攻击模式设计的防御机制。这类攻击通常通过构建大量精心设计的假账号或 API 请求,以分批、迂回的方式逐步套取模型在训练中习得的敏感能力——例如将一个高风险问题拆解成数百个看似无害的子问题,再在本地拼合成完整答案。分类器的作用是在推断层识别这种系统性探测行为,而非仅依赖单次请求的内容审查。网络安全任务切回 Sonnet 5 的设计,则体现了 Anthropic「能力越强、护栏越严」的分级发布策略——新模型的网络安全能力提升本身也扩大了潜在的滥用面,在完整评估完成前主动降级是目前业内较为保守但合规风险最低的处理方式。
如何使用
Claude Sonnet 5.5 现已在 AWS、Google Cloud 和 Microsoft Azure 等平台全面可用。开发者在 Claude 开发平台上使用模型名 Claude Sonnet 5.5 即可开始。需要注意的是,如果你原来是关掉思考再用 Sonnet,迁移前要更换成新的 Between Tools 设置。
整体来看,Sonnet 5.5 没有追求能力上限的突破,而是把「同等能力下更快更省」做成了核心卖点。对于大批量、成本敏感的编程与知识工作场景,它很可能成为比 Opus 更务实的选择。
相关推荐

Opus 5.5实测:一个Skill把PDF变成交互式动画电子书
开发者基于 Claude Opus 5.5 打造开源 Skill「Papermorph」,通过 PDF→规划→分镜→旁白→动画测验的流水线,把静态 PDF 自动转化为带交互测验的动画网页电子书,且暂未使用图像模型。本文拆解其工作流与技术亮点。

Perplexity押注垂直整合:Vera芯片替代x86背后的Agent基建野心
Perplexity宣布垂直整合其智能体基础设施,自建沙箱并押注Vera架构替代x86,开始部署Perplexity Computer。本文解析这一战略背后的技术逻辑与行业意义。

Extra Big Ass Intelligence:一场对AI炒作的幽默反讽
Extra Big Ass Intelligence是一个在Hacker News走红的恶搞项目,用幽默反讽调侃AI行业的过度炒作与命名通胀,引发技术社区对AI营销泡沫的集体反思。