Claude Sonnet 5.5实测:性能反超Opus,成本还砍半
Sonnet 5.5 速度与成本双降30%,编码能力接近Opus 5.5,补齐Anthropic中端产品线短板。
Anthropic 发布的 Claude Sonnet 5.5 在速度与成本上各提升约30%,同时在编程基准、视觉交互和通用智力测试中全面超越前代 Sonnet 5。最引人注目的是 Terminal Bench 4.0 测试中 Sonnet 5.5 以仅约1/90的成本反超 Opus 5.5,展现出极高性价比。然而 Max 推理档位存在"高成本低回报"的陷阱,建议用户保持在 Hi 或 Extra Hi 等级。涉及网络安全和生物类任务时,模型会自动降级回较弱的 Sonnet 5,是实际使用中需注意的限制。整体而言,Sonnet 5.5 重新确立了 Anthropic 在中端 AI 模型市场的竞争力。
Anthropic 刚刚发布了 Claude Sonnet 5.5(视频中亦称 Summit 5.5),距离上周 Opus 5.5 惊艳登场仅隔数日。这次更新的核心卖点非常直接:速度提升约 30%、成本下降约 30%,并且在几乎所有维度上都优于前代 Sonnet 5。对于一款定位「日常任务」的中端模型来说,这样的迭代幅度相当罕见。
从失望到惊喜:Sonnet 5 的痛点被正面回应
先前 Sonnet 5 的发布口碑并不理想。它不仅基准成绩平平,更大的问题在于「吞 Token」——在复杂任务上把模型推到极限时,实际成本会失控上涨。这让不少开发者对 Sonnet 系列失去信心。
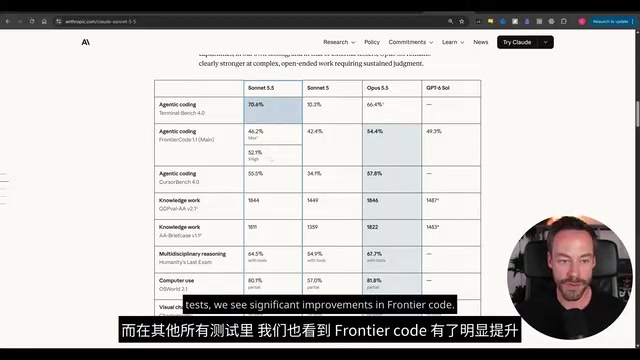
Sonnet 5.5 恰恰是冲着这个痛点来的。据这位 B 站 UP 主的分析,新模型在多个编程基准上出现了明显跃升:Frontier Code 相关分数从 42 一路提升到 46 和 52,Cursor Bench 分数也显著提高。换句话说,Anthropic 这次不是单纯堆能力,而是把「性价比」重新拉回及格线以上。
Terminal Bench 4.0:Sonnet 反超 Opus 的意外结果
最令人印象深刻的测试来自 Terminal Bench 4.0 的编码任务。在最高难度设置下,Sonnet 5.5 的表现竟然超过了定位更高端的 Opus 5.5——而它完成同样任务的成本仅为 12.54 美元,Opus 则高达 1124 美元。这种「以下克上」的结果虽然需要保留态度,但成本差距足以说明问题。
另一个有意思的现象是,Sonnet 5.5 在该测试中的性能几乎从 Medium 一路线性提升到 Max,而很多模型在到达高档位后就会趋于平稳。这意味着在终端类任务上,加大推理投入确实能换来稳定回报。
Terminal Bench 4.0 是一个专为评估 AI 模型在终端/命令行环境中自主完成复杂编程任务而设计的基准测试集,版本 4.0 引入了更严苛的多步骤任务链。测试通常设有"努力等级(Effort Level)"参数,从 Low 到 Max 不等,控制模型可调用的推理步骤数量与工具调用次数。Medium、Hi、Extra Hi、Max 等档位直接影响模型在单次任务中消耗的 Token 总量,因此也线性影响费用。"以下克上"的测试结果之所以值得重视,部分原因在于 Opus 级别模型在此类任务中默认会调用更复杂的推理链,Token 消耗呈指数级增加,而 Sonnet 5.5 凭借优化后的编码能力在相近正确率下大幅节省了推理步骤。
Max 档位并非万能:成本失控的隐忧
不过换到更复杂的高级编程场景,情况就变得微妙。在「Hi(高)」努力等级下模型达到 49.4%,而调到 Max 档位后反而下降到 46.2%,成本却从 42 美分一路飙升到 21 美元。

这几乎是 Sonnet 5 时代问题的翻版——Max 档位并不总是意味着更好的性能,却几乎必然意味着更高的开销。UP 主给出的实用建议是:日常使用时把努力等级保持在「Hi」或「Extra Hi」,不要盲目拉满,否则成本收益比会迅速恶化。
从每百万 Token 的定价看,Sonnet 5.5 相比 Opus 5.5 优势明显:缓存读取成本同为 20 美分,但缓存写入费用仅为原来的一半,Input 和 Output Token 也都只需一半价格。把这些定价结构与基准提升结合起来,就得到一个特别适合中等复杂度任务的模型——不必动用 Opus,也不需要更顶端的方案。
「吞 Token」(Token overuse)是指模型在面对复杂或模糊的任务时,会生成大量中间推理步骤、重复性验证或冗余输出,导致实际消耗的 Token 数远超任务本身所需。在以 API 计费的商业场景下,这会让看似合理的单次调用成本急剧膨胀。Max 档位会解除对推理步骤数量的限制,让模型"尽其所能"地探索解法,但在任务边界模糊时反而容易陷入循环或过度思考,正确率未必提升,费用却可能增加数十倍。这也是为什么许多生产环境中的工程师倾向于在预算约束下寻找"甜蜜点"档位,而非一味拉满。
智力与多模态:向 Opus 5.5 看齐
在更贴近真实任务的 GDP VAL 测试中,Sonnet 5.5 的提升同样巨大,据分析其表现已达到 Opus 5.5 的水平,较 Sonnet 5 提升约 400 分。
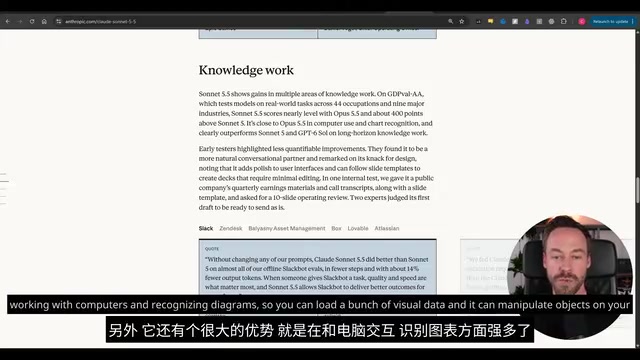
视觉与电脑交互能力也是这次的重点升级方向。Sonnet 5.5 在识别图表、操作电脑上的各类对象方面明显增强,可以加载大量视觉数据并稳定执行任务。此外,UP 主特别提到「沟通体验」的改善——Opus 5 当年测试成绩不错却难以沟通,这个问题在 Opus 5.5 中被修复,如今 Sonnet 5.5 也号称更擅长对话。如果这套改进真能贯彻到整个 Sonnet 系列,将是很实在的体验提升。
安全机制:网络安全与生物任务会被降级
每一代新模型都会附带安全措施,Sonnet 5.5 也不例外。它的网络安全能力已强到与 Opus、更高端模型同级,因此 Anthropic 设置了一道机制:当模型判断用户正在执行有风险的网络安全任务时,会自动切换到更小、更简单的模型。

对 Sonnet 系列来说,这意味着会降级回表现平平的 Sonnet 5(Opus 系列则会切到 Opus 4.8)。这带来一个现实困扰:做网络安全类任务时,最好别指望 Sonnet 系列,因为降级后的 Sonnet 5 体验并不好。同样的限制也适用于生物领域相关任务。
Anthropic 的"自动降级"机制属于其 AI 安全策略中"能力限制"的一部分,原理是在推理层面对任务意图进行分类,一旦判定请求涉及高风险领域(如漏洞利用、恶意代码生成、生化合成路径查询),则将请求路由至能力更受限的较小模型,而非简单拒绝。这种设计的出发点是在保留模型可用性的同时降低滥用风险,但对合规用途的安全研究人员来说会造成误伤,因为分类器很难精准区分"渗透测试演练"与"真实攻击意图"。Opus 系列降级至 Opus 4.8、Sonnet 系列降级至 Sonnet 5,意味着针对安全场景的用户需要提前评估降级后模型是否仍满足其工作流需求。
结语:Anthropic 补齐了中端产品线的短板
Sonnet 5.5 已经在各处上线,发布以来表现稳定。如果说 Opus 5.5 巩固了 Anthropic 在高端的地位,那么 Sonnet 5.5 则试图补上此前被 OpenAI 等对手拉开差距的中端市场——用更低价格提供足以应付日常任务的强大模型。
UP 主直言,此前的 Sonnet 5 让 Anthropic 在这个价位段有些吃力,而 5.5 的这轮提升让局面重新回到有利位置。对普通用户而言,这意味着不必为中等复杂度的编程和分析任务支付 Opus 级别的费用,就能拿到接近的效果——这才是这次更新最实际的价值所在。
相关推荐

Opus 5.5实测:一个Skill把PDF变成交互式动画电子书
开发者基于 Claude Opus 5.5 打造开源 Skill「Papermorph」,通过 PDF→规划→分镜→旁白→动画测验的流水线,把静态 PDF 自动转化为带交互测验的动画网页电子书,且暂未使用图像模型。本文拆解其工作流与技术亮点。

Perplexity押注垂直整合:Vera芯片替代x86背后的Agent基建野心
Perplexity宣布垂直整合其智能体基础设施,自建沙箱并押注Vera架构替代x86,开始部署Perplexity Computer。本文解析这一战略背后的技术逻辑与行业意义。

Extra Big Ass Intelligence:一场对AI炒作的幽默反讽
Extra Big Ass Intelligence是一个在Hacker News走红的恶搞项目,用幽默反讽调侃AI行业的过度炒作与命名通胀,引发技术社区对AI营销泡沫的集体反思。