Claude安全护栏太敏感?用户吐槽与使用建议

Claude安全护栏因过于敏感而误伤合法需求,用户需调整提问策略应对。
文章从一位Reddit用户的吐槽切入,探讨Claude安全护栏是否过于严格。作者指出,Anthropic以安全为核心卖点,采用宪法AI等方法使模型在潜在风险话题上倾向保守,导致在网络安全、医疗、法律等场景频繁触发拦截。问题根源在于模型难以区分恶意意图与合法需求,造成过度拒绝、缺乏解释、影响效率等痛点。用户分享了改写提问、分步提问、切换模型、申请权限等变通方法。文章认为安全与可用性的平衡是行业普遍挑战,建议开发者明确上下文、使用系统提示并关注官方文档,同时指出根本解决仍需模型优化。
引言:当安全护栏成为使用障碍
最近,一位Reddit用户在试用Claude一个月后发出了疑问:“Claude一直这样吗?能力很棒,但安全护栏敏感得离谱。”他提到,在排查某些问题时,甚至感觉需要以“安全研究员”的身份申请才能继续对话。这引发了不少讨论:Claude的安全机制是否过于严格?是用户使用方式不对,还是产品本身的设计使然?
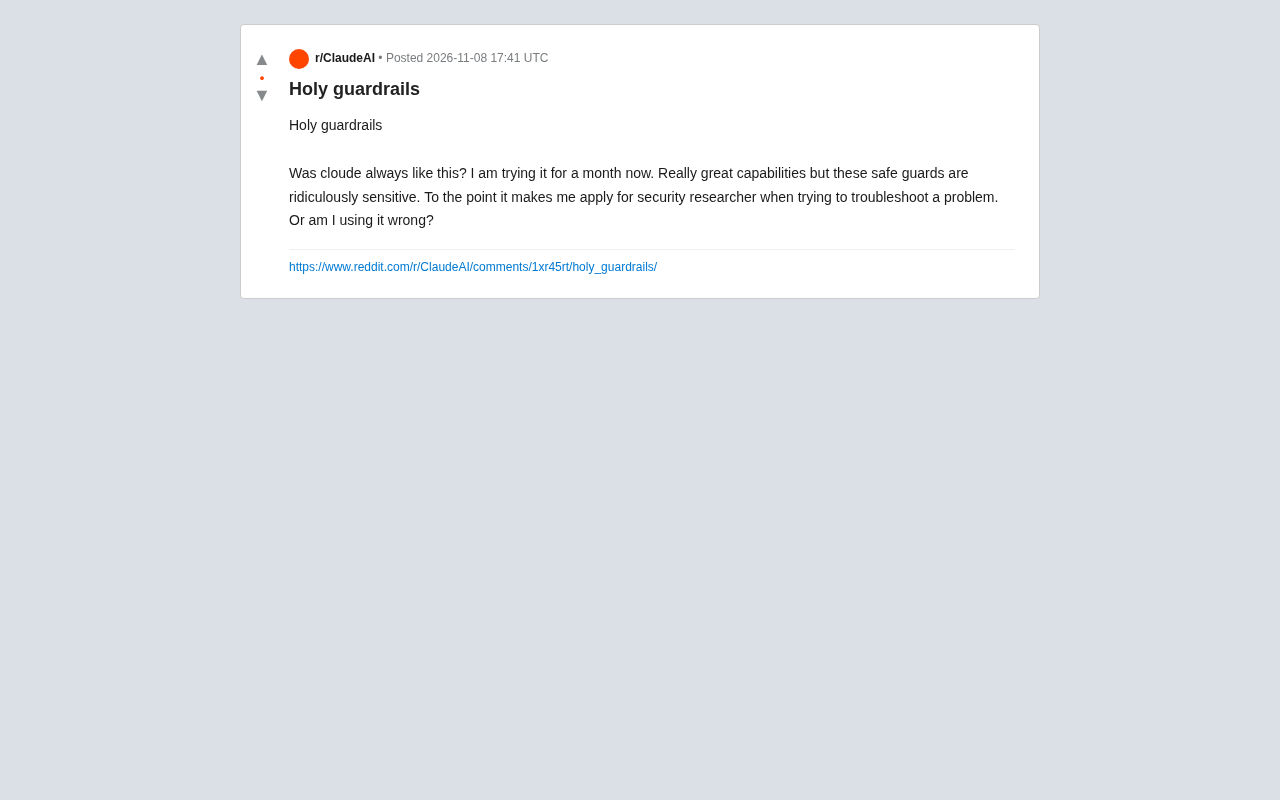
从社区反馈来看,这并非个例。许多用户在尝试处理安全相关、医疗、法律甚至代码漏洞排查等话题时,都遇到了Claude的拦截或拒绝回答。安全护栏本是为了防止滥用,但当它频繁打断正常的工作流程时,用户的挫败感便油然而生。
Claude安全护栏为何如此敏感?
设计理念:安全优先于可用性
Claude的开发公司Anthropic一直将“安全”作为核心卖点。其模型在训练过程中采用了“宪法AI”等方法,旨在让AI的输出符合一系列伦理准则。这种设计理念导致Claude在面对潜在风险话题时,会倾向于保守回应,甚至直接拒绝。与一些竞争对手相比,Claude的护栏阈值可能设置得更低。
据社区用户观察,Claude在涉及以下场景时容易触发护栏:
- 询问网络安全漏洞的利用方式(即使是为了防御)
- 讨论药物剂量或医疗建议
- 涉及法律条款的具体解释
- 生成可能被用于欺诈的文本
宪法AI(Constitutional AI) 是Anthropic提出的一种训练方法,其核心是让模型依据一份成文的“宪法”——即一系列原则性规则——来审视和修订自己的输出,而非完全依赖人工标注的偏好数据。具体而言,模型先对问题生成初步回答,再根据宪法条款进行自我批评与改写,最后通过强化学习让模型倾向于产出符合这些原则的回应。这种方法的好处是规则透明、可扩展,能覆盖大量难以逐一标注的边界场景;代价则是模型在遇到模糊或潜在风险话题时,往往选择更保守的路径,从而表现为护栏阈值偏低、拒绝率偏高。理解这一点,有助于解释为何Claude在正常技术讨论中也容易触发拦截。
用户意图与模型判断的错位
问题在于,模型很难准确区分“恶意意图”和“合法需求”。例如,一名开发者在调试自己的应用时,可能需要了解某种攻击向量,但Claude可能将其误判为潜在的恶意请求。这种错位导致用户不得不反复修改提问方式,甚至感到被“审查”。
过度拒绝(over-refusal) 是AI安全领域的一个专门术语,指模型将本应正常回答的良性请求误判为有害请求而加以拒绝。它通常源于分类器或对齐训练对某些关键词、话题的敏感度过高,以及模型缺乏足够的上下文推理能力来区分“讨论攻击原理”与“实施攻击”。过度拒绝不仅损害用户体验,还会削弱用户对安全机制的信任,因为用户会逐渐学会绕过而非遵守规则。业界通常用“良性请求拒绝率”与“有害请求拦截率”两个指标来权衡护栏的松紧,理想的护栏应在前者尽量低的同时保持后者较高。
用户反馈:挫败感与应对策略
常见吐槽点
在Reddit帖子中,用户提到“为了排查一个问题,感觉需要以安全研究员的身份申请”。这反映了几个痛点:
- 过度拒绝:即使问题本身无害,Claude也可能因为关键词或上下文而拒绝回答。
- 缺乏解释:拒绝时往往只给出一段通用声明,不说明具体触发了哪条规则,用户难以调整。
- 影响工作效率:在需要快速迭代的开发或研究场景中,频繁的拦截会打断思路。
用户的变通方法
一些用户分享了他们的应对技巧:
- 改写提问:避免使用敏感词汇,用更中性的语言描述问题。例如,将“如何利用漏洞”改为“如何修复类似漏洞”。
- 分步提问:将复杂问题拆解为多个简单问题,降低单次请求的敏感性。
- 切换模型:对于某些任务,转而使用护栏较宽松的模型(如GPT系列或开源模型)。
- 申请权限:部分企业用户可以通过API申请更高的使用权限,但普通用户难以获得。
系统提示(system prompt) 是对话开始前由用户或开发者设定的一段指令,用于规定模型的角色、语气和回答边界,其优先级通常高于普通用户消息。在Claude等模型中,合理使用系统提示可以显著降低误判:例如明确声明“以下讨论仅用于防御性安全研究,请从防护角度解释”,相当于为后续对话提供了持续生效的上下文锚点,帮助模型在判断意图时获得更多依据。需要注意的是,系统提示并非万能,它不能突破模型明确禁止的核心限制,但能减少因上下文缺失导致的过度拒绝,是技术用户提升可用性的实用手段。
安全与可用性的平衡难题
行业普遍挑战
Claude的困境并非孤例。所有大型语言模型提供商都在安全与可用性之间寻找平衡。过于宽松会导致滥用风险,过于严格则损害用户体验。Anthropic的选择显然偏向安全,这与其品牌定位一致,但也可能限制其在某些专业领域的应用。
对开发者的建议
如果你经常使用Claude进行技术工作,可以尝试以下方法减少摩擦:
- 明确上下文:在提问时说明你的身份和目的,例如“我是一名软件工程师,正在修复自己项目中的安全漏洞,请解释这种攻击的原理以便防御”。
- 使用系统提示:通过系统提示设定角色,引导Claude以更专业的方式回应。
- 关注官方文档:了解Claude的使用政策和限制,避免触碰明确禁止的领域。
结语:理解护栏,善用工具
Claude的安全护栏是其设计哲学的一部分,虽然有时显得敏感,但用户可以通过调整提问策略来改善体验。同时,社区反馈也在推动模型提供商优化护栏的精准度。对于普通用户而言,理解这些限制并灵活应对,才能更好地利用Claude的强大能力。
如果你也有类似经历,不妨在社区分享你的应对技巧。毕竟,工具是死的,人是活的。
相关推荐

Gemini 4 Neon 曝光:或成 Opus 5.5 有力竞争者
Hacker News 讨论帖指出 Gemini 4 Neon 看起来像 Opus 5.5 的竞争者。本文解读这一社区信号背后的产品定位、顶级模型竞争格局变化,以及对开发者模型选型策略的实际意义。

Claude Fable 5.2 独立创作短片《Fable》引热议
Hacker News 上出现由 Claude Fable 5.2 独立完成剧本、画面与导演的短片《Fable》,本文分析全流程 AI 创作的意义、社区反应及对内容创作者的启示。

Anthropic IPO定价:AI巨头上市信号
Anthropic 进行 IPO 定价的消息引发关注。本文分析这一动作对 AI 行业估值、商业化路径和竞争格局的潜在影响,并指出公开市场对 AI 公司的期待与挑战。