Claude发布Fable 5.2与Mythos 5.2:同一模型双版本,API降价
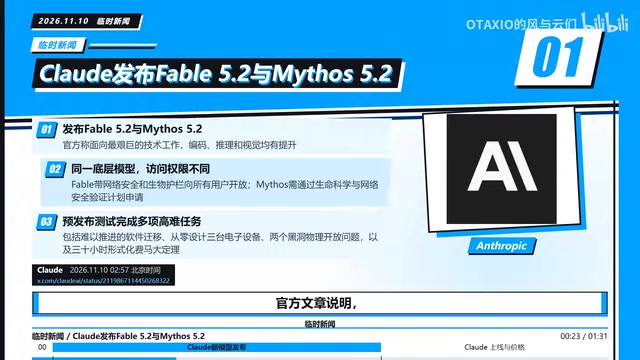
Claude 推出同源双版本 Fable 5.2 与 Mythos 5.2,以访问权限区分安全等级并下调 API 价格。
Claude 官方发布 Fable 5.2 与 Mythos 5.2,二者实为同一底层模型,区别仅在访问权限:Fable 5.2 带网络安全与生物安全护栏向所有用户开放,Mythos 5.2 需通过生命科学或网络安全验证计划申请。官方称预发布测试中模型完成了软件迁移、三台可工作电子设备的设计、两个黑洞物理开放问题,并用 30 小时形式化证明了费马大定理。价格方面,标准模式每百万输入 8 美元、输出 40 美元,低于上一代的 10 美元和 50 美元;可选快速模式速度最多提升 2.5 倍,定价为 16 美元和 80 美元,Mythos 的快速模式仅向验证组织开放。Fable 5.2 发布当天起在所有付费方案、Claude 平台及亚马逊云科技、谷歌云、微软 Azure 上提供。
Claude 官方账号发布消息,推出 Claude Fable 5.2 与 Claude Mythos 5.2 两个新版本,面向最艰巨的技术工作,在编码、推理和视觉等方向均有提升。官方文章明确指出,Fable 和 Mythos 其实是同一个底层模型,区别仅在于访问权限。
同一模型,两种访问权限
Fable 5.2 带有网络安全和生物安全护栏,向所有用户开放;Mythos 5.2 则需要通过生命科学验证计划和网络安全验证计划申请。这种"同模型、双版本"的策略,本质上是将安全合规要求前置到访问控制层,而非在模型能力上做切割。对于普通开发者和企业用户,Fable 5.2 是默认选择;对于生命科学和网络安全领域的专业机构,Mythos 5.2 提供了经过验证的访问通道。
安全护栏(Safety Guardrails) 指的是模型在输出层面部署的自动拦截与拒答机制,通常基于分类器或策略模型实时判断请求是否涉及高风险领域(如恶意代码生成、病原体设计、漏洞利用等),并对命中策略的请求进行拒绝、降级或附加警告。与"能力裁剪"不同,安全护栏并不降低模型在合规任务上的表现,而是在输入输出链路上做策略过滤。将护栏与访问权限绑定,意味着厂商把合规判断从"模型训练阶段"后移到"访问控制阶段":普通用户默认走带护栏通道,专业机构通过资质验证后获得更少限制的通道。这种设计的代价是护栏可能带来误拒(false refusal),因此验证计划本质上也是在为高信任用户提供一条绕开误拒的合规路径。
预发布测试中的硬核表现
官方透露,在预发布测试中,这两个模型帮助工程师完成了原本难以推进的软件迁移,设计出三台可工作的电子设备,解决了两个黑洞物理的开放问题,并用 30 小时形式化证明了费马大定理。这些案例覆盖了软件工程、硬件设计、天体物理和数学证明,说明模型在长周期、高复杂度的技术任务上具备实际推进能力。
形式化证明(Formal Proof) 是指用机器可检验的逻辑语言(如 Lean、Coq、Isabelle)把数学命题及其证明完整写出,由证明助手逐行检查每一步推理是否合法,从而排除人为疏漏。与自然语言证明不同,形式化证明的结论是"编译器验证通过",可信度更高但撰写成本极大。费马大定理的形式化是数学界公认的工程级难题,因为它依赖大量现代代数数论与模形式理论,需要先形式化海量前置引理。"30 小时"这一说法通常指模型在交互式证明环境中持续尝试、补全引理并修复编译错误所累计的时长,反映的是模型在长周期、可验证反馈任务上的耐力,而非一次性生成能力。
API 定价下调,快速模式可选
Fable 5.2 从发布当天起在所有付费方案、Claude 平台以及各大云平台(包括亚马逊云科技、谷歌云和微软 Azure)上提供。价格方面,每百万输入 token 8 美元、每百万输出 token 40 美元,低于上一代的 10 美元和 50 美元。官方还提供一个可选的快速模式,生成速度最多提升 2.5 倍,价格为每百万输入 token 16 美元、每百万输出 token 80 美元。其中 Mythos 的快速模式仅向通过验证计划的组织开放。
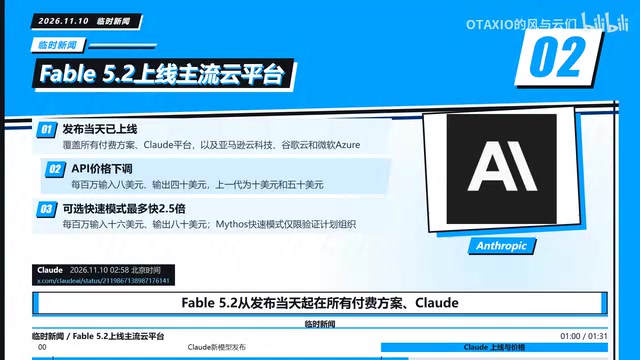
Token 计价与快速模式 是理解成本结构的关键。大模型 API 按输入 token(提示词与上下文)和输出 token(生成内容)分别计费,输出通常更贵,因为自回归逐 token 生成的计算量更大。本文中输出价格是输入的 5 倍,符合这一行业惯例。快速模式(fast mode)一般通过更激进的推理配置、更大的并行度或专用算力池来换取更低延迟,代价是单位 token 价格翻倍。对于延迟敏感型应用(如交互式编程助手、实时客服),2.5 倍速度提升可能比单价更重要;而对于批处理、离线分析类任务,标准模式更经济。选型时应按"每完成一个任务的总成本"而非"每 token 单价"来评估。
对开发者的实际影响
定价下调直接降低了高频调用场景的成本门槛,而快速模式则为延迟敏感型应用提供了性能选项。同一底层模型的双版本设计,也意味着开发者不必在"能力"和"合规"之间做取舍——选择哪个版本,取决于使用场景的验证要求,而非模型本身的强弱。对于需要处理敏感数据的生命科学或网络安全团队,Mythos 的验证流程虽然增加了接入步骤,但也为合规使用提供了明确路径。
值得关注的信号
Claude 此次将安全护栏与访问权限绑定,而不是对模型能力做差异化限制,这种思路在业内具有一定参考价值。同时,官方用费马大定理形式化证明、黑洞物理开放问题等案例来展示模型能力,也反映出当前头部模型厂商在宣传上越来越倾向于用可验证的硬核任务说话,而非泛泛的基准测试分数。
相关推荐

Cursor、Devin、TRAE、Copilot价格怎么比?先算额度再比月费
横向对比Cursor、Devin Desktop、TRAE、Copilot四家AI编程工具的个人与团队定价,拆解额度规则、第三方模型是否含在月费、超额计费方式,并给出付费前测消耗、设支出上限和选型的实操方法。

Copilot下架三款模型:Pro用户替代选择只剩一个
GitHub Copilot 自 11 月 16 日起下架 Claude Opus 4.8、Claude Opus 5、GPT-5.6 Tera 三款模型,覆盖 Chat、代码补全与 Agent 模式。Pro 用户三个替代中仅剩 GPT-6 Luna 可用,年付 Legacy 计划拿不到 Opus 5.5,管理员需手动开启替代模型。

Gemini 4 Carbon登场:大模型竞赛进入百万上下文与万亿开源时代
谷歌发布Gemini 4 Carbon并推出多智能体工具Swarm,Anthropic推出百万上下文Fable 5.2与Mythos 5.2,OpenAI发布安全专版GPT-6 Cyber,Mistral与Kimi同步开源万亿参数模型,大模型竞赛全面提速。