Claude过滤器收紧,游戏Mod开发者为何担忧?

Reddit用户担忧Anthropic收紧版权过滤后,Claude对游戏Mod和反编译任务的可用性将下降。
一位Reddit用户发帖表达了对Claude未来可用性的担忧。他几乎只用Claude进行游戏反编译、Mod制作、克隆游戏机制和移植系统等深度改造任务,Claude此前在这些场景中表现配合。但Anthropic收紧版权过滤后,用户担心更多请求会被拦截。他描述了Claude有时以随意甚至矛盾的理由拒绝请求,例如称“狗头人是儿童编码的”而拒绝添加血腥战斗。文章分析指出,这反映了创作者将核心工作流绑定在持续迭代的商业模型上所面临的结构性风险,同时强调该担忧基于单一用户叙述,尚需多源验证。
一位Reddit用户近日发帖表达了对Claude未来可用性的深层担忧。他几乎只用Claude做游戏相关的工作:反编译游戏、制作Mod、克隆游戏机制、为《塞尔达传说:时之笛》添加新区域和新Boss、把某个系统从一个游戏移植到另一个游戏,甚至为《玩具总动员2》这类轻量级游戏和《无主之地》《虐杀原形》等暴力游戏扩展玩法。
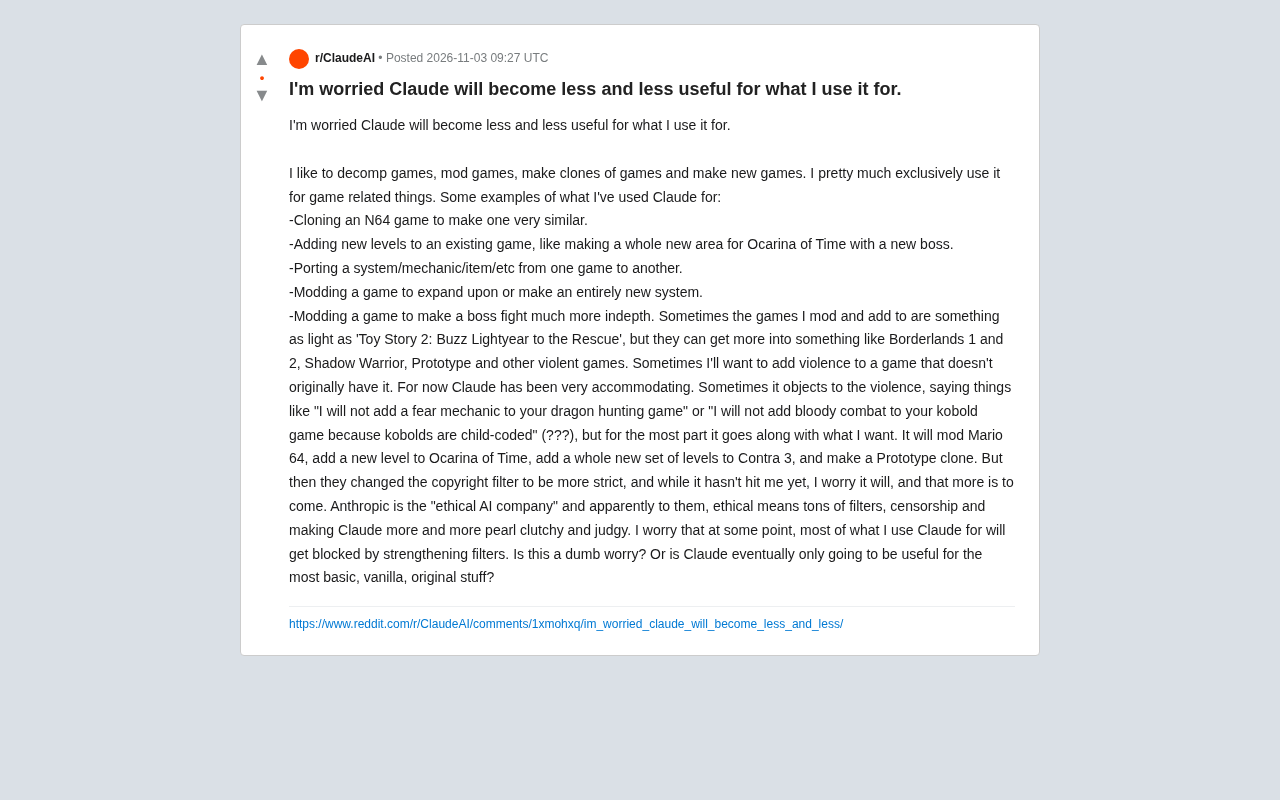
一个Mod开发者的日常:Claude在游戏改造中的实际角色
从帖子描述来看,这位用户的使用场景远不止“写点代码”那么简单。他让Claude克隆N64游戏、为现有游戏添加全新关卡、移植系统机制、扩展Boss战深度。这些任务涉及逆向工程、代码理解、跨引擎适配和创意设计,对模型的上下文理解能力和代码生成能力要求很高。
有意思的是,Claude在这些任务上“一直很配合”。用户提到,Claude会修改《超级马里奥64》、给《时之笛》加新关卡、为《魂斗罗3》增加整套新关卡,甚至制作《虐杀原形》的克隆。这说明在版权过滤收紧之前,Claude对这类游戏改造任务的处理相当宽容。
反编译(Decompilation) 是将已编译的二进制程序(如N64游戏ROM)逆向还原为高级语言源代码的过程。在游戏Mod社区中,经典做法是社区协作完成“反编译项目”,例如《超级马里奥64》和《塞尔达传说:时之笛》都有成熟的反编译代码库,使开发者能在原始逻辑基础上添加新关卡、新Boss或移植机制。这类工作需要对汇编、内存布局和引擎架构有深入理解,AI模型在此过程中的角色通常是辅助阅读代码、解释函数逻辑或生成适配代码。
当“伦理”变成过滤器:用户的真实焦虑
让这位用户不安的转折点,是Anthropic收紧了版权过滤。虽然目前他的具体用例还没有被直接拦截,但他担心这只是开始。
他写道,Anthropic是“伦理AI公司”,而在他看来,所谓的伦理意味着大量的过滤器、审查,以及让Claude变得越来越“爱管闲事”和“爱评判”。他描述了一些具体摩擦:Claude有时会拒绝他的请求,比如“我不会给你的猎龙游戏添加恐惧机制”,或者“我不会给你的狗头人游戏添加血腥战斗,因为狗头人是儿童编码的”——用户对这个理由显然一头雾水,连打了三个问号。
这些拒绝并不统一,大部分时候Claude还是会照做。但正是这种不确定性让用户焦虑:如果过滤器继续加强,他日常依赖的大部分工作流可能某天就突然不可用了。
内容过滤器(Content Filter) 是AI模型在生成回复前对请求和输出进行安全审查的机制,通常基于策略规则或分类器实现。Anthropic为Claude设定了“有用、诚实、无害”的宪法式AI原则,模型会依据这些原则拒绝某些请求。但原则是抽象的自然语言描述,模型在具体场景中的判断可能因上下文而异,导致同一类请求有时被接受、有时被拒绝。这种执行层面的不一致性,正是用户感到焦虑的根源:他们无法通过阅读公开政策来预判某个具体请求是否会被拦截。
版权与内容政策的边界在哪里
这位用户的困惑触及了一个真实的产品设计难题。游戏Mod社区长期存在于版权灰色地带,反编译、克隆、移植等操作在不同司法管辖区的法律地位并不一致。AI公司在面对这类请求时,需要在“帮助开发者实现创意”和“避免协助侵权”之间划线。
内容政策方面同样棘手。用户想给原本没有暴力的游戏添加暴力元素,或者给儿童向游戏加入更黑暗的机制,这类请求会触发模型的安全训练。Claude给出的拒绝理由有时显得随意甚至矛盾——狗头人为什么是“儿童编码的”,这很难从公开政策中找到对应条款。
从Anthropic的角度看,收紧过滤器可能是为了降低法律风险和维护品牌定位。但对一线创作者来说,政策的模糊性和执行的不一致性,比明确的禁止更让人不安。
版权灰色地带 在游戏Mod领域尤为突出。反编译本身在多数司法管辖区可能涉及侵犯复制权,但部分国家允许为互操作性、研究或教育目的进行逆向工程;克隆游戏机制则更复杂,玩法创意通常不受版权保护,但具体的代码、美术和音频素材受保护。AI公司在处理此类请求时,缺乏统一的法律标准可循,因此倾向于保守过滤。这种保守策略与Mod社区长期依赖的“先做再说”文化形成冲突,也是用户困惑的制度性背景。
工具依赖的风险:当你的工作流绑定在一个会变的模型上
抛开具体政策不谈,这个帖子暴露了一个更结构性的问题:当创作者把核心工作流建立在一个持续迭代的商业模型上时,模型的每一次策略调整都可能变成生产风险。
这位用户的使用场景高度垂直,几乎全部围绕游戏改造。一旦Claude的过滤器收紧到影响反编译或Mod相关请求,他并没有明显的替代方案——不同模型的内容政策、代码能力和上下文窗口差异很大,迁移成本不低。
他在帖子最后问:“这是不是多余的担心?还是Claude最终只会对最基础、最 vanilla、最原创的东西有用?”这个问题没有标准答案,但它值得每一个把AI工具嵌入深度工作流的开发者认真想一想。
模型版本迭代与策略漂移 是商业AI服务的固有特征。模型提供商会定期更新安全策略、调整拒绝阈值,甚至更换底层模型版本,而用户通常无法锁定旧版本或获得稳定的行为保证。对于将AI嵌入深度工作流的开发者而言,这意味着生产环境存在“策略性停机”风险——不是因为服务宕机,而是因为模型突然拒绝执行此前可用的任务。缓解这一风险的方式包括:保留本地开源模型作为备份、将关键工作流拆分为可替换的模块,以及记录模型拒绝模式以便提前调整请求表述。
多源视角下的共识与分歧
需要说明的是,以上分析主要基于这一条Reddit帖子,属于单一来源的用户体验叙述。帖子中提到的具体拒绝案例(猎龙游戏恐惧机制、狗头人血腥战斗)和版权过滤收紧的时间线,均来自用户个人描述,尚未得到Anthropic官方政策文档的交叉验证。
在AI社区中,关于模型内容过滤是否过度、拒绝理由是否一致的讨论一直存在,但不同用户的体验差异很大。这位用户的担忧是否具有普遍性,还需要更多开发者的实际使用反馈来佐证。可以确定的是,模型能力与内容政策之间的张力,正在成为AI编程工具用户必须面对的现实问题。
相关推荐

Claude Code实战指南:从零搭建专属AI编程助理
基于实战教程梳理Claude Code从环境搭建、国产模型切换到Git工作流与命令体系的完整路径,帮助开发者快速搭建专属AI编程助理,少走弯路。

Claude Sonnet 6疑泄露,Anthropic内部模型加速惊人
Anthropic疑似泄露Sonnet 6,Meter报告称其AI研发加速1.9倍;OpenAI发布GPT-6 Cyber,GPT-6.2 Astra或将至;Google Gemini Omni 1.2 Flash登顶视频生成榜;Meta stealth模型与实时头像亮相;市场波动下Google仍投170亿美元建数据中心。

科幻小说对AI的预测有多准?
科幻小说对AI的预测有多准?本文结合Hacker News讨论,分析科幻作品在AI发展中的远见与盲区,探讨其真正价值在于启发思考而非精准预测。