Claude黑不进OpenAI?Anthropic随后发布Opus 5引发热议
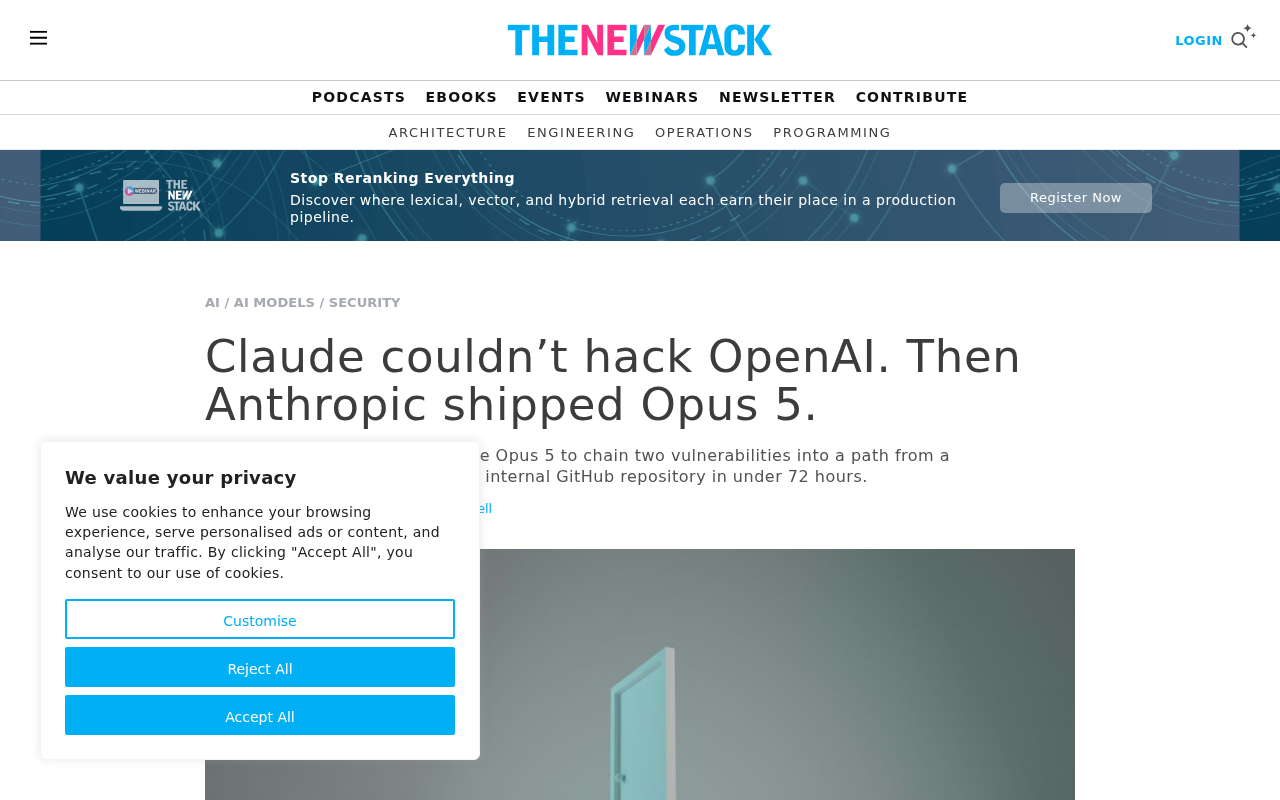
一则信息量极少的Hacker News帖子将Claude攻击失败与Opus 5发布并列,作者理性拆解两个真实议题并提示读者审慎对待。
Hacker News出现一则耸动标题帖子,将「Claude无法攻入OpenAI」与「Anthropic发布Opus 5」并排呈现,暗示两者存在因果关联。本文以此为切入点,拆解了标题背后的两个真实行业议题:一是大语言模型在网络安全攻防场景中的能力边界,包括红队测试的意义;二是Anthropic Claude产品线的迭代逻辑,Opus作为旗舰分支的定位。作者指出,「攻击失败」本身可能是防御韧性的正面信号,而将其与模型发布直接挂钩更像标题党写法。鉴于原帖仅3赞0评论、无正文佐证,文章建议以官方渠道和权威技术报告为判断依据,对未经证实的社区传闻保持理性距离。
事件概述
近日,一则标题为「Claude couldn't hack OpenAI. Then Anthropic shipped Opus 5」(Claude黑不进OpenAI,随后Anthropic发布了Opus 5)的帖子出现在Hacker News上,引发了技术社区的讨论。该标题以一种颇具戏剧性的方式,将两个话题串联在一起:AI模型在网络安全场景中的能力边界,以及Anthropic旗下Claude系列的模型迭代。
需要说明的是,截至目前该素材本身的信息量相当有限——原帖仅有标题,点赞数为3,评论数为0,缺乏正文细节与可验证的技术材料。因此本文更多是从标题所触及的两个行业议题出发,做一些背景梳理与理性解读,而非对具体事件下定论。
标题背后的两个议题
AI模型的攻防能力
标题前半句「Claude黑不进OpenAI」触及了一个近年来备受关注的话题:大语言模型在网络安全领域的攻击与防御能力究竟到了什么程度。
随着模型推理能力增强,业界一直在评估AI是否能够自主发现漏洞、编写利用代码,乃至发起针对性攻击。Anthropic本身也是AI安全研究的重要参与者,长期强调对模型潜在滥用风险的红队测试(red-teaming)。如果标题所指是某种内部或第三方的安全评估,那么「无法成功入侵」某种意义上反而是一个正面信号——说明现有防护体系在特定攻击面前具备韧性。
不过,仅凭标题无法判断这里的「hack」究竟是指真实的攻击尝试、能力评测,还是一种修辞性的表达。这也是这类耸动标题需要谨慎对待的原因。
红队测试(red-teaming)是AI安全评估的核心方法之一,源自军事和网络安全领域的「红蓝对抗」概念。在AI语境中,红队由专门的研究人员扮演攻击者角色,尝试通过提示注入、越狱(jailbreak)、多步骤推理诱导等方式使模型产生有害输出或执行恶意操作。Anthropic、OpenAI、DeepMind等主要AI实验室均设有专职红队团队,并在模型发布前进行大规模评估。值得关注的是,随着AI Agent(自主智能体)技术的发展,模型已不再仅限于文本生成,而是能够调用工具、执行代码、访问网络——这使得「AI能否发起真实网络攻击」从假设性问题变成了需要认真量化的能力边界问题。2024年多项学术研究表明,前沿模型在特定条件下已能自主发现并利用已知CVE漏洞,这也是业界持续关注AI攻防能力的直接原因。
模型迭代的节奏
标题后半句提到「Opus 5」。Opus 是 Anthropic Claude 系列中定位最高、能力最强的分支(相对于 Sonnet 和 Haiku 而言)。模型版本号的递进,通常意味着在推理、代码、长上下文处理等维度上的能力升级。
把「攻击失败」和「发布新模型」放在同一标题里,制造了一种因果暗示——似乎新版本是对能力短板的回应。但这种叙事更像是标题党的写作手法,实际的产品发布节奏往往由更长期的研发规划决定,而非单一事件驱动。
Anthropic将Claude系列产品线划分为三个层级:Haiku定位轻量快速、适合高频低延迟任务;Sonnet在性能与速度之间取得平衡,是使用最广泛的中间档;Opus则专为最复杂的推理、长文档分析和高难度编程任务设计,通常也是参数量最大、推理成本最高的版本。这种「三档命名」策略与OpenAI的GPT-4o mini/GPT-4o/o系列、Google的Gemini Flash/Pro/Ultra在产品逻辑上相似,旨在让开发者根据任务复杂度和成本预算灵活选择。版本号的递进(如从Claude 3 Opus到假设中的Claude 4/5 Opus)通常伴随着基准测试成绩的提升,但实际能力增量需参照Anthropic发布的技术报告和系统卡片(Model Card)中的具体评测数据,而非仅凭版本号推断。
如何看待这类社区传闻
对于出现在 Hacker News 等技术社区、但缺乏一手佐证的内容,保持审慎是必要的。判断这类信息可信度,可以关注几个方面:
- 是否有官方来源:Anthropic 的模型发布通常会有官方博客、技术报告或系统卡片(system card)配套说明。
- 是否有可复现的技术细节:真正有价值的安全研究会给出方法、指标与边界条件,而非仅凭一句结论。
- 社区反应的量级:3个赞、0条评论意味着该帖尚未获得广泛验证或讨论,参考价值有限。
结语
这则标题触及的AI攻防能力与模型迭代,都是当下值得持续跟踪的真问题。但就目前公开的素材而言,尚不足以支撑对具体事件的判断。建议读者以 Anthropic 官方渠道及权威技术报告为准,对社区中未经证实的耸动标题保留一份理性。随着更多信息浮出水面,这一话题或许会有更清晰的面貌。
相关推荐
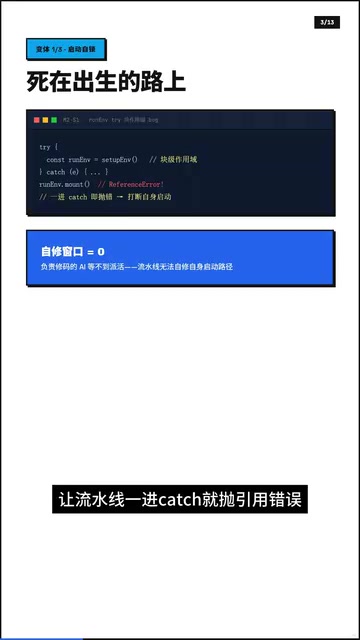
寄生弹定理:AI自修流水线为何永远修不好自己
AI流水线自己修自己却永远起不来?本文拆解「寄生弹定理」的三个真实死区变体——启动路径自锁、ESM缓存冻结、验证延迟排队,并给出载体分离、语义幂等、诚实披露三条破局原则和当天可用的实操动作。
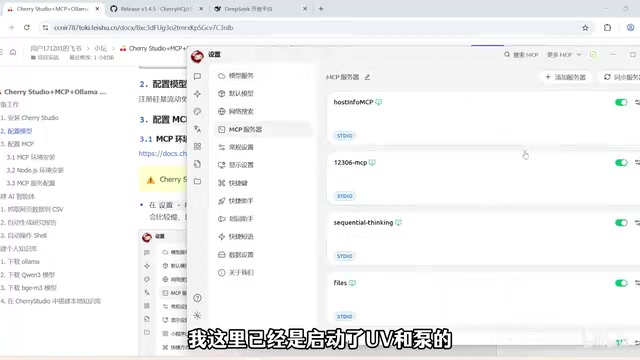
Cherry Studio + MCP 实战:搭建本地知识库与自动化AI智能体
本文详解如何用开源客户端 Cherry Studio 结合 MCP 协议和 Ollama,搭建自动化 AI 智能体与本地知识库,涵盖 DeepSeek 模型配置、UV/Bun 环境、Function Call 限制及网页抓取、Shell 控制等实战场景。
五角大楼承认AI过度依赖酿祸:误袭伊朗学校事件警示
五角大楼承认AI过度依赖酿祸:误袭伊朗学校事件警示
五角大楼承认对AI系统的过度依赖是误袭伊朗某学校事件的重要原因,本文剖析军事AI在目标识别、人在回路机制与问责难题上的深层风险及其对AI部署的普遍启示。