Claude托管智能体实战:自纠错+长期记忆
Anthropic演示用Claude托管智能体构建可自我纠错、具备长期记忆的研究智能体。
本文基于AI Engineer现场工作坊,梳理了Anthropic团队用Claude Managed Agents构建金融研究智能体的完整路径。内容从基础智能体与环境创建讲起,介绍基于SSE事件流的会话通信、子智能体委派与可迭代的技能系统;重点剖析Outcomes自监督机制——通过验证子智能体对照rubric自检并重试,提升长任务可靠性;随后说明共享记忆库与Dreaming功能如何实现跨会话知识积累。生产化方面,文章介绍Vaults按域名白名单在出口注入真实凭证的安全方案,以及用map-reduce式自定义编排和Deployments定时任务实现横向扩展。最后澄清了与Agent SDK的产品差异,并指出当前不支持会话回滚与内置预算控制等限制。
在AI Engineer的现场工作坊中,Anthropic团队演示了如何用Claude Managed Agents构建一个具备自我纠错与长期记忆能力的研究智能体。从基础对话到多智能体协作,再到自定义编排与定时任务,这套方案展示了托管智能体在金融研究场景下的完整落地路径。
从零搭建:环境、智能体与会话
演示的第一步是创建一个基础智能体。用户在控制台输入自然语言指令,Claude会自动生成系统提示、名称、描述并选择模型,随后通过API创建智能体与执行环境。环境本质上是沙箱的模板,开发者可以限制可访问的域名、预装Python包,为后续调用SEC EDGAR接口做好准备。
会话的通信通过事件流完成:前端发送user.message事件,后端监听SSE流并将智能体的响应实时推回浏览器。这套机制支撑了从简单聊天到长时间异步任务的所有交互。
SSE(Server-Sent Events) 是一种基于 HTTP 的服务器推送技术,允许服务端在单个长连接上持续向客户端发送文本格式的事件流。与 WebSocket 的双向通信不同,SSE 是单向的(服务器→客户端),但实现更简单、天然支持断线重连,且可直接复用现有的 HTTP 基础设施。在智能体场景中,智能体执行任务可能耗时数秒到数分钟,并产生多个中间事件(工具调用、思考过程、最终输出)。前端通过 SSE 订阅这些事件,就能实时渲染进度,而不必轮询或阻塞等待完整响应。这正是文中“后端监听 SSE 流并将智能体的响应实时推回浏览器”得以支撑长时间异步任务的技术基础。
sec edgar 是美国证券交易委员会(SEC)官方的电子数据收集、分析与检索系统,所有在美国上市的公司都必须通过它提交财报(10-K、10-Q)、重大事项(8-K)等披露文件。EDGAR 提供免费的公开 API 和全文检索接口,是金融研究中最权威、最结构化的数据源之一。文中预装 Python 包并限制可访问域名,正是为了让智能体能够安全地调用 EDGAR 接口拉取原始披露文件,作为后续财务提取与分析的输入。
多智能体协作与技能系统
基础智能体只有提示和默认工具。工作坊的第二步是给它“升级”:添加调用SEC的技能、定义子智能体、引入自定义工具dispatch analysis。主智能体可以委派任务给金融分析、风险提取等专业子智能体,也可以生成自身的副本处理未知任务。
说个细节,子智能体不会继承主会话的完整对话记录,只复制工具描述、模式和提示。这种设计避免了上下文膨胀,同时保留了任务所需的能力。
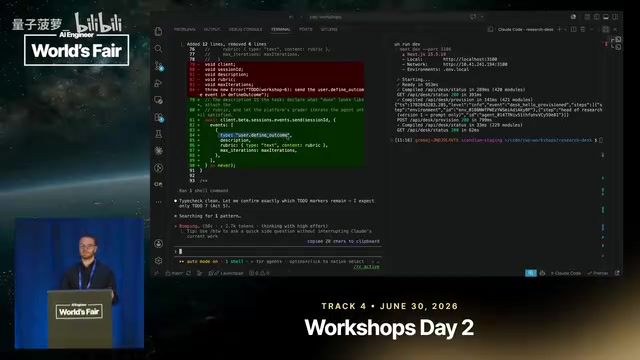
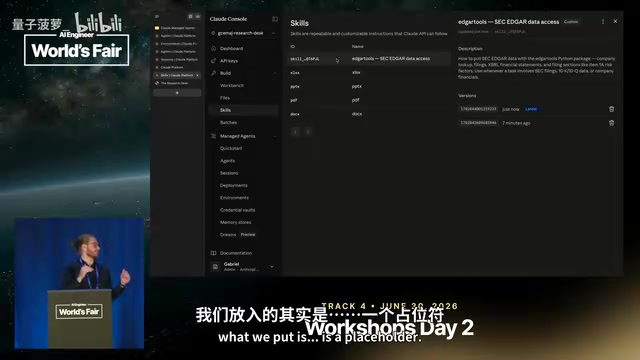
技能是可更新的活产物。演示中团队新增了对新表单类型的支持,此后引用该技能的新会话都会自动获得更新。这种机制让智能体能力可以持续迭代,而不需要重建整个系统。
rubric(评估量表) 在此处指一套由用户预先定义的结构化验收标准,通常包含若干检查项及其通过条件,例如“营收数字与原文一致”“风险点覆盖不少于三项”“输出为指定 JSON 结构”。它把模糊的“做得好不好”转化为可被验证子智能体逐条核对的明确规则,是 Outcomes 机制能够自动化判定的前提。rubric 的质量直接决定自我纠错的效果:标准过松则错误漏检,过严则触发无效重试。实践中建议将 rubric 写成可客观验证的断言,而非主观描述。
map-reduce 模式 源自分布式计算,核心思想是先把大任务拆成相互独立的子任务并行处理(map),再把各子任务的结果汇总合并(reduce)。文中主智能体将每个分析标的分配到一个独立会话,正是 map 阶段——各会话互不共享上下文,可并行推进;全部完成后由主智能体聚合为统一报告,即 reduce 阶段。这种模式的优势在于横向扩展性好、单点失败不影响整体,但也要求子任务之间尽量无依赖,且聚合层需要处理结果格式不一致、部分失败等边界情况。
自我纠错:Outcomes机制
工作坊的核心亮点是Outcomes——一种自监督机制。用户定义任务、评估标准(rubric)和最大迭代次数,智能体执行任务后,会启动一个验证子智能体对照标准检查产出。如果不达标,智能体会重试,直到满足要求。
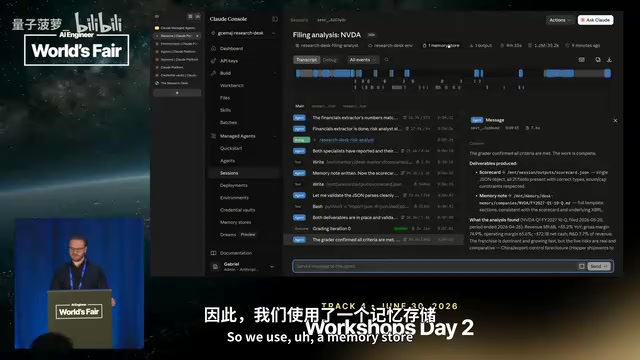
在NVIDIA财报分析演示中,主智能体先检查记忆库是否有历史分析,再调用子智能体分别做财务提取和风险评估,最终生成结构化记分卡并更新记忆。验证子智能体确认数字准确、交付物完整后,任务才被标记为完成。这相当于让智能体具备了“交卷前自查”的能力,显著提升了长任务的可靠性。
记忆共享与Dreaming进化
多会话共享的记忆库是这套方案的另一个关键。不同会话可以写入和读取关于金融工具的知识,避免重复研究。更进一步,Dreaming功能会分析跨多个会话的转录和记忆,自动整合更新记忆库,让后续智能体能获取更准确的信息。
团队提到,目前Dreaming仅作用于记忆存储,未来可能扩展到技能、提示和智能体定义。这意味着智能体系统有望实现持续学习:每次运行都在为下一次积累经验。
生产级安全:Vaults与凭证注入
演示中SEC凭证直接放在提示里,但生产环境需要更安全的方案。Vaults允许开发者定义密钥,会话中只注入占位符,只有在访问预先允许的域名时,平台才会在出口处替换为真实凭证。如果智能体试图将密钥用于未授权域名,替换不会发生。
Vaults同时支持OAuth凭证和MCP认证,可以打包Notion等服务的授权。对于不希望暴露到公网的MCP服务,平台提供MCP隧道功能;如果企业需要完全掌控网络边界,还可以接入自托管沙箱。
mcp(Model Context Protocol) 是 Anthropic 提出的开放协议,用于让模型以标准化方式连接外部工具与数据源。MCP 服务端暴露一组工具和数据资源,客户端(如智能体运行时)按协议发现并调用它们,从而避免为每个集成单独编写适配代码。文中提到 Vaults 可打包 Notion 等服务的 MCP 认证,以及为不暴露公网的 MCP 服务提供隧道,说明 MCP 已成为该平台扩展能力的主要接口形式;替换记忆提供方时需自行构建 MCP 或自定义工具,也印证了这一点。
OAuth 凭证 指基于 OAuth 2.0 授权框架获取的访问令牌,它让第三方应用在用户授权下访问其资源,而不必共享账号密码。与静态 API Key 相比,OAuth 令牌通常带有作用域限制和有效期,可被刷新和撤销,泄露风险更低。Vaults 同时支持 OAuth 与普通密钥,意味着平台能够在出口处统一管理不同认证形态,并按域名白名单决定是否注入,从而在保持便利性的同时收敛凭证暴露面。
自定义编排与定时任务
当需要同时分析10个或100个标的时,单会话串行处理效率不足。工作坊展示了利用dispatch analysis工具构建自定义编排层:主智能体将每个标的分配到一个独立会话,全部完成后聚合结果。这种map-reduce模式让托管智能体可以横向扩展。
最后,Deployments API支持按计划运行会话,适合需要定期更新的长期分析。结合记忆库,智能体可以在数周甚至数月的时间跨度内持续跟踪标的动态。
架构选择与限制
现场问答澄清了几个关键问题。托管智能体的harness受Claude Code启发但为通用场景重新构建,与Agent SDK是不同产品:后者是可下载的二进制文件,前者是包含托管、沙箱管理、扩展和事件日志存储的全托管服务。
当前平台不提供会话回滚或分叉功能,用户只能通过新事件引导智能体,不能回到历史节点重试。预算控制也尚未内置,需要开发者在编排层自行实现。此外,平台不绑定记忆存储,数据可通过API导出,但替换记忆提供方需要自行构建MCP或自定义工具。
整体来看,这套方案把智能体的基础设施复杂度封装起来,让开发者聚焦于编排逻辑和业务价值,同时通过Outcomes和Dreaming在可靠性与持续学习上提供了可落地的机制。
相关推荐
VCP V工程实测:Token缓存95%命中,AI控制AI螺旋编程
VCP V工程实测:单轮对话Token缓存命中率95%以上,用AI控制AI实现螺旋编程,主控Agent策划、施工Agent写码,已策划工程可完全脱手。附完整配置步骤与局限分析。
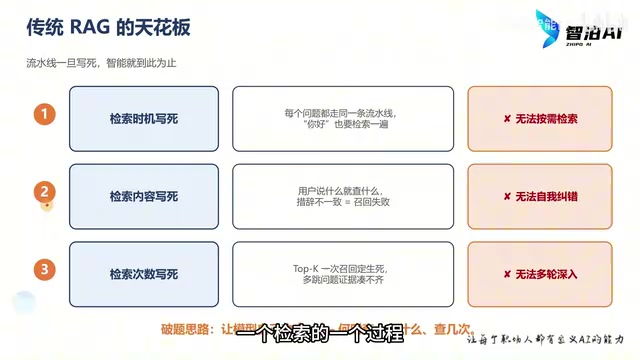
Agentic RAG实战:从原理到代码,手把手搭建智能检索系统
传统RAG检索时机、内容、次数全部写死,导致答非所问。本文基于B站教程拆解Agentic RAG原理:将检索封装为工具交给大模型自主决策,附四工具设计与完整代码实现,手把手搭建能自我纠错、多跳查询的智能检索系统。
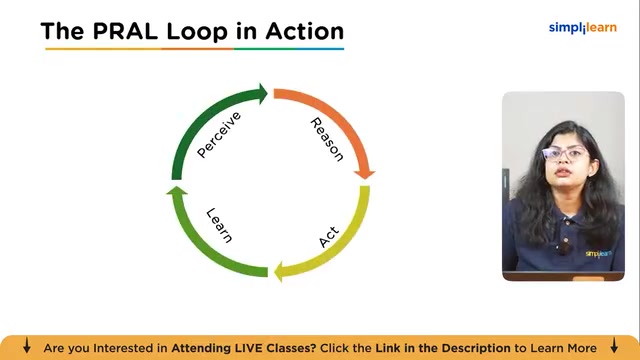
1小时搞懂Agentic AI:架构、设计模式与实战搭建
Simplilearn的Agentic AI速成课程解析:智能体三层架构(感知、认知、动作)、单智能体与多智能体对比、感知推理执行学习循环、三种设计模式,以及研究智能体、应用构建和反馈修复循环的实战演示。