Cline CLI v3.0.75 发布:单次运行默认启用 yolo 模式

Cline CLI v3.0.75 将单次运行默认改为 yolo 模式,并修复中断、读取截断与推理参数兼容性。
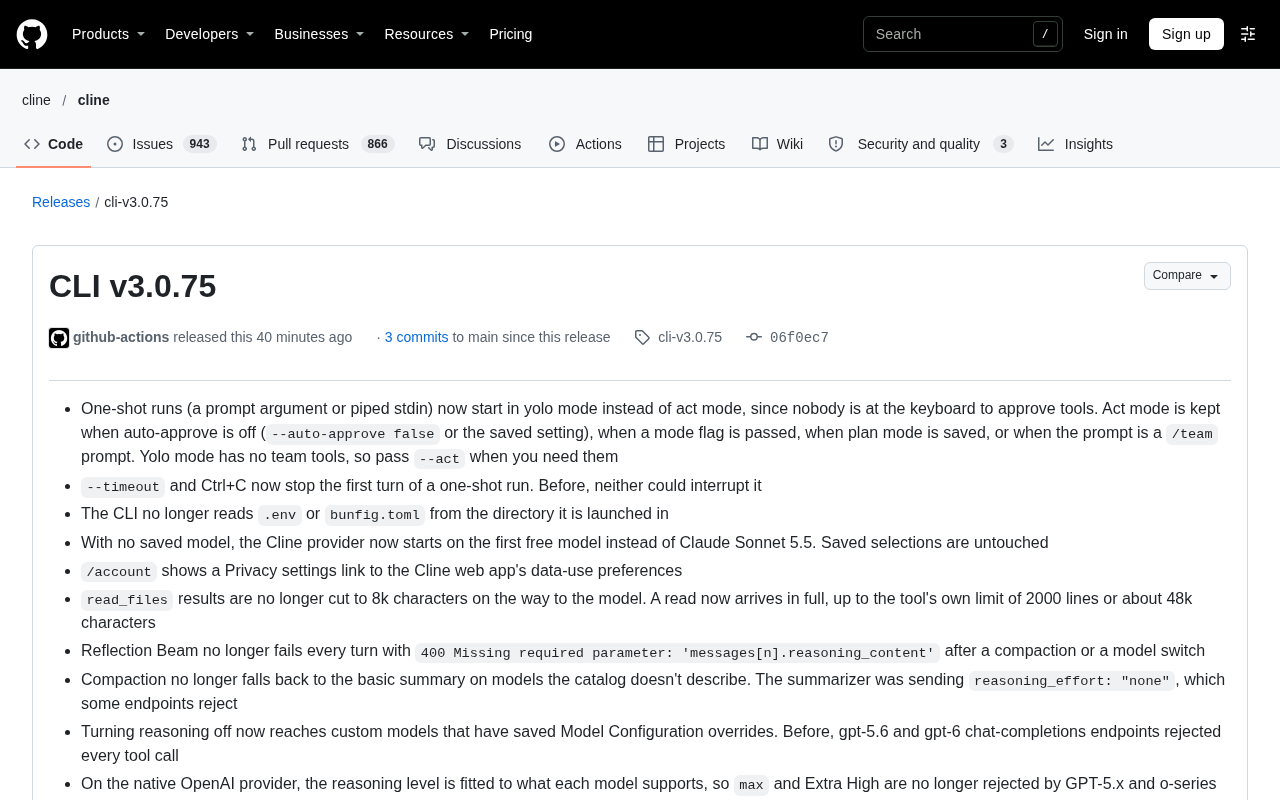
Cline CLI v3.0.75 的核心改动是单次运行(直接传 prompt 或管道 stdin)默认从 act 模式切换为 yolo 模式,避免无人审批时流程卡死,但在关闭自动批准、显式传 mode 标志、保存 plan 模式或使用 /team prompt 时仍回退到 act。同时修复了 --timeout 与 Ctrl+C 无法中断首轮对话的问题,CLI 不再读取工作目录的 .env 与 bunfig.toml。默���模型改为从第一个免费模型起步,并修复了一批 reasoning 参数 bug,涉及 Reflection Beam 的 reasoning_content 报错、压缩回退、自定义模型推理开关传递与 OpenAI 推理级别适配。read_files 不再被截断到 8k 字符,模型目录新增 94 个 provider。整体改动集中在让非交互调用更可靠。
单次运行默认进入 yolo 模式
Cline CLI v3.0.75 的核心变化集中在一处行为逻辑上:单次运行(one-shot run)现在默认从 act 模式切换到 yolo 模式。这里的单次运行指的是直接传入 prompt 参数,或者通过管道传入 stdin 的调用方式。
理由很直接——单次运行时没有人在键盘前审批工具调用,act 模式要求逐次确认的机制反而会让整个流程卡死。yolo 模式跳过审批,让一次性任务能够跑完。
不过团队保留了多个回退路径,以下情况仍会停留在 act 模式:关闭了自动批准(--auto-approve false 或保存的设置),显式传入了 mode 标志,保存的模式为 plan,或者 prompt 是一个 /team prompt。由于 yolo 模式不包含 team 工具,需要用 team 能力时得手动加 --act。
这是一个典型的"默认值即产品决策"的改动。CLI 工具在非交互场景下被脚本和 CI 频繁调用,默认值选错会让自动化流程直接失败,选对则能让开箱体验顺畅不少。代价是安全边界的收紧需要用户自己把握。
act 模式与 yolo 模式代表 CLI 工具对工具调用(tool call)审批的两种策略。act 模式要求每次模型发起文件读写、命令执行等操作时都需人工确认,适合交互式会话;yolo 模式(源自 "you only live once")则跳过审批直接执行,适合无人值守场景。这种二元设计在 agent 类工具中很常见——安全性与自动化程度之间存在直接权衡。yolo 模式的风险在于模型可能执行破坏性操作(如误删文件、运行危险命令),因此通常配合沙箱、只读挂载或版本控制使用。Cline 将默认值从 act 改为 yolo,本质是承认 CLI 的主流使用者是脚本与 CI 而非人类逐条点击。
中断机制与启动环境的调整
超时与 Ctrl+C 真正生效
此前 --timeout 和 Ctrl+C 都无法打断单次运行的第一轮对话,这在长任务里是个明显的痛点。v3.0.75 修复了这一点,两者现在都能在首轮就中止执行。
不再读取工作目录的配置文件
CLI 不再从启动目录读取 .env 或 bunfig.toml。这一改动减少了隐式配置来源,行为更可预测,但也意味着依赖这些文件注入环境变量的旧工作流需要显式传递配置。
模型选择与推理参数修复
默认模型逻辑变化
在没有保存模型的情况下,Cline provider 现在从第一个免费模型起步,而不再默认使用 Claude Sonnet 5.5。已保存的模型选择不受影响。
修复一批推理参数问题
这个版本处理了多个围绕 reasoning 参数的 bug:
- Reflection Beam 在压缩或切换模型后每轮都会报
400 Missing required parameter: 'messages[n].reasoning_content',现已修复。 - 压缩流程不再在目录未描述模型的情况下退回基础摘要——原因是摘要器发送了
reasoning_effort: "none",部分端点会直接拒绝。 - 关闭推理的设置现在能正确传递到保存了 Model Configuration 覆盖的自定义模型。此前 gpt-5.6 和 gpt-6 的 chat-completions 端点会拒绝所有工具调用。
- 原生 OpenAI provider 会把推理级别适配到各模型支持的范围,GPT-5.x 和 o-series 不再拒绝
max与 Extra High。 - LiteLLM 场景下,当模型报告
max_output_tokens时,不再把旧版max_tokens当作输入预算使用。
这一类修复的共性是:推理参数在不同 provider、不同模型间的映射并不统一,任何一处硬编码假设都可能在换模型时暴露。
reasoning_content 与 reasoning_effort 是推理模型(如 OpenAI o 系列、DeepSeek广告 推理版本)的专有参数。reasoning_content 用于在多轮对话中回传模型上一轮的思维链内容,部分端点要求 assistant 消息必须携带该字段,缺失即返回 400;reasoning_effort 则控制推理深度(如 low/medium/high),取值 "none" 表示关闭推理。问题在于不同 provider 对这些字段的接受度不一致:有的严格要求回传,有的完全拒绝,有的对 effort 取值有白名单。Cline 的多个 bug 都源于把某一 provider 的假设硬编码到通用路径上,切换模型或经过压缩/目录未描述等边缘情况时便暴露出来。
读取、安全与实验特性
read_files 不再截断
read_files 的结果不再在送往模型的路上被砍到 8k 字符。一次读取现在完整到达,上限由工具自身决定——2000 行或约 48k 字符。对需要通读文件的任务来说,这减少了因截断导致的重复读取和上下文缺失。
工具输出截断是 agent 框架控制上下文窗口的常见手段。read_files 此前把结果砍到 8k 字符,是为了防止单个文件占满 token 预算,但代价是模型只能看到片段,容易触发重复读取或基于不完整内容做出错误判断。改为由工具自身限制(2000 行或约 48k 字符)意味着上限从"传输层"下移到"工具层",语义更清晰:工具负责定义单次读取的合理边界,模型据此决定是否分页。48k 字符大致对应 12k–16k tokens(按英文估算),对多数源码文件已足够完整,同时仍在主流模型的上下文窗口内。
安全与清理
移除了 CLINE_CAPTURE_* 调试变量,此前它们会把完整的 provider 请求体写入磁盘。undici 升级到 7.30.1,修复两个会导致进程崩溃的问题。各平台包现在附带 THIRD_PARTY_NOTICES.txt。
实验性云端会话
设置 CLINE_CLOUD_SESSIONS=1 可在 TUI 中通过 Cline Cloud 运行任务。Ctrl+O 切换 Local/Cloud,Ctrl+K 选择仓库和分支,/model 选择云端模型。这仍标注为实验特性。
模型目录大幅刷新
模型目录新增来自 models.dev 的 94 个 provider,同时移除 Lilac 和 Tempr。Cline 推荐列表加入 Muse Ember;免费列表移除 Reflection Beam、Laguna S 2.1 和 Solar Mini 4;ClinePass 移除 DeepSeek V4.1 Flash、Mimo V2.6 Flash、Mimo V2.6 Pro、MiniMax M3、Qwen3.7 Plus 和 Qwen3.7 Max。另有 67 个其他 provider 的默认模型发生变化,多数指向 Kimi K3.1 Pro、Gemini 4 Neon(含 gemini 与 vertex provider)或 DeepSeek V4.1 Flash 1017。
/account 新增了一个 Privacy settings 链接,指向 Cline 网页应用的数据使用偏好设置。
从版本节奏看,这次的改动密度不低,且集中在"让非交互调用更可靠"这条主线上——默认模式、中断能力、读取完整性、推理参数兼容性,都在服务同一个目标。
相关推荐

ClawDOS:为DOS系统注入AI编程能力
ClawDOS是一个面向DOS系统的AI编程代理项目,探索在资源受限的复古计算环境中引入AI编码辅助的可能性,本文分析其定位、使用场景与社区反响。

Baseten发布Bison-1与Groundhog-1登顶决策模型榜
Baseten发布基于Gemma 4的开放权重决策模型bison-1和groundhog-1,bison-1在AA Decision Index v2.1上得分76登顶,两款模型均支持128k上下文与图像输入,本文分析其能力组合、基准含义与开发者选型建议。
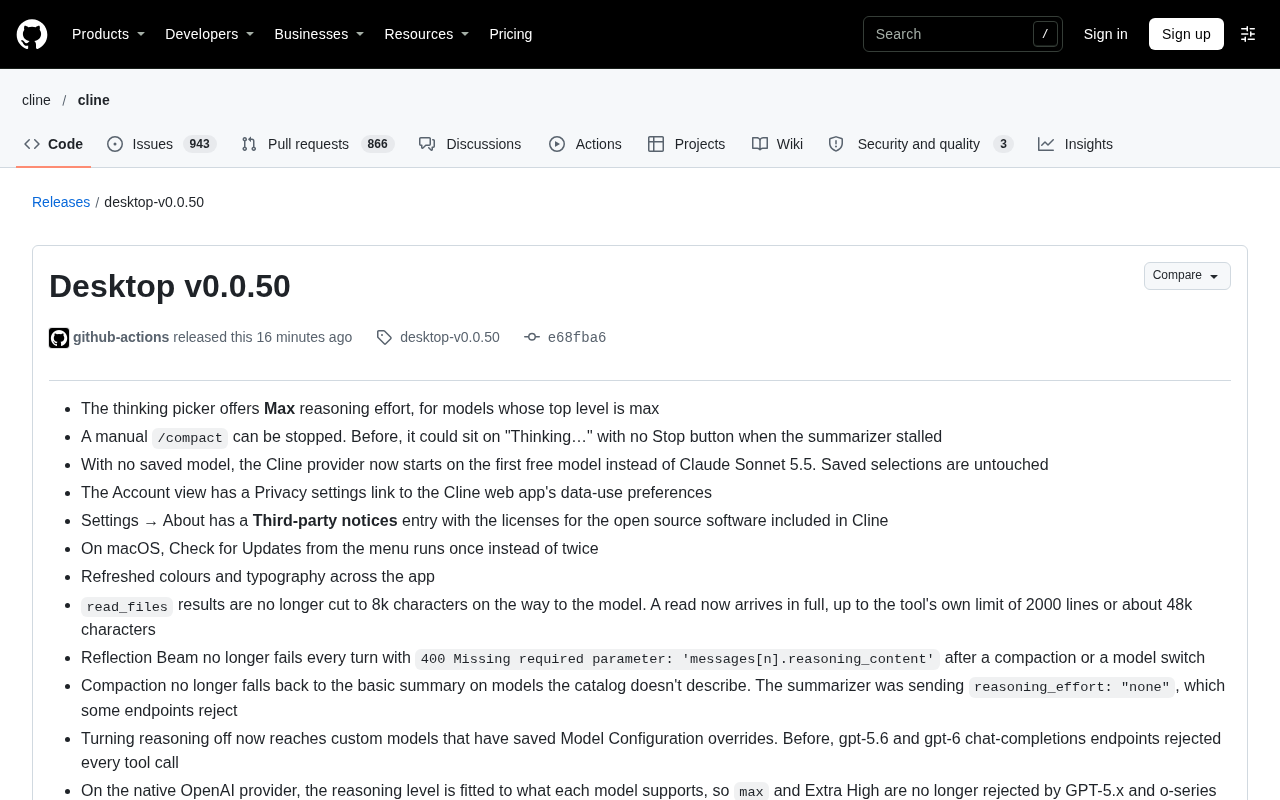
Cline Desktop v0.0.50 更新:模型目录重构与推理控制修复
Cline Desktop v0.0.50 发布,修复 Reflection Beam 400 错误、推理参数误传与压缩卡死问题,read_files 不再截断至 8k 字符,模型目录新增 94 个 provider 并调整 67 个默认模型。