Cline Desktop v0.0.50 更新:模型目录重构与推理控制修复
Cline Desktop v0.0.50 修复推理参数链路并重构模型目录,新增 94 个 provider。
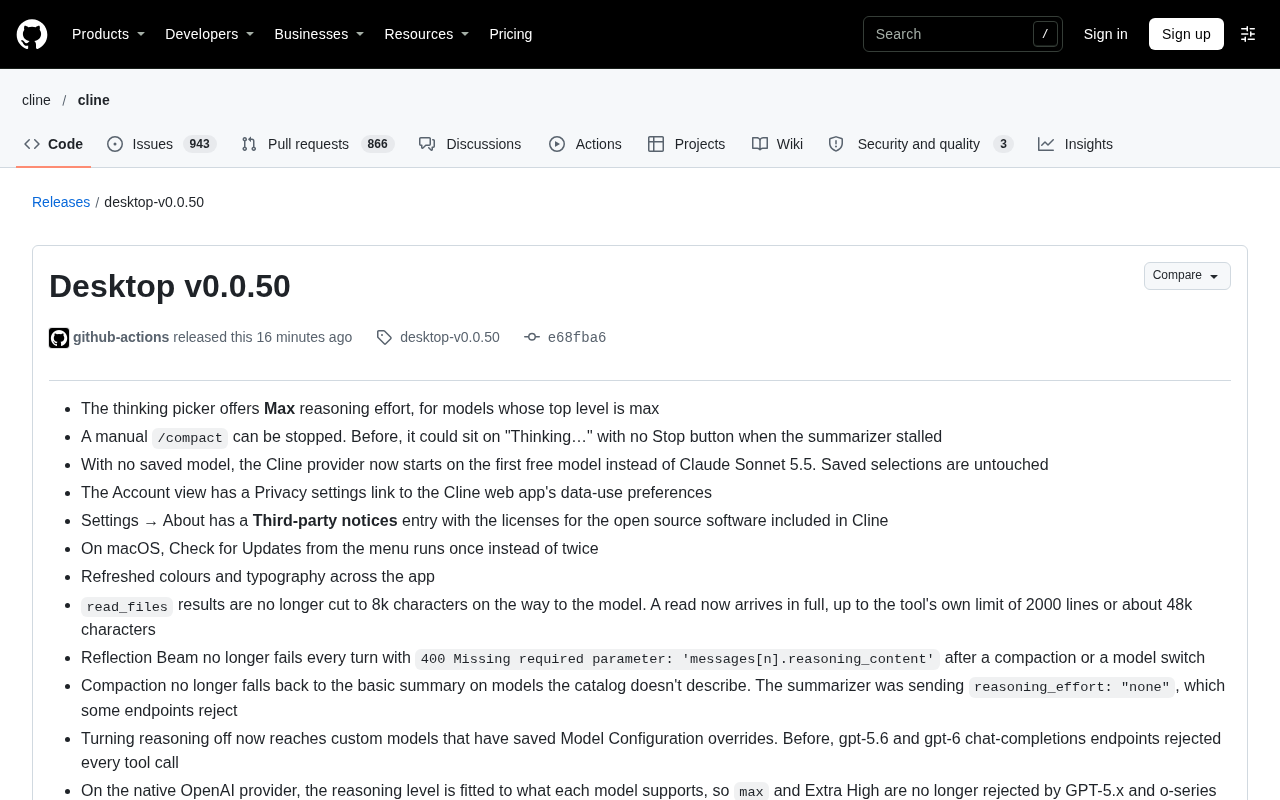
Cline Desktop v0.0.50 是一次以修复为主、目录重构为辅的版本。推理链路上,思考档位新增 Max reasoning effort,手动 /compact 支持中止;同时修复了 Reflection Beam 每轮 400 错误、压缩流程误发 reasoning_effort: "none" 导致端点拒绝、自定义模型关闭推理设置失效,以及 GPT-5.x 与 o-series 在原生 OpenAI provider 上拒绝 max 档位等问题,LiteLLM 的 max_tokens 误用也一并纠正。读取侧,read_files 结果不再截断到 8k 字符,上限提升至 2000 行或约 48k 字符。模型目录新增来自 models.dev 的 94 个 provider,移除 Lilac 与 Tempr,67 个 provider 默认模型迁移至 Kimi K3.1 Pro、Gemini 4 Neon 或 DeepSeek V4.1 Flash 1017。合规方面补充了隐私设置与第三方许可证入口。
Cline Desktop v0.0.50 更新:模型目录重构与推理控制修复
Cline 桌面端发布 v0.0.50 版本,这次更新的重点不在花哨的新功能,而在于修复推理链路中长期存在的几处顽固问题,同时对模型目录做了一次大规模重构。对于频繁切换模型、依赖长上下文读取、或在自定义端点下使用推理模型的开发者来说,这版更新解决了不少实际痛点。
推理控制链路的系统性修复
Max 推理档位与手动压缩的可中断能力
思考档位选择器(thinking picker)新增了 Max reasoning effort 选项,专门面向那些顶层档位就是 max 的模型。此前这类模型在界面上无法表达其最高推理强度,现在可以显式选择。
另一个体验层面的修复是手动 /compact 现在可以被中止。在此之前,当摘要器卡住时,界面会一直停留在“Thinking…”状态且没有 Stop 按钮,用户只能被动等待。这个问题的修复虽然不起眼,但对长时间会话的可用性影响明显。
/compact 是编码代理类工具中常见的斜杠命令,作用是把冗长的对话历史交给一个“摘要器”模型压缩成简短摘要,从而腾出上下文窗口继续工作。由于压缩本身是一次完整的模型调用,它可能耗时数十秒甚至更久,也可能因端点限流或参数不兼容而卡死。若该过程没有取消机制,整个会话就会阻塞在等待状态,用户既不能继续对话也无法回退,只能重启会话、丢失上下文。为长耗时操作提供中止能力(abort)因此是这类工具的基本可用性要求,其实现通常依赖请求层的取消信号传递,把 UI 上的 Stop 按钮与底层网络请求的生命周期绑定起来。
修复 400 错误与推理参数误传
这次更新集中处理了几类会导致请求直接失败的参数问题。Reflection Beam 在压缩或切换模型后,每一轮都会因 400 Missing required parameter: 'messages[n].reasoning_content' 而失败,现已修复。压缩流程也不再对目录未描述的模型回退到基础摘要——原因是摘要器发送了 reasoning_effort: "none",而部分端点拒绝接受该值。
关闭推理的设置现在能正确传递给带有已保存 Model Configuration 覆盖项的自定义模型。此前 gpt-5.6 和 gpt-6 的 chat-completions 端点会拒绝所有工具调用。在原生 OpenAI provider 上,推理等级会按各模型实际支持的能力进行适配,因此 GPT-5.x 和 o-series 模型不再拒绝 max 和 Extra High 档位。
LiteLLM 相关的一处修复是:当模型上报 max_output_tokens 时,不再把遗留的 max_tokens 字段当作输入预算使用。这类参数混用问题往往难以在日志中定位,修复后有助于避免上下文预算计算错误。
reasoning_effort 是 OpenAI 推理模型(o-series、GPT-5 系列)引入的请求参数,用于在 minimal/low/medium/high 等档位间调节模型投入的思考量,部分厂商还扩展出 none、xhigh 等取值。关键在于这个参数并非所有端点都兼容:OpenAI 原生接口、兼容层(如 LiteLLM)和第三方自建网关对合法取值、参数名称与是否允许空值的校验各不相同,因此同一个请求在不同 provider 上可能一个成功、一个返回 400。reasoning_content 则是部分推理模型在响应中返回的思考过程字段,一些网关要求在多轮对话中把历史轮次的该字段回传给服务端,缺失时会报 Missing required parameter。这类错误的共同特点是只在特定模型与特定端点的组合下复现,因而往往在发布后很久才被发现。
读取、文件与本地化体验
read_files 的结果在送往模型途中不再被截断到 8k 字符。现在一次读取会完整送达,上限取决于工具自身的限制——2000 行或约 48k 字符。对于需要分析大文件的场景,这意味着不必再分段调用或忍受信息丢失。
macOS 上从菜单执行 Check for Updates 现在只运行一次而非两次,避免重复触发更新检查。整体界面的配色和排版也做了刷新,属于视觉层面的常规迭代。
模型目录大改:94 个新 provider 与默认模型迁移
模型目录的刷新是本次更新中影响面最大的改动。新增了来自 models.dev 的 94 个 provider,同时移除了 Lilac 和 Tempr。Cline 推荐列表加入 Muse Ember;免费列表移除了 Reflection Beam、Laguna S 2.1 和 Solar Mini 4;ClinePass 则移除了 DeepSeek广告 V4.1 Flash、Mimo V2.6 Flash、Mimo V2.6 Pro、MiniMax M3、Qwen3.7 Plus 和 Qwen3.7 Max。
另有 67 个 provider 的默认模型发生变化,主要迁移到 Kimi K3.1 Pro、Gemini 4 Neon(包括 gemini 和 vertex provider)或 DeepSeek V4.1 Flash 1017。对于依赖默认配置的用户,升级后需要留意实际调用的模型是否发生变化。
没有保存模型时,Cline provider 现在会从第一个免费模型启动,而不是 Claude Sonnet 5.5;已保存的选择不受影响。
models.dev 是一个社区维护的模型与提供商元数据目录,汇总各家模型的价格、上下文窗口、最大输出长度、支持的模态与能力标记(如是否支持工具调用、推理档位)。许多客户端工具把它作为模型清单的上游数据源,以避免手动维护上百个 provider 的规格。使用这类外部目录的好处是模型上新速度快、字段标准化;代价则是上游条目的描述质量参差不齐,某些模型缺少能力标注,客户端在做参数决策时就容易“猜错”——这也正是本次更新中“目录未描述的模型回退到基础摘要”这类问题的根源。当模型未在目录中标注推理能力时,客户端需要有明确的兜底策略,而不是发送一个可能被拒绝的默认值。
隐私与合规入口补齐
Account 视图新增了 Privacy settings 链接,指向 Cline Web 应用的数据使用偏好设置。Settings → About 中新增了 Third-party notices 条目,列出 Cline 所含开源软件的许可证。这两项改动偏向合规与透明度,对需要审计依赖或管理数据偏好的团队用户有实际价值。
升级建议
使用自定义端点或 LiteLLM 的用户应优先升级,本次修复直接关系到工具调用能否成功。使用 GPT-5.x、o-series 或推理模型的用户也会受益于推理档位的适配逻辑。依赖默认模型的用户则建议升级后检查一次实际生效的模型,确认是否符合预期。
相关推荐

ClawDOS:为DOS系统注入AI编程能力
ClawDOS是一个面向DOS系统的AI编程代理项目,探索在资源受限的复古计算环境中引入AI编码辅助的可能性,本文分析其定位、使用场景与社区反响。

Baseten发布Bison-1与Groundhog-1登顶决策模型榜
Baseten发布基于Gemma 4的开放权重决策模型bison-1和groundhog-1,bison-1在AA Decision Index v2.1上得分76登顶,两款模型均支持128k上下文与图像输入,本文分析其能力组合、基准含义与开发者选型建议。

Cline CLI v3.0.75 发布:单次运行默认启用 yolo 模式
Cline CLI v3.0.75 发布:单次运行默认切换为 yolo 模式,--timeout 与 Ctrl+C 可中断首轮,read_files 不再截断到 8k 字符,并修复多项推理参数兼容问题、刷新模型目录新增 94 个 provider。