Cloudflare 200 OK 泄漏事件:155次回答串数据

Cloudflare 事故揭示:状态码 200 的模型回复可能读取了他人残留数据。
Cloudflare 报告披露,8 月 27 日至 9 月 9 日期间,Workers AI 平台上 GLM 5.3 模型的 155 条回复包含其他客户数据,且状态码均为 200。根因不在模型或开发方 z.ai,而在推理引擎 SGLang 的共享内存管理:窗口承诺约百万级 token,实际 KV 池仅容纳 681,280 个 token;split-prefill-decode 模式在超长提示下用单 token 占位符继续执行,仅第一页被写入,其余页保留先前请求的残留数据并被模型读取。Cloudflare 40 分钟内下线模型、当天修复,建议升级 SGLang 0.5.22 以上并比对 KV 池与上下文长度。事件核心警示是错误被包装成成功,验证输出不能只看状态码,应注入 canary 文本确认内容来自本次请求。
给 AI 接口返回 200,真的代表一切正常吗?Cloudflare 用一次事故给出了否定答案:155 次看似正常的模型回答,实际上读的是其他用户留在共享显存里的数据。
据 Cloudflare 在 10 月 26 日发布的报告,8 月 27 日至 9 月 9 日期间,其 Workers AI 平台上 GLM 5.3 模型的 155 条回复包含了其他客户的数据。该事件由 Gnostic 的研究员 Gadi Evron 报告。报告由工程高级经理 Kevin Flansburg 和 Michelle Chen 撰写,并与 SGLang 的官方说明同日发布。
事故链条:从缓存复用到“假成功”
问题的根源不在模型,也不在开发方 z.ai,而在推理引擎对共享内存的管理方式。
KV 缓存:不会自动擦除的“工作记忆”
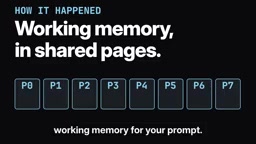
KV 缓存是模型处理提示词时的工作记忆,存放在可复用的共享 GPU 内存页中。正常情况下,引擎会记录每一页属于谁,用完后覆盖或隔离。但这次,窗口承诺支持约百万级 token,底层内存实际只能容纳 681,280 个 token。系统清楚这个差距,也预期在超长提示时返回错误。
KV 缓存(Key-Value Cache)是 Transformer 类模型在自回归生成时的一项核心优化机制。模型每生成一个 token,都要对之前所有 token 计算注意力,若不缓存,计算量会随序列长度呈平方级增长。KV 缓存把每一层注意力计算中已产生的 Key 和 Value 张量保存下来,使新 token 只需与缓存中的历史状态做一次注意力运算,从而将生成阶段的复杂度降到线性。代价是显存占用随上下文长度线性上升:序列越长、层数越多、隐藏维度越大,缓存就越大。推理框架通常以固定大小的“页”(page)为单位管理这块显存,类似操作系统的虚拟内存分页,页可被不同请求复用。正因为页会被复用,框架必须严格追踪每一页的归属与生命周期;一旦归属记录缺失或复用逻辑出错,新请求就可能读到上一请求残留的 Key/Value,从而在输出中泄漏他人数据。这也是本次事故在机制层面的关键所在。
一个 token 的“占位符”绕过了报错
SGLang 的 split-prefill-decode 模式在遇到超长提示时,把过长的输入替换成一个单 token 的占位符,然后继续向下传递。结果只有第一页被写入,其余内存页保留着先前请求留下的内容,模型在读取这些残留数据的同时生成了回答。
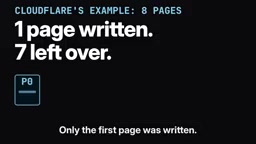
split-prefill-decode(预填充与解码分离)是 SGLang 为提升吞吐而设计的一种调度模式。传统推理把“读入整段提示词”(prefill)和“逐 token 生成”(decode)放在同一实例上完成;分离模式下,prefill 与 decode 可被拆分到不同节点或不同批次执行,以便分别优化计算密集与访存密集两类负载。这种拆分依赖一个显式假设:prefill 阶段已把提示词的完整 KV 状态写入共享的 KV 池,decode 阶段直接读取即可。当提示词长度超过 KV 池实际容量时,这个假设不再成立,而错误处理路径是否被正确触发,取决于各部署模式下的长度校验逻辑。单节点模式下校验较直接,会返回长度错误;分离部署时,若长度检查在实际写入之前被绕过,decode 阶段就会读到并未被本次请求写入的页。理解这一点,就能明白为何同一模型在不同部署形态下表现不同。
为什么 200 比 400 更危险
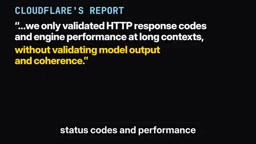
客户端没有收到 400 错误,而是收到 200 和一段连贯的回答。Cloudflare 承认,其测试只检查状态码,所以“表现良好”。这正是本次事故最值得警惕的地方:错误被包装成了成功。
SGLang 在事后说明中表示,是这种上下文长度与 KV 池的不匹配让拒绝路径变得可达。单节点模式下会正常返回错误,只有在特定部署模式下才触发了该问题。
Cloudflare 在宣布事件后 40 分钟内将模型下线,并于当天完成修复后恢复。
Canary 文本(金丝雀文本)源自矿业中用金丝雀检测毒气的做法,在软件测试中指一段预先植入、内容唯一且可被精确识别的标记数据。用于验证模型 API 时,典型做法是在提示词中嵌入一个随机生成的字符串(如特定 UUID 或口令),然后检查返回内容是否原样包含该字符串。若返回中缺失该标记,或出现了本不属于本次请求的内容,就说明输出并非完全由当前输入生成,可能存在缓存污染、请求串流或数据泄漏。相比检查 HTTP 状态码,canary 校验直接检验“输出是否真的来自这次请求”这一语义层面的正确性,能发现状态码无法反映的静默错误。对多租户共享端点,还可结合输出指纹比对、请求 ID 回显等手段,构成更完整的输出完整性验证。
社区争议:标题该不该点名 GLM 5.3
在 Hacker News 上,有评论者赞赏 Cloudflare 主动披露问题的态度,也有观点认为标题不该把矛头指向 GLM 5.3——模型本身和开发方并非事故原因,问题出在推理引擎的部署配置上。截至目前,研究人员的完整报告尚未发布。
可操作的检查清单
对于使用 SGLang 的团队,Cloudflare 建议:在 pre-filled decode 模式下运行测试;升级到 0.5.22 或更高版本;在每个节点上比对 KV 池容量与上下文长度配置是否匹配。
对任何模型 API,验证输出时不要只看状态码,应注入已知的 canary 文本,确认返回内容确实来自本次请求。对高度敏感的数据,需要重新评估是否适合使用共享端点。
同样的习惯也适用于 agent 工作流。在 Swarm 中,一个已完成的编码任务会停在 needs review 状态。读 diff、尽量跑测试、然后再合并。“完成”只是一个状态,不是一次检查。200 只说明服务器答应了,只有输出内容才能说明它答了什么。
需要区分的是,HTTP 状态码描述的是请求在传输与协议层面的处理结果,而非业务语义的正确性。200 仅表示服务器接收并完成了一次响应,不保证响应内容属于当前请求、不保证没有跨租户数据混入,也不保证模型输出来自本次输入。这类“协议成功、语义失败”的问题在分布式推理系统中尤其隐蔽,因为中间环节(调度器、KV 池、批处理)的任何状态错配都可能让错误以正常响应的形式呈现。工程上通常用分层校验来弥补:协议层看状态码与延迟,语义层用 canary 与结构校验,数据层则通过租户隔离与审计日志确认边界。对安全敏感的负载,还应在部署层面确保缓存按租户隔离或在使用后清零,而不是依赖调用方逐次验证。
相关推荐

Claude国内使用与充值全攻略:三种方式对比及防封控指南
整理Claude国内使用与会员充值的三种方式:海外信用卡直充、苹果美区ID与安卓Google Play内购、网站自助充值,对比各自门槛、成本与封控风险,并给出固定设备、稳定IP、不共享账号等五条降低封号概率的使用习惯。

从ChatGPT内容限制到Eval、可观测性与Guardrail实战
通过电子商店订单Agent实战,讲解ChatGPT内容限制背后的工程逻辑,以及Eval评估、Observability可观测性和Guardrail护栏如何协作,避免同名用户数据泄露与提示注入风险。

LangChain4j决策模型:本地校验Java工具调用
LangChain4j社区提出决策模型方案,在本地对Java工具调用进行校验,将控制逻辑从LLM拉回应用侧,提升工具调用的可靠性与可调试性。