#SGLang
共 6 篇相关文章

·7 分钟
SGLang v0.5.21 发布:PD 角色热切换与 Rust 前缀缓存
SGLang v0.5.21 正式发布,汇集 227 位贡献者的 779 个 PR,带来 PD 实例运行时角色热切换、Rust 前缀缓存默认启用、新增 Decisions/Score 判别类 API,以及投机解码与多模型加速等重磅更新。
阅读全文 →
·3 分钟
SGLang v0.5.20 发布:高性能LLM推理引擎再迭代
开源LLM推理框架 SGLang 发布 v0.5.20 版本。本文介绍 SGLang 的核心特性、v0.5.x 系列的迭代意义以及升级获取方式,帮助开发者了解这款高性能大模型推理引擎的最新进展。
阅读全文 →
 行业洞察
·5 分钟
SGLang进军金融业:AI推理基础设施如何重塑华尔街
SGLang联合Crusoe AI、Cloudflare等举办金融AI推理活动,探讨LLM推理框架在交易、风控、合规等场景的落地应用,解析AI推理基础设施垂直化趋势及金融行业部署前景。
阅读全文 →
 科技前沿
·5 分钟
Cloudflare向SGLang贡献KV Cache与Mooncake关键修复
Cloudflare向SGLang上游提交decode KV cache offload和Mooncake recovery两项关键修复,解决高并发场景下Kimi K2.6模型乱码输出问题,并实现分布式推理节点自动故障恢复,提升生产环境稳定性。
阅读全文 →
 科技前沿
·5 分钟
SGLang举办Agent Loops主题Office Hour,聚焦智能体循环架构优化
SGLang团队举办Agent Loops主题Office Hour,深入探讨智能体循环调用的推理优化方案,涵盖KV Cache复用、低延迟多轮对话及工具调用等关键技术,助力AI Agent开发者提升推理性能。
阅读全文 →
 教程攻略
·5 分钟
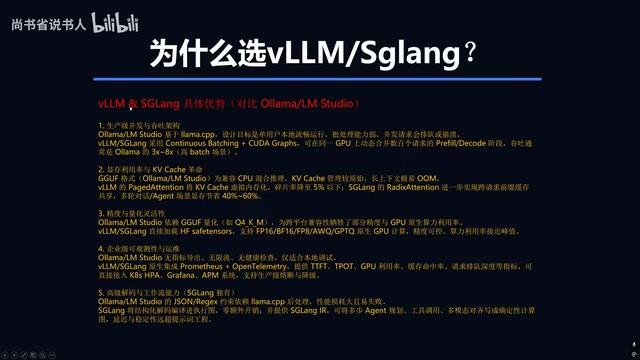
vLLM与SGLang本地部署教程:性能提升3-8倍的实战指南
详解vLLM和SGLang本地部署全流程,对比LM Studio性能差距,通过Docker+AI助手三步完成部署。涵盖SGLang与vLLM选型建议、5090显存优化、Qwen3模型推荐及Cherry Studio接入方法。
阅读全文 →