CodeCook:用上下文压缩砍掉AI编程Token成本的VS Code插件

CodeCook是免费开源的VS Code编程智能体,通过压缩旧对话历史大幅降低长会话的Token成本。
CodeCook是一款MIT许可的VS Code扩展,以BYOK(自带API密钥)模式运行,用户直接向模型提供商付费,无平台加价与锁定。其核心创新在于对历史对话轮次和工具输出进行摘要压缩,使每轮请求只需为新产生的内容付费,而非重复传输全部历史。作者给出的单轮极端案例显示Token消耗可降低约98%,实际效果因会话长度而异。为防止压缩导致智能体"失忆",CodeCook让任务计划独立于摘要持久存在,并提供检查点回退、原生diff审查、成本可视化与消费上限等配套功能,支持Gemini、OpenAI、Claude、Azure OpenAI及AWS Bedrock等主流提供商。
长会话中被反复付费的"旧账单"
用AI做编程的人大概都遇到过这样的尴尬:一次长时间的编码会话里,每一轮对话都会把之前已经发生的所有消息和工具输出重新发送给模型。换句话说,你为同一段历史记录反复付费,Token账单不断膨胀,而实际推进的工作量却没有同比例增长。
这正是开源项目 CodeCook 想要解决的痛点。作者的目标很直接——让开发者能放心使用更大的模型,而不必时刻盯着Token消耗。
CodeCook 是什么
CodeCook 是一款免费的、采用 MIT 许可证的 VS Code 扩展,本质上是一个嵌入侧边栏的编程智能体(coding agent)。它最核心的定位是 BYOK(Bring Your Own Key,自带密钥):你使用自己的API密钥运行,直接向模型提供商付费,中间没有任何加价,也不存在平台锁定。
这种模式对重度使用者相当友好。相比某些订阅制或按座席收费的AI编程工具,BYOK把成本透明度和控制权交还给了开发者本人——你的钱花在哪、花了多少,一目了然,而且随时可以更换提供商。
核心机制:压缩旧对话轮次
CodeCook 降低成本的思路,重点在于对历史上下文的处理方式。
旧轮次自动摘要
较早的对话轮次和体积庞大的工具输出,不会在每一轮都原封不动地重新发送,而是被摘要(summarize)压缩。这样一来,你主要为新产生的工作付费,而不是为陈旧的历史记录反复买单。
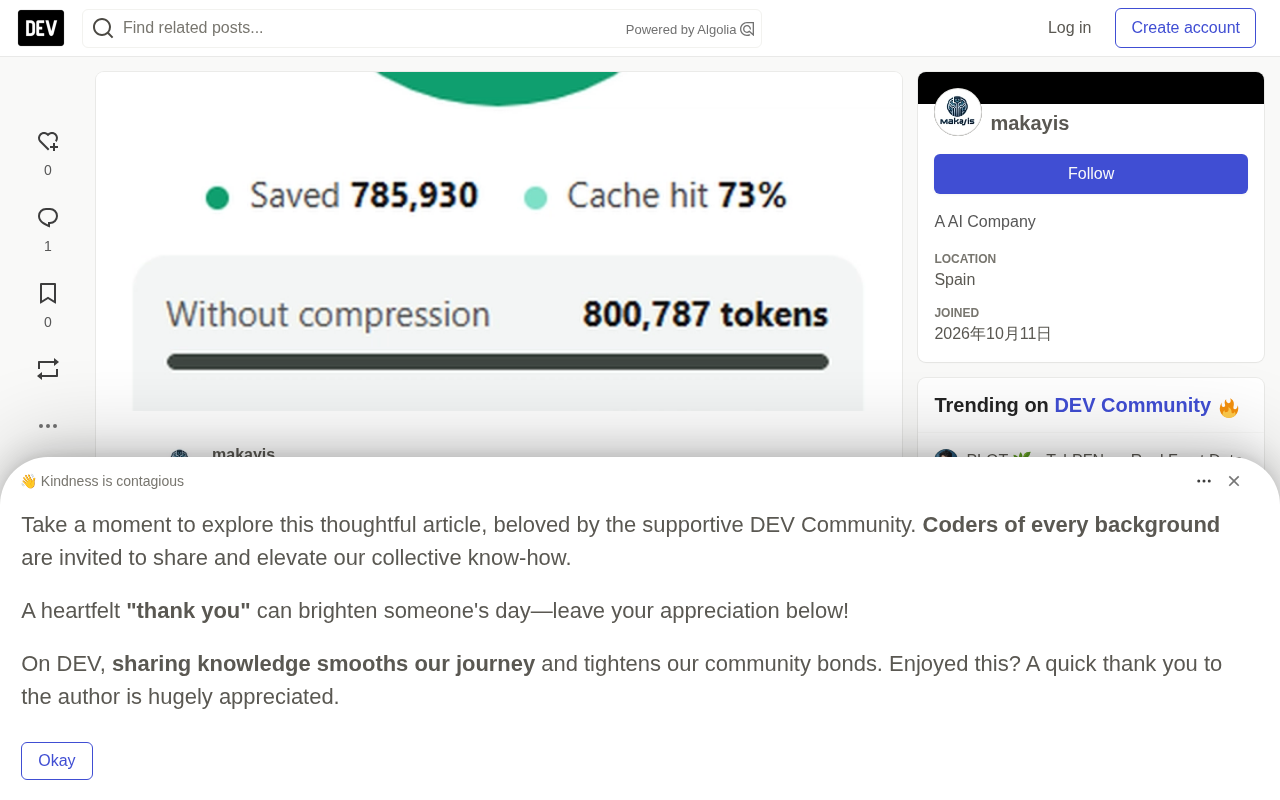
作者给出了一个颇具冲击力的数据:在一次长会话中,某一轮的Token消耗从 800,787 降到了 14,857,减少约 98%,而对应的计划和工作成果保持完整。需要强调的是,这是长会话中某一轮的极端案例,并非平均值——实际节省幅度会随会话长度而变化。这一点作者在原文中也诚实地做了说明。
摘要压缩(summarization-based context compression)是Agent框架中"长期记忆管理"的一种典型策略。其基本思路是用LLM对早期对话生成简洁的语义摘要,以较少的Token保留核心信息,再将摘要替换原始内容送入后续请求。这与人类记忆的工作方式有一定类比——我们会把久远的经历压缩为要点,而非逐字逐句地回忆。然而这种方式的固有局限在于:摘要是有损压缩,LLM在生成摘要时会做选择性保留,技术细节、具体数值、边界条件等信息有较高概率被丢弃,而这些恰恰是编程任务中最不能出错的部分。因此"计划独立于摘要持久存在"的设计,正是针对这一弱点的定向补偿。
计划在摘要后依然存活
上下文压缩最大的风险在于:摘要可能丢失关键信息,导致智能体"失忆"。CodeCook 的应对是让"计划(plan)"独立于摘要之外持久存在。你可以构建一个计划,之后从命令面板重新打开它,智能体会在长会话中持续遵循这个计划推进任务。
成本可见与消费上限
工具内置了Token优化器、节省报告和花费估算,并支持设置每日、每周或每月的消费上限。这意味着一次漫长的会话不会突然给你一个意外的大账单。
理解这一机制需要先了解大语言模型的上下文窗口工作方式。每次向模型发起请求时,API调用都会把完整的对话历史作为输入Token提交——这意味着一次包含50轮对话的会话,第50轮的费用几乎是前49轮内容加上本轮新内容的总和。随着会话延长,Token消耗呈近似线性增长,而在使用工具(如代码执行、文件读写)的编程智能体场景下,每次工具调用的完整输出也会被纳入历史,进一步加速膨胀。这是当前所有基于对话历史的AI应用都面临的结构性问题,而非CodeCook特有的挑战。
面向真实开发工作的设计
CodeCook 并不只是一个节省成本的噱头,它在工程细节上做了不少考量:
- 每一轮都有检查点:你可以查看原生 diff,决定保留或回退全部修改,甚至回退到更早的某一轮并恢复文件状态。这种可回溯性对于AI生成代码的审查至关重要。
- 灵活的上下文添加:在编辑器里高亮一段代码,或在终端里选中一段文本,直接选择 Add to Chat 即可把它加入对话。
这些功能让它更像一个可以融入日常工作流的生产力工具,而非单纯的实验性demo。
支持的模型提供商
CodeCook 覆盖了主流的模型渠道,包括 Google Gemini(Vertex AI 或 API 密钥)、OpenAI、Anthropic Claude、Azure OpenAI 以及 AWS Bedrock。你只需要连接其中任意一个即可开始使用。这种多提供商兼容性进一步强化了"不锁定"的理念。
Vertex AI 与直接使用 Gemini API Key 是两种不同的接入路径:前者通过 Google Cloud 的企业级基础设施调用模型,支持 VPC 网络隔离、审计日志和 IAM 权限控制,适合对合规与数据驻留有要求的团队;后者则通过 Google AI Studio 签发的密钥直接调用,配置更轻量,适合个人开发者快速上手。AWS Bedrock 同理,它是 Amazon 托管的模型推理服务,允许在 AWS 私有网络内调用包括 Claude 在内的多家厂商模型,用户的请求数据不会用于模型训练,这对企业用户有额外的数据安全价值。
如何上手
按照作者给出的步骤,启用流程相当简洁:
- 从 VS Code Marketplace 安装 CodeCook 扩展
- 在活动栏打开 CodeCook,使用 Google 或 GitHub 登录——这会创建一个仅存储在 VS Code 本地的账户,CodeCook 不会获得对你代码仓库的访问权限
- 连接一个模型提供商
- 让智能体在你的工作区中执行任务,并审查生成的 diff
关于隐私的说明值得留意:本地账户的设计意味着登录过程不涉及把代码上传到第三方,这对注重代码安全的团队是一个加分项。
一点评价与思考
上下文压缩本身并不是全新的概念,许多Agent框架都在探索类似的"记忆管理"策略,但 CodeCook 把它和 BYOK、成本可视化、消费上限打包成一个开箱即用的 VS Code 产品,降低了普通开发者的使用门槛。
不过也要客观看待那个"98%"的数字——它是单轮极端案例,不能当作普遍预期。摘要压缩在节省Token的同时,始终存在信息丢失的潜在代价,复杂任务中智能体是否会因上下文被压缩而出现判断偏差,仍需在真实长会话中验证。作者目前也在主动征集用户反馈,特别关注大家在实际会话中的真实节省幅度、缺失的提供商或功能,以及体验粗糙之处。
对于被AI编程Token账单困扰的开发者来说,这是一个值得一试的免费开源选项。
相关推荐

iPhone Duo续航实测:一天一充跑不掉,大屏是耗电元凶
iPhone Duo续航实测:重度使用一天需至少充电一次,6.5小时亮屏约剩30%电量。大屏展开频率是耗电关键,MagSafe电池背夹可救场,长期衰减同样值得关注。

Kimi K3.1 Pro开源发布:2.8万亿参数逼近Opus
Moonshot发布开源MoE模型Kimi K3.1 Pro,2.8万亿总参数、1040亿激活参数,Terminal Bench 4.0仅落后Opus 5.5不到1分,单任务成本约三分之一,API价格减半,开源权重11月4日开放。

Costco科技产品价格竞猜:显示器、键鼠、Bose音响值不值?
YouTube博主在Costco竞猜科技产品价格:2K 180Hz显示器、罗技键鼠、Bose音响和CyberPower UPS实测估价,揭示仓储会员店的选品定价逻辑与品牌溢价真相。