CodeQuant2:低精度推理模型量化新突破,推理速度提升2.85倍
CodeQuant2用聚类LUT量化和改进校准策略,解决推理模型早期激活波动问题,实现2.85倍加速。
大型推理模型通过生成冗长推理链提升表现,却大幅增加推理成本,低精度量化因此变得关键。但激向量化模型在推理任务上表现不佳,核心原因是解码初期的激活波动被传统校准忽略。为此,研究者提出CodeQuant2——一个基于聚类的查找表(LUT)量化框架。它通过旋转与缩放抑制离群值、用聚类表征非均匀权重、按层自适应调整码本尺寸,并改进校准样本选择以匹配推理时的激活统计。结合定制LUT CUDA内核,CodeQuant2在推理基准上显著提升准确率,相比BF16最高获得2.85倍加速,为低精度部署大型推理模型提供了可行方案。
大型推理模型(LRM)通过生成更长的中间推理轨迹来提升任务表现,但这大幅增加了推理成本,使得低精度量化变得日益重要。然而,激进的量化模型在推理任务上往往表现不佳。研究发现,推理过程最初的解码步骤中会出现更大的激活波动,而忽略这些早期状态的校准方法可能遗漏关键的激活波动。为了解决这些推理特有的量化挑战,研究者提出了CodeQuant2——一个基于聚类的查找表(LUT)量化框架,专为低精度大型推理模型设计。
推理模型的量化困境
大型推理模型在复杂任务上表现出色,但代价是生成冗长的推理链条,显著推高了推理成本。低精度量化是降低部署成本的关键技术,但现有方法在推理任务上往往力不从心。核心问题在于,推理模型在解码初期会产生剧烈的激活波动,而传统校准过程通常忽略这些早期状态,导致量化误差累积。CodeQuant2的提出正是为了应对这一推理场景下的特殊挑战。
激活波动(Activation Outliers) 指的是神经网络在前向传播过程中,某些层输出的数值分布出现极端大值或剧烈波动的现象。在大型语言模型中,激活值通常呈现长尾分布,少数通道的数值远大于其余通道。对于推理模型而言,解码初期的激活波动尤为显著,原因在于模型刚开始生成推理链时,上下文尚不充分,注意力机制需要在多个候选方向间快速切换,导致隐状态剧烈变化。量化过程若用固定的缩放因子覆盖整个激活范围,这些离群值会拉大量化步长,使正常范围内的数值被压缩到少数几个量化级别,造成精度损失。因此,识别并处理解码初期的激活波动,是推理模型低比特量化的关键难点。
CodeQuant2的核心技术
CodeQuant2采用基于聚类的LUT量化框架,融合了多项创新技术:
- 旋转与缩放抑制离群值:通过旋转和缩放操作减轻激活离群值的影响,使权重分布更利于量化。
- 聚类表征非均匀权重:利用聚类方法表示非均匀的权重分布,更准确地捕捉权重特征。
- 自适应码本尺寸:根据每层的量化难度动态调整码本大小,实现资源的最优分配。
这些技术协同工作,在保持模型精度的同时显著降低比特宽度。
查找表(LUT,Look-Up Table)量化 是一种非均匀量化的实现方式。传统线性量化用统一的步长将浮点数映射到整数格点,而LUT量化预先为每个权重或激活块存储一张“码本”(codebook),表中每个条目对应一个可学习的量化中心值。量化时只需查表找到最近的中心索引,反量化时再用索引取回中心值。这种方式能灵活逼近任意分布,特别适合权重分布不均匀或存在离群值的场景。代价是需要额外的存储开销来保存码本,且推理时需要定制内核来高效完成查表操作。CodeQuant2中的自适应码本尺寸,正是对每层码本条目数量的动态调节,以在精度和存储之间取得平衡。
校准策略的改进
基于对推理时激活行为的观察,CodeQuant2改进了校准样本的选择策略,使其更匹配实际解码统计。传统校准往往使用通用文本,而推理模型的激活模式在解码初期波动更大,因此需要选择能代表推理过程的样本。这一改进确保了量化模型在推理任务上的稳定性。
校准(Calibration) 是训练后量化(PTQ)中的关键步骤:用一小批代表性样本输入模型,统计各层激活的动态范围或分布,从而确定量化参数(如缩放因子、零点或码本中心)。校准样本的分布直接影响量化参数的质量——若校准数据与实际推理数据分布不匹配,量化误差会显著增大。对于推理模型,常规做法是用通用文本校准,但实际推理时模型会生成大量中间推理步骤,激活统计与通用文本差异明显。CodeQuant2强调选择能覆盖解码初期波动特征的校准样本,使量化参数更贴近真实推理时的激活分布,从而减少早期解码阶段的精度损失。
性能表现
结合定制的LUT CUDA内核,CodeQuant2在推理基准测试中实现了显著的准确率提升,同时相比BF16最高获得2.85倍的加速。这一成果表明,针对推理模型特点设计的量化方法能够有效平衡精度与效率,为低精度部署大型推理模型提供了可行方案。
意义与展望
CodeQuant2的出现为低精度大型推理模型的部署提供了新思路。其针对推理过程激活波动的校准策略和自适应聚类方法,有望推动量化技术在推理场景的进一步应用。随着推理模型规模持续增长,此类专用量化技术将变得愈发关键。
相关推荐
Claude Code额度不够用?实测哪些技巧真省额度
实测 Claude Code 20美元套餐:换用 Sonnet 或 Haiku、降低 effort 能让同样任务额度减半以上,而 /clear、/compact、plan mode 等流传技巧在短会话中几乎不省额度甚至更贵。
Anthropic新研究:AI记忆如何避免「记错」?
Anthropic最新报告探讨AI智能体跨会话记忆的可靠性:数据库任务中记忆提升基准分数,但游戏实验显示记忆可能固化错误。报告建议保留证据、测试规则、纠正过时笔记,为助手构建者提供实践指南。
AI智能体记忆全解析:四层结构与“做梦”机制
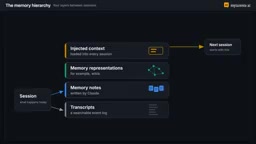
解读Anthropic智能体记忆研究:记忆的四层架构、以CLBench和宝可梦实验检验“该记什么”,以及通过“做梦”修正笔记、构建wiki、提升上下文注入质量的机制与局限。