Codex Linux桌面版实测:比CLI更适合初学者的AI编程助手

Codex桌面版正式登陆Linux
OpenAI旗下的Codex(ChatGPT编程助手)近日发布了Linux桌面版本,这对于长期依赖命令行工具(CLI)进行AI辅助开发的用户来说是个值得关注的更新。此前,许多开发者主要通过Codex CLI来完成代码生成工作,而桌面版的到来提供了另一种更直观的交互方式。
据B站UP主的实测分享,桌面版基于Electron打包,安装包约350MB。Electron是由GitHub开发的开源框架,允许开发者使用Web技术(HTML、CSS、JavaScript)构建跨平台桌面应用,它将Chromium浏览器引擎和Node.js运行时捆绑在一起,因此应用体积通常较大。VS Code、Slack、Discord等知名应用均基于Electron构建,这一技术选择的优势在于可以快速实现跨平台的一致体验,但也常被批评内存占用较高。从技术架构来看,Electron应用由主进程(Main Process)和渲染进程(Renderer Process)构成——主进程负责窗口管理和系统级交互,渲染进程则运行实际的Web页面。每个Electron应用实质上内嵌了一个完整的Chromium浏览器实例,这也是350MB安装包体积的主要来源。近年来,Tauri等基于系统原生WebView的轻量级替代方案正在兴起(其打包体积通常只有几MB),但Electron生态的成熟度和丰富的npm包支持仍使其成为需要快速迭代的产品的首选方案。
对于Ubuntu系用户可下载DEB包(X86架构),Fedora用户则选择RPM格式。值得一提的是,UP主观察到下载链接的域名似乎并非OpenAI官方的主域名,建议用户在下载前留意来源真实性。由于该服务需要科学上网访问,下载速度可能较慢,可借助Motrix等多线程下载工具提速。
桌面版更适合初学者上手
一个有趣的观点是:从学习角度而言,初学者选择Codex桌面版可能比CLI收获更快。相比CLI中大量需要对照手册理解的命令和配置,桌面版的图形化界面让功能一目了然。UP主坦言,即便是有经验的用户,在阅读Codex CLI官方手册时,对某些机制(尤其是安全沙箱相关)也未必能完全理解,而图形界面降低了这一认知门槛。这实际上反映了开发工具设计中的一个经典命题:CLI提供了更高的灵活性和可脚本化能力,而GUI则通过可视化反馈降低了探索成本。对于AI辅助开发这类新兴领域,图形界面让用户能够直观地看到会话管理、模型切换、权限配置等概念如何运作,建立心智模型后再转向CLI会更加得心应手。
无缝继承CLI配置与会话
桌面版安装完成后,任务栏会出现ChatGPT图标。首次启动需要耐心等待初始化,这里有一个实用提示:无需使用Proxy chain等代理工具强行加速,桌面版本身即可正常工作。
最令人惊喜的是它对CLI环境的兼容性。安装后,桌面版自动读取了用户此前在Codex CLI中的所有聊天记录和会话(session)。这一设计体现了良好的工程实践——CLI和桌面版共享同一套本地数据存储(通常位于~/.config或~/.local/share目录下),避免了用户在工具切换时丢失上下文。这一点尤其解决了CLI的一大痛点——在命令行中,多个会话往往以一串UUID命名,用户很难分辨哪个会话对应哪个项目内容。
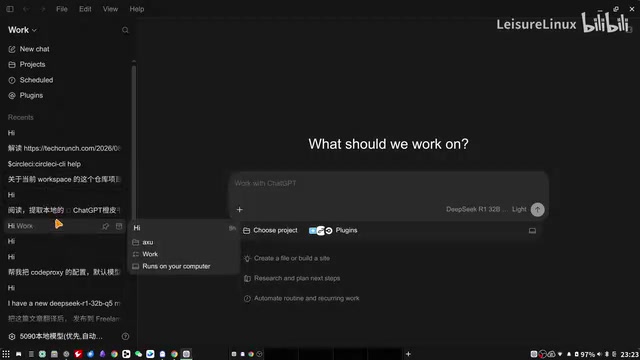
同样地,用户在CLI中通过 /model 命令配置的模型列表,在桌面版中完全一致地呈现。这意味着无论是云端模型还是本地部署的模型,都能在图形界面中直接调用,配置无需重复。
本地模型与"Token自由"实践
本次实测的一大亮点是对本地模型的支持。UP主使用本地Ollama部署的通义千问广告(Qwen)视觉模型进行图片解读测试,试图实现所谓的"Token自由"——即不再依赖付费的云端API调用。
Ollama是一款开源的本地大模型运行框架,旨在让用户像管理Docker容器一样便捷地下载、运行和管理各种开源大语言模型。它封装了底层的llama.cpp推理引擎——一个由Georgi Gerganov开发的纯C/C++高性能推理库,以极致的内存优化和跨平台兼容性著称。Ollama在此基础上增加了模型管理层,采用类似Docker的Modelfile概念,用户可以自定义系统提示词、上下文窗口大小、温度参数等配置。它提供了简洁的命令行接口和REST API,支持NVIDIA CUDA、Apple Metal、AMD ROCm等GPU加速方案。用户只需一条命令(如ollama run qwen)即可从官方模型仓库拉取并运行模型,当前仓库已收录数百个开源模型,从1B参数的轻量模型到70B以上的大型模型均有覆盖。
关键在于,Ollama的API接口兼容OpenAI的Chat Completions格式,这也是Codex桌面版能够无缝调用本地模型的技术基础——只需将API端点从OpenAI的云端地址切换为本地的localhost:11434即可。这种API兼容设计已成为开源模型部署工具的行业惯例,vLLM、LM Studio等工具同样采用这一策略,使得几乎所有为OpenAI API开发的应用都能零修改地接入本地模型。
不过实测结果喜忧参半。在使用本地32bit(DeepSeek广告蒸馏版/Q5量化)模型时,图片解读任务响应缓慢,甚至出现卡顿未能输出结果的情况。
这里需要深入解释量化的概念:量化(Quantization)是将大模型的参数从高精度浮点数(如FP16/BF16,每个参数占16位)压缩为低精度整数(如4位或5位)的技术,目的是大幅减少模型的显存占用和计算量,使其能在消费级显卡上运行。量化技术经历了从简单的线性量化到GPTQ、AWQ、GGUF等复杂方案的演进。当前本地部署最常用的GGUF格式支持混合精度量化——即模型的不同层可以使用不同的量化位数,对重要层保留更高精度。Q4表示4位量化,Q5表示5位量化,后缀中的K_M、K_S等表示不同的量化策略(K代表k-quant方法,M代表medium即中等精度配置)。数字越大精度越高、效果越接近原始模型,但对显存的需求也更大。
量化不可避免地会损失模型精度,尤其在视觉多模态等复杂任务中,量化造成的性能下降更为明显。这是因为视觉编码器(通常基于ViT架构)对权重精度更为敏感,其注意力层的权重分布与纯文本模型存在显著差异,过度量化会导致图像特征提取能力急剧下降,进而影响整个多模态管线的输出质量。
UP主对比了此前使用的通义千问3.5(Q4量化35bit)模型,认为老模型反馈更快。这也反映出一个现实问题:即便配备了5090级别的显卡(拥有32GB GDDR7显存),本地大模型在视觉多模态任务上的性能与响应速度仍需仔细调优。影响因素包括:模型的上下文长度设置(更长的上下文需要更多KV缓存显存)、批处理大小、GPU的显存带宽瓶颈等。
最终切换到云端付费模型(如DeepSeek V4 Flash)后,任务才较为顺畅地完成。这说明当前阶段,本地模型虽然在成本上具有吸引力,但在体验的稳定性上仍与云端服务存在差距,量化精度、模型选型都需要反复测试。云端服务的优势在于拥有专业的推理优化(如张量并行、连续批处理、PagedAttention等技术)和充足的算力资源,能够在延迟和吞吐量之间取得更好的平衡。
图形界面的独占功能
Codex桌面版相比CLI提供了不少专属功能,这也是它核心价值所在:
插件与技能管理
桌面版内置了插件(Plugin)管理界面。例如经常使用GitHub的开发者,可以直接配置GitHub的MCP(Model Context Protocol)服务。
MCP是由Anthropic于2024年底提出的开放标准协议,旨在为AI模型与外部工具、数据源之间建立统一的通信接口。其设计理念借鉴了Language Server Protocol(LSP)的成功经验——LSP通过标准化协议统一了代码编辑器与各编程语言工具链之间的交互(使得任何支持LSP的编辑器都能获得代码补全、跳转定义等功能),而MCP则致力于统一AI模型与外部世界的交互方式。
在MCP架构中,AI应用作为"客户端"(Client),而各种外部服务(如GitHub、数据库、文件系统、搜索引擎)作为"服务端"(Server),通过标准化的JSON-RPC协议进行交互。MCP定义了三种核心原语:Resources(数据资源,如文件内容、数据库记录)、Tools(可执行操作,如创建PR、运行SQL)和Prompts(可复用的提示模板)。服务端通过声明自身能力,客户端按需发现和调用,整个过程支持有状态的会话管理。这类似于USB-C为硬件设备提供统一接口——MCP为AI工具的插件生态提供了统一规范,正在被越来越多的AI工具采纳,有望成为AI Agent生态的基础设施层协议。
Codex桌面版中的GitHub MCP服务,就是让AI能够直接读取仓库代码、创建Pull Request、查看Issue、浏览Commit历史等,无需用户手动复制粘贴上下文信息。此外还有据称评价不错的Super Powers等扩展。

此前在OpenCloud等环境中安装的各类Skill(技能,如股票分析等)也能在此统一管理。需要注意的是,部分Skill在CLI中调用时可能因权限不足而不会被激活。
定时任务(Schedule Task)
一个此前未被广泛认知的功能是定时任务。UP主提到,根据官方文档,Codex原本被认为不具备类似cron的定时调度能力,但桌面版中却提供了Schedule Task功能,这对于需要周期性执行自动化任务的开发者是重要补充。
cron是Unix/Linux系统中经典的定时任务调度工具,自1975年诞生以来一直是系统管理的核心组件。开发者通过crontab文件定义调度规则(如0 2 * * *表示每天凌晨2点执行),常用于定期备份、日志轮转、数据同步等自动化操作。现代系统中,systemd timers正逐步作为cron的替代方案,提供更精细的依赖管理和日志集成。
Codex桌面版引入类似能力后,用户可以设定AI在特定时间自动执行代码审查、报告生成、数据抓取、依赖更新检查等任务,进一步拓展了AI辅助开发的自动化边界。这实质上是将传统的DevOps自动化流程与AI能力结合,让开发者能够构建"AI值班员"式的工作流——例如每天早晨自动检查代码仓库的新PR并生成审查摘要,或每周生成项目进度报告。
全权限与个性化设置
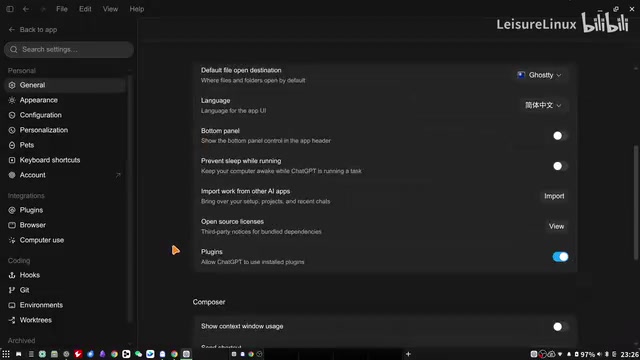
设置中的"Full Access"开关值得重点关注。若不开启,AI将在沙箱环境中运行,许多操作(如打开浏览器)会受限。
沙箱(Sandbox)是一种安全隔离机制,将程序的执行环境与宿主系统隔离开来,防止恶意或意外操作影响用户的真实文件系统、网络和系统配置。Linux环境下的沙箱技术栈通常包含多个层次:namespaces(命名空间,隔离进程的PID、网络、文件系统视图)、cgroups(控制组,限制CPU、内存等资源使用上限)、seccomp-bpf(系统调用过滤,阻止危险的系统调用)、以及AppArmor/SELinux等强制访问控制策略。
在Codex的场景中,AI生成的代码可能包含文件读写、网络请求甚至系统命令调用等操作,沙箱机制确保这些操作在受控环境中执行。Codex CLI默认使用基于容器或chroot的沙箱来限制代码执行范围。桌面版中的"Full Access"开关本质上是在安全性与功能完整性之间做取舍——关闭沙箱后AI可以直接操作系统资源(读写任意文件、安装软件包、访问网络),功能更强大但风险也更高。用户需要对AI的操作保持审慎,尤其是在执行不熟悉的代码或使用第三方Skill时,建议保持沙箱开启,仅在明确需要系统级操作时临时授予全权限。
此外,界面还提供了Personalization个性化设置(如设定AI的默认回复风格、编程语言偏好等)、开发相关的Hook配置(允许在AI操作前后触发自定义脚本)等CLI中缺失的选项。
中文界面支持
桌面版已提供中文界面(在Settings的Interface > Language中设置),不过UP主发现顶部部分标题文字仍显示英文,本地化尚未完全彻底。实际使用中,只需在提问时要求模型用中文回答即可,模型通常都能正常返回中文内容。这里值得注意的是,使用中文交互时Token消耗通常高于英文——因为中文字符在大多数tokenizer中需要更多token来编码(例如GPT系列的BPE分词器中,一个中文字通常需要2-3个token,而一个英文单词通常只需1-2个token),这在使用按token计费的云端模型时会影响成本。

总结:Codex桌面版值得尝试吗?
Codex Linux桌面版的发布,为AI辅助编程提供了更友好的入口。它无缝继承CLI配置、可视化管理会话与技能、支持本地模型接入、新增定时任务等能力,使其成为初学者和进阶用户都值得尝试的工具。
但实测也暴露出现实挑战:本地模型的性能调优仍是一门需要投入时间踩坑的功课,量化方案、模型选型都会显著影响体验。对于追求稳定的用户,云端付费模型目前仍是更可靠的选择。随着硬件(如下一代GPU的显存带宽提升)与本地推理生态(如更高效的推理引擎、更智能的量化算法)的成熟,"Token自由"的愿景或许会逐步照进现实。值得关注的趋势是,Speculative Decoding(投机解码)、Flash Attention等推理加速技术正在快速迭代,配合日益增长的开源模型质量,本地部署与云端服务之间的体验差距正在逐步缩小。
核心要点
相关推荐

Codex入门指南:OpenAI编程智能体与ChatGPT有何不同
Codex是OpenAI推出的AI编程智能体,能自主阅读、修改代码并执行测试。本文解析Codex与ChatGPT的核心区别,以及开发者为什么要学习这类AI编程工具。

Gemini Agent发布:Argon模型太强不敢放出,AI圈新动态盘点
Google发布办公通用智能体Gemini Agent,支持Gemini 4 Argon与Claude Opus 5.5,但Argon因太强暂不开放。本文盘点Odyssey 3世界模型、OpenAI营收、Arena融资等一周AI圈动态。

Sophos借OpenAI Daybreak把威胁响应时间压缩96%
Sophos首席技术官披露,借助OpenAI Daybreak项目和自研安全智能体,其MDR业务平均威胁响应时间从38分钟压缩至89秒,降幅达96%。本文解析其规划-执行-观察闭环架构及AI护栏松绑的意义。