Codex规划+Claude写代码:3.6K星开源项目实现多AI协同开发

开源项目CCB用Codex规划审查、Claude编码,通过共享记忆实现多Agent协作开发。
B站UP主分享的开源项目CCB(Claude Codex Bridge)在GitHub收获3.6K star,其核心是让不同厂商的Agent分工协作:Codex负责生成计划和审查代码,Claude Code负责按计划编码,通过ask机制自动委派任务并共享项目记忆,形成“开发—审查—修复”闭环。文章介绍了CCB的可视化配置、一行命令安装和手机远程控制功能,并记录了UP主用Codex规划、DeepSeek v4驱动Claude Code编码,最终生成3D汽车展示页面的实测过程。作者认为该方案有助于缓解单模型幻觉,但任务规模较小,多Agent通信延迟、token消耗和复杂拓扑稳定性仍需更多验证。
单模型写代码容易陷入幻觉,让两个AI分工协作会怎样?B站UP主分享了一个开源项目,用Codex做计划与审查、Claude Code负责编码,通过共享记忆和自动委派机制,完成了一个3D汽车展示页面的开发。这个项目叫CCB(Claude Codex Bridge),已在GitHub收获3.6K star,还支持Gemini、Kimi、Qwen、Cursor、Copilot等多种Agent。
核心功能:不只是双模型协作
据UP主介绍,CCB的核心能力是跨厂商Agent协作。它支持Codex、Claude、Gemini、Kimi、千问、Cursor、Pi、OpenCode等常见Agent,并允许构建A调用B调用C、AB调用C、A调用B和C等复杂协作拓扑。
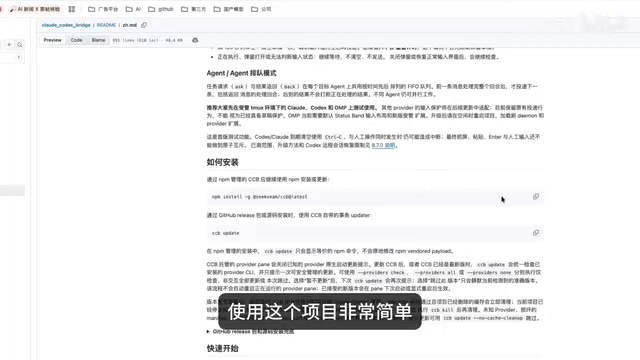
任务交接通过ask机制完成,减少人工复制粘贴的环节。多Agent之间拥有共同的项目记忆,这是实现“规划-开发-审查”闭环的关键。此外,项目还提供辅助功能:工作区可视化配置和手机远程控制,用户可以通过手机直接操控CCB处理协作任务。
可视化配置:十分钟搭建协作环境
安装只需一行命令,进入项目目录后执行ccb即可启动。UP主演示了设置面板:右侧Agent区域可添加多个窗口,自定义名称并选择对应模型(Codex、Claude、Gemini等),支持增删。左侧边栏可设置位置、宽度,并控制终端区域的启用状态。
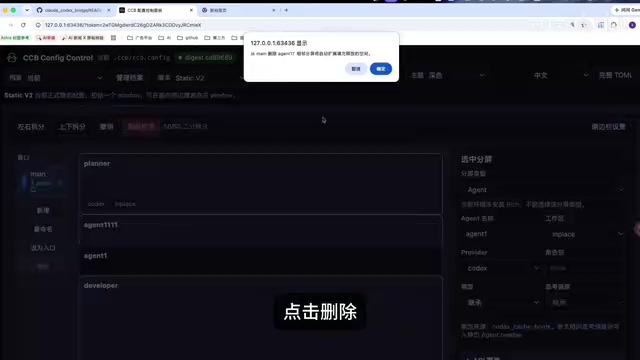
UP主配置了两个Agent:一个使用Codex(模型选择GPT-6.1.4.5),另一个使用Claude Code(实际调用的模型为DeepSeek广告 v4)。配置保存后即可进入协作测试。
Agent与模型的关系:文中提到的Codex、Claude Code、Gemini、Cursor等是不同厂商提供的Agent产品或编程助手,而实际驱动它们的底层模型可以替换。例如UP主让Claude Code实际调用DeepSeek v4,说明Agent更像一个带有工具调用、文件读写和任务循环能力的“外壳”,模型则是其推理内核。这种解耦使得用户可以根据成本、能力或可用性灵活组合Agent与模型,也是CCB能支持跨厂商协作的基础。
实战测试:Codex规划,Claude开发,自动验收
测试任务是制作一个“提呼器型的3D效果”网页。输入提示词后,Codex首先生成计划,并询问交互式网页、风格推荐等选项。用户选择推荐配置后,Codex完成任务规划,并自动将开发任务委派给Claude。
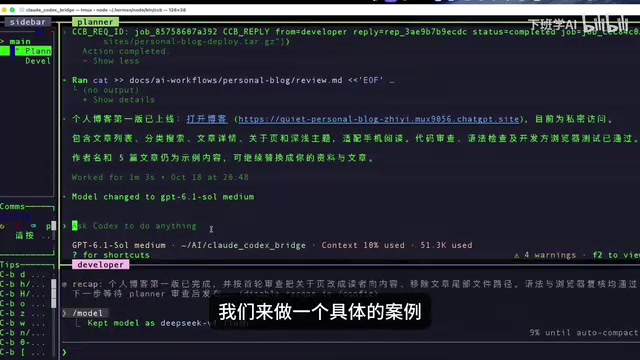
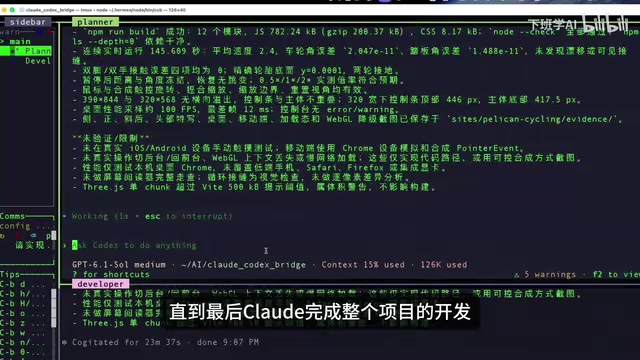
Claude完成编码后会通知Codex进行验收。Codex检查发现问题,再将修复任务派回Claude,形成“开发-审查-修复”的循环,直到Codex验收通过。UP主表示,两个Agent在同一个项目中共享记忆,这种协作方式有助于缓解单模型的幻觉问题。
最终产物是一个3D汽车展示页面。UP主评价“第一眼看上去还不错,有点像GPT的味道”,车轮滚动、脚灯踏板、近景远景和投影效果都比较真实。有意思的是,该页面由DeepSeek模型生成,而规划与审查由Codex完成,说明跨模型组合可以产出可用的复杂交互页面。
多Agent协作的价值与局限
从演示看,CCB解决的是“规划与执行分离”的问题。Codex擅长拆解任务和审查代码,Claude(或接入的其他模型)擅长按计划生成代码,两者通过共享记忆减少上下文传递损耗。
但UP主的测试也暴露了一些边界:任务规模较小,审查循环的轮次和修复质量未详细展开;多Agent通信的延迟和token消耗没有量化数据;复杂拓扑(A调用B和C)的实际稳定性仍需更多验证。对于想尝鲜的开发者,这个项目提供了一种低成本的多模型协作思路,适合个人项目和小型任务试水。
项目已在GitHub开源,支持一行命令安装,对多Agent协作感兴趣的读者可以自行部署体验。
什么是“幻觉”:在大语言模型语境中,幻觉(Hallucination)指模型生成看似合理但与事实不符、或缺乏依据的内容。在代码生成任务中,幻觉可能表现为调用不存在的API、虚构库函数、忽略边界条件或写出逻辑自洽但实际无法运行的代码。单模型往往难以发现自身错误,因为它缺乏独立的外部校验视角。
规划与执行分离为何能缓解幻觉:当一个模型只负责拆解任务和审查结果、另一个模型只负责按计划实现时,审查者不共享执行者的生成路径,因而更容易从需求出发发现偏差。这种“生成—验证”分离的思路类似于软件工程中的代码评审制度,通过引入独立视角降低单点错误被忽略的概率。
共享记忆的作用:多Agent协作中,共享记忆指各Agent可访问同一份项目上下文(如文件状态、任务计划、历史消息),避免每次交接都重新传输全部背景。它减少了上下文丢失和重复描述带来的误差,但也会带来上下文长度膨胀和token消耗增加的问题。
相关推荐

OpenAI与Shield合作:Astra智能体如何革新IT故障修复
OpenAI与Shield合作推出Astra智能体,可自动登录电脑和遗留系统,实时修复IT故障,比传统模型快35%到40%,仅在需要人类判断时引入人工。

iPhone Duo续航实测:一天一充跑不掉,大屏是耗电元凶
iPhone Duo续航实测:重度使用一天需至少充电一次,6.5小时亮屏约剩30%电量。大屏展开频率是耗电关键,MagSafe电池背夹可救场,长期衰减同样值得关注。

Kimi K3.1 Pro开源发布:2.8万亿参数逼近Opus
Moonshot发布开源MoE模型Kimi K3.1 Pro,2.8万亿总参数、1040亿激活参数,Terminal Bench 4.0仅落后Opus 5.5不到1分,单任务成本约三分之一,API价格减半,开源权重11月4日开放。