Codex接入Ollama:本地部署AI大模型完整教程

为什么选择在本地部署AI大模型
随着开源大模型能力的持续提升,越来越多的开发者和AI爱好者开始尝试在自己的设备上运行大模型。与调用云端API相比,本地部署有几个核心优势:数据完全私有、无需付费订阅、支持离线运行、不受内容审查限制。
本文根据B站UP主「路易大师」的实操教程整理,介绍如何将 Codex 编码工具与 Ollama 本地模型框架结合,搭建一套完整的本地AI工作环境。整个过程全程无需科学上网,模型下载速度取决于本地网速,对国内用户相当友好。
需要说明的是,本教程涉及的部分模型为「无审查版本」,请读者在合法合规的前提下使用相关工具。
第一步:安装Ollama运行环境
Ollama 是目前最主流的本地大模型运行框架之一,它将复杂的模型加载与推理调度封装成简洁的命令行工具,大幅降低了本地部署的门槛。
关于Ollama的技术背景:Ollama 是一个基于 llama.cpp 构建的本地模型运行时框架,于2023年底开源并迅速在开发者社区获得广泛关注。它的核心价值在于将原本需要复杂环境配置(CUDA驱动、Python虚拟环境、模型权重转换)的推理流程,封装成类似 Docker 的镜像管理体验——用一条命令即可完成模型的拉取、加载和运行。Ollama 支持 GGUF 格式的量化模型,能够智能调度 GPU 和 CPU 混合推理,即使显存不足以完全装载模型,也可将部分层卸载至内存运行,兼顾性能与兼容性。
下载与安装
从 Ollama 官网下载安装包(约 1.32GB)。建议以管理员身份运行安装程序,避免后续出现权限相关问题。安装包也可通过视频评论区提供的国内镜像链接获取,下载速度更快。
配置模型存储路径与上下文长度
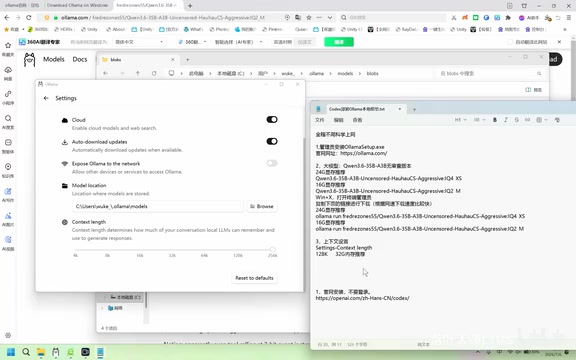
安装完成后,进入 Ollama 设置界面,可以看到 models 对应的模型存储路径。这里有一个容易被忽略的关键设置——上下文长度(Context Length)。
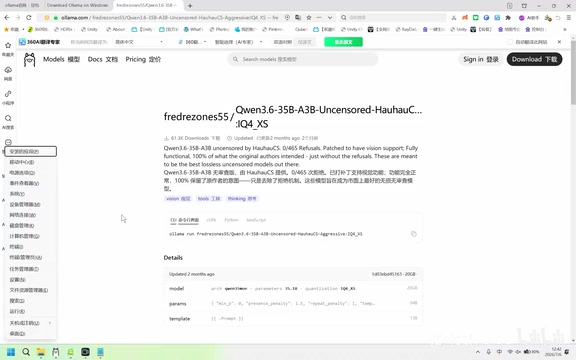
理解上下文长度的技术原理:上下文长度是大语言模型的核心参数之一,指模型在单次推理时能够"看到"的最大Token数量。Token是模型处理文本的基本单位,中文大约每个汉字对应1-2个Token。上下文窗口越长,模型在处理代码补全、多轮对话、长文档分析等任务时越不容易"遗忘"早期信息。然而,更长的上下文对显存和内存的需求呈接近平方级增长(受Attention机制的KV Cache影响),这也是为什么需要根据硬件条件合理配置该参数——盲目拉大会导致内存溢出或推理速度骤降。
上下文长度直接影响模型在长对话或复杂任务中的表现。上下文过短,连续操作后容易出现回答中断或异常。建议将上下文长度设置得尽可能大,以下是内存与推荐上下文的对应参考:
| 内存/显存 | 推荐上下文 |
|---|---|
| 32G 内存 | 约 128K |
| 64G 内存 | 约 256K |
| 16G 显存 | 视模型而定 |
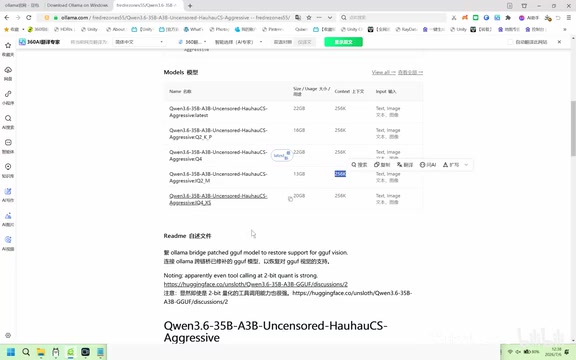
第二步:选择并下载合适的本地模型
模型选择是整个部署流程中最需要结合硬件权衡的环节。显卡显存和内存大小直接决定了你能流畅运行哪个量级的模型。
模型量化与显存的关系:本教程中提到的「量化模型」(如GGUF格式)是指通过降低模型权重的数值精度来压缩模型体积的技术。标准训练后的模型权重通常以FP32(32位浮点)或BF16(16位)存储,而量化可将其压缩至INT8、INT5甚至INT4精度,使模型体积缩小2-8倍。以一个70B参数模型为例,FP16版本需约140GB显存,而Q4量化后仅需约40GB,普通消费级显卡便可运行。量化会带来轻微的精度损失,但在工程实践中,Q5_K_M、Q6_K等中等量化级别对模型能力的影响通常在可接受范围内。Qwen3系列等模型专门针对量化推理做了优化,因此在小显存设备上表现尤为出色。
按显存大小选择模型
以下是实测给出的硬件建议:
- 24G 显存:推荐较大参数版本,速度比小显存方案快约 30%
- 16G 显存:可选支持 256K 上下文的中等参数版本,兼顾能力与速度
- 8G 显存:推荐 Qwen3 系列等小尺寸量化模型(如千问3.5、3.6等)
主力推荐的「无审查版本」支持 256K 超长上下文,在功能完整性和综合表现上均优于 128K 方案。
两种模型下载方式
方式一:在 Ollama 模型页面直接复制官方提供的 ollama run 命令;
方式二:通过第三方镜像页面获取下载链接,速度更快。
操作步骤如下:
- 在模型页面复制对应的下载命令
- 按下
Win + X,选择「终端(管理员)」 - 粘贴命令并回车,等待下载完成
整个下载过程无需科学上网,下载完成后可直接在终端输入文字测试,模型会即时响应。
第三步:安装并配置Codex
Codex 是本次教程要接入的AI编码与对话工具。安装过程有几个容易踩坑的注意事项。
关于Codex工具的定位说明:需要注意的是,此处教程中的「Codex」并非OpenAI历史上同名的代码生成模型(已于2023年停止独立服务并整合进GPT-4系列),而是一款支持接入本地模型后端的AI对话与编码辅助客户端工具。这类工具的核心价值在于提供类似Cursor或GitHub Copilot的交互体验,同时允许用户自定义推理后端——既可连接OpenAI等云端API,也可对接本地运行的Ollama服务。这种前后端解耦的架构设计,正是本教程方案能够实现「完全本地化运行」的关键所在:Codex负责界面与交互逻辑,Ollama负责模型推理计算,两者通过本地HTTP接口(默认为localhost:11434)通信。
安装注意事项
从 Codex 官网下载安装包(默认 Windows 版本),双击安装。安装完成后不要立即打开,也不要登录官方账号。
正确操作流程如下:
- 安装完成后暂不启动程序
- 在配置页面找到
codex app的接入命令并复制 - 打开
Win + X→ 「终端(管理员)」 - 粘贴命令并回车执行,出现提示后再打开 Codex
若此前已安装过旧版 Codex,新配置会自动覆盖旧版本,无需手动卸载。

连接Ollama本地模型
打开 Codex 后,在模型选择列表中即可看到之前通过 Ollama 下载的本地模型。选中后即可开始对话,全程无需联网。
说个细节,即便运行的是本地开源模型,Codex 在被问到「你是谁」时可能会回答「GPT-5 编码助手」——这属于模型的默认自我认知设定(即System Prompt中预设的角色信息),实际运行的仍是你本地部署的开源模型,不影响正常使用。
实测体验:响应速度是最大亮点
从实际演示来看,Codex + Ollama 方案最突出的优势是响应速度。与 llama.cpp 相关方案相比,接入本地模型后回复速度明显更快,输入问题后几乎即时返回结果。
关于性能差异的技术背景:llama.cpp是由Georgi Gerganov开发的C++推理引擎,是当前几乎所有本地推理工具(包括Ollama本身)的底层基础。这里的性能差异更多来自上层调度逻辑与优化策略的不同——Ollama在持续更新中引入了连续批处理(Continuous Batching)、Flash Attention等加速技术,在多并发或长上下文场景下有明显的吞吐量提升。用户感知到的「响应更快」,通常体现在首Token延迟(Time to First Token,即从发送问题到收到第一个字的时间)更低这一指标上。
界面方面有一个小瑕疵:Codex 默认为英文界面,切换中文后效果不明显,但不影响正常使用。
这套方案特别适合以下用户:
- 希望免费、无限次使用AI编码助手的开发者
- 对代码数据隐私有较高要求、不希望内容上云的用户
- 拥有一定显存(建议 16G 以上)、想充分发挥本地硬件性能的AI爱好者
总结:三步完成本地AI环境搭建
本教程展示了一条完整的本地AI部署路径:Ollama 负责运行模型,Codex 负责提供交互界面,两者通过本地HTTP接口通信,共同实现了可离线运行、无订阅费用、支持超长上下文的本地AI助手。
整个流程的三个核心步骤:
- 装 Ollama:管理员权限安装,拉大上下文长度设置
- 选模型:按显存大小选择合适量化级别的参数版本并下载
- 接 Codex:安装后先执行接入命令,再打开使用
对于想摆脱云端API订阅限制、探索本地大模型潜力的用户来说,这是一套门槛不高、步骤清晰、可复现的实用方案。请在使用过程中遵守当地相关法律法规。
核心要点
相关推荐
保护民主与自由选举:科技视角下的长期进步
从科技与AI视角探讨民主与自由选举的保护,分析技术对选举公正性的影响及如何守护长期社会进步,强调科技伦理与责任。
洛奇与米奇:银幕师徒的AI时代启示录
从洛奇与米奇的经典对白中,提炼AI时代的师徒智慧:经验传承、训练方法革新与长期主义。银幕故事折射技术行业的核心命题。
突触生成:神经元如何建立连接与重塑大脑
突触生成(Synaptogenesis)是神经元建立连接的核心过程。本文解析生长锥如何引导轴突寻找目标、突触前後の分化机制、突触修剪如何精炼神经环路,以及成年大脑中突触重塑与发育期的差异,帮助理解学习记忆与神经可塑性的细胞基础。