Colibri纯C引擎爆火:25GB内存跑744B大模型
Colibri用三级存储分层让744B参数MoE大模型在16GB内存的消费级硬件上本地运行。
Colibri是一个纯C编写、零依赖的开源推理引擎,核心思路是把MoE大模型的权重当作可按需调度的数据而非必须驻留显存的状态。利用MoE每个token只激活少数专家的稀疏特性,引擎将热专家常住显存/内存、冷专家存于NVMe磁盘,配合提前一层路由预取来掩盖磁盘延迟,实现了VRAM、RAM、磁盘三级统一调度。这使得744B参数的GLM模型在16GB内存的机器上即可启动,越用越快,精度与路由语义不受影响。目前支持GLM、Kimi K3(2.8T)、DeepSeek、Qwen3等9大国内主力模型家族,附带实时可视化专家路由工作台,已在开源社区收获约3.6万星标。
前沿大模型为何总被锁在机房里
跑一个744B参数的MoE大模型,长期以来只有一条路:进机房、堆显卡、走云端接口。原因不难理解——一个744B级别的MoE模型完整权重按几百GB计,而消费级显卡显存只有十几到二十几GB,整个模型塞进显存几乎没戏。
真正卡住普通用户的痛点有三条。第一是装不进去,显存根本不够;第二是权重不在自己手里,走云端接口意味着改不了、撤不了,一断网服务就停;第三是引擎太重,常见的推理框架要 Python、CUDA 一整套依赖,笔记本环境一装就出问题。
一个名为 Colibri(蜂鸟) 的开源项目试图换个思路解决这个问题。它是纯 C 编写、零依赖,目前已在开源社区收获约 3.6 万星标,覆盖 9 个模型家族,参数从 744B 到 2.8T,号称 16GB 内存起步就能跑前沿模型。
核心思路:权重不是要驻留的状态,而是待调度的数据
Colibri 的关键洞见是:MoE 模型不是装不下,而是放错了地方。它的设计思路把权重当成可按需调度的数据,而不是必须一次性驻留显存的状态。
以 GLM 系列为例,每个 token 只激活约 40B 参数,大约占总量 5.4%。其中真正随 token 换掉的专家权重大约只有 11GB,而路由稠密部分、注意力、共享专家、嵌入等约 17B(int4 量化后约 9.9GB)是常住内存、不来回搬运的。剩下的 19456 个路由专家(每个约 19MB、合计约 370GB)则放在磁盘上,按需即时加载。
这套机制类似 JIT 编译——编译器不会一次编译整个程序,只对热路径即时编译。Colibri 对 744B 的参数空间做同样的事:只有路由器判定当前 token 需要某个专家,才把它从 NVMe 搬到 RAM、再到 VRAM。放置只决定速度,不改精度、不改路由语义,这是整个设计最核心的承诺。
MoE(Mixture of Experts,专家混合)是一种稀疏激活的神经网络架构:模型由大量独立的「专家」子网络组成,每个 token 在推理时只经由一个轻量级路由器(Router)选出少数几个专家参与计算,其余专家权重在该 token 的处理过程中完全闲置。这使得模型的「总参数量」和「激活参数量」可以相差一个数量级——GLM 系列 744B 总量而每 token 仅激活约 40B,正是利用了这一特性。传统稠密模型(如 GPT 系列早期版本)每个 token 都要经过全部参数,因此必须将整个权重驻留显存;MoE 的稀疏性则天然给了按需加载的可能:既然绝大多数专家在当前 token 根本不会被点名,就没有理由提前把它们全塞进显存。Colibri 的三级分层设计正是建立在这个前提之上。
三级存储分层:显存、内存、硬盘各司其职
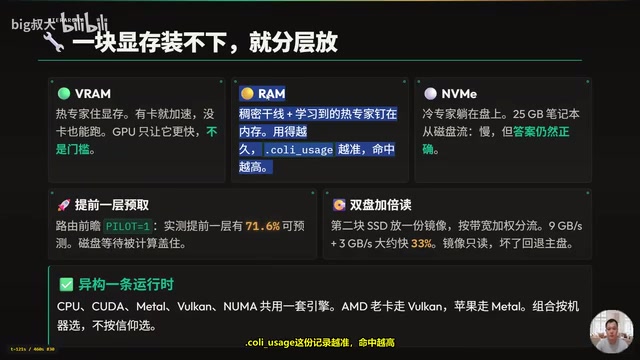
Colibri 把 VRAM、RAM、磁盘当成同一套推理层级来调度:
- VRAM(显存):放热专家。有卡就加速,没卡也能跑,GPU 只是让它更快,而不是运行门槛。
- RAM(内存):稠密干线加上学到的热专家。用得越久,命中率越高——它会记录专家使用情况(Cola Usage),让预测越来越准。
- NVMe(硬盘):冷专家躺在盘上。25GB 内存的笔记本从磁盘流式读取,答案仍然正确。
为了掩盖磁盘延迟,引擎做了 提前一层预取(路由前瞻),实测提前一层的可预测命中率达到 71.6%,磁盘等待被计算过程盖住。此外还支持双盘加速:第二块 SSD 放一份只读镜像,按带宽加权分流(如 9GB/s 加 3GB/s),整体大约快 33%,镜像损坏还能回退。
后端方面,CUDA、Metal、Vulkan、NUMA 共用一套引擎——AMD 和老卡走 Vulkan,苹果走 Metal,按机器选而不按信仰选。
NVMe(Non-Volatile Memory Express)是当前主流的高速固态硬盘接口协议,相比旧有的 SATA 接口,NVMe 通过 PCIe 通道直连 CPU,顺序读取带宽通常在 3–14 GB/s 之间。这个数字决定了磁盘流式推理的速度天花板:25GB 内存开发机实测 0.05–0.1 token/s,本质上就是受限于盘速。提前一层预取(路由前瞻)正是为了让磁盘 I/O 与 GPU/CPU 计算时间重叠——当第 N 层的计算还在进行时,引擎已根据路由预测在异步搬运第 N+1 层所需专家,从而将等盘时间从关键路径上移走。71.6% 的命中率意味着大多数情况下计算完成时数据已就位,只有少数预测失误时才需要真正等待磁盘。
一个引擎喂得下 9 大模型家族
引擎虽小,能喂进去的模型不小。9 个家族共用一个前端,各自一个 C 文件,通过 coli chat、coli serve、coli web 统一调用。国内主力权重基本都能本地跑:
- GLM 5.2 / 5.3:744B MoE,16GB 起步
- GLM 5.3 Flash:321B、40B 激活、带视觉,25GB
- Kimi K3:2.8T,32GB 起,月之暗面原生 MXFP4 流式读取
- DeepSeek广告 V4 Flash:284B,16GB 起,官方仓直接流、免转换
- DeepSeek V4.1 Flash:552B、含视觉,为 V1.1.0 新增的第 9 个引擎
- 通义千问广告 Qwen3:35B 激活、3B,两张 8GB 卡实测 1.44 到 10.05 token/s,约 7 倍差距
- 以及带音频、带视觉的多模态模型
换机器只换专家住哪,模型本身不变。
真机实测:硬件改变成绩,不改变答案
社区提供的真机实测数据展现了从工作站到笔记本的完整跨度:
| 硬件 | 专家所在层 | 速度 |
|---|---|---|
| 6 张 RTX 5090 | 全部显存/内存 | 9.0–9.2 token/s |
| Graviton 4 64核 + 512GB | 内存钉住 98% | 8.0 token/s |
| 双路志强 + 1TB 内存 | 全部钉在内存 | 5.42 token/s |
| MacBook Pro M5 Max 128GB | Metal 统一内存 | 2.0 token/s |
| 25GB 开发机 | 从 NVMe 流式读 | 0.05–0.1 token/s |
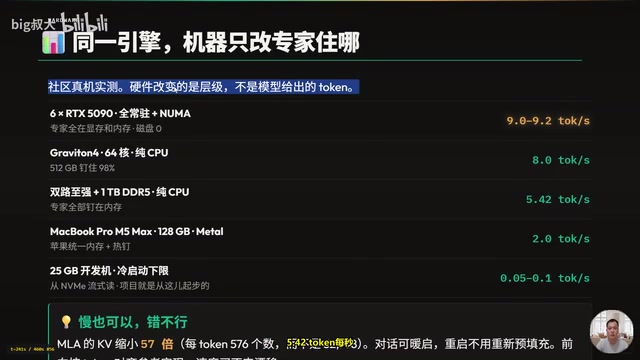
25GB 开发机正是项目起步的场景——慢可以,但错不行。为降低对话成本,引擎还用了 MLA 把 KV 缓存缩小,每个 token 只需 576 个数而不是 32768,对话可以暖起、重启不用重新预填充。
MLA(Multi-head Latent Attention,多头潜在注意力)是 DeepSeek 团队提出的一种 KV 缓存压缩技术,已被 GLM 等模型采用。标准多头注意力需要为每个 token 存储完整的 Key 和 Value 向量(GLM 中为 32768 个浮点数),随对话轮次增长,KV 缓存会快速膨胀并占满有限内存。MLA 通过将 KV 投影到一个低维潜在空间来存储,再在计算时解压,把每 token 所需缓存从 32768 个数压缩到 576 个数,降幅约 98%。对于内存本就紧张的本地推理场景,这意味着可以支持更长的对话上下文而不触发内存溢出,同时重启后可以重新加载已有缓存继续对话,而非每次都从头预填充。
可视化工作台:看得见的专家开火
Colibri 附带的 coli web 仪表盘不是示意图,而是真实工作台。它实时显示每轮耗时、VRAM/RAM/磁盘读取情况。角落还有一个 mini 大脑视图 Atlas,把 19456 个专家画成活皮层:颜色代表存储层级,亮度代表路由热度,本轮被点到的专家闪白。
Atlas 已分析的专家会按主题聚团——诗歌、法律、中文、SQL 等位置来自实测路由分布,而非人为标注,嵌入拖拽即可旋转查看。看到满屏专家跟着提问逐个亮起,确实颇有观赏性。
新版本改进与几条硬承诺
V1.1.0 除了新增 DeepSeek V4.1 Flash 引擎(FP8 稠密 + FP4 专家,203GB 的 N-gram 记忆每次只读几百字,启动一轮从 78.7 秒降到 25.1 秒),还修复了跨平台的内存预算问题。此前 Windows 和 macOS 会去读 Linux 的内存文件、导致预算塌成 1GB,coli tune 直接撑爆;现在每套系统都能读到真实可用内存。
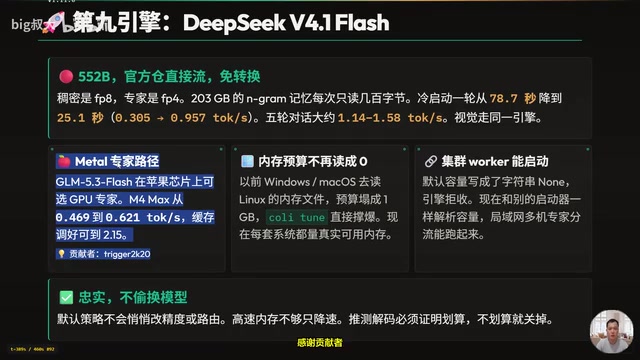
项目立下几条明确承诺:默认策略不会悄悄改进度或路由;高速内存不够时只降速;推测解码必须证明划算,否则关掉。用作者的话说——忠实、不偷换模型。
上手其实很简单
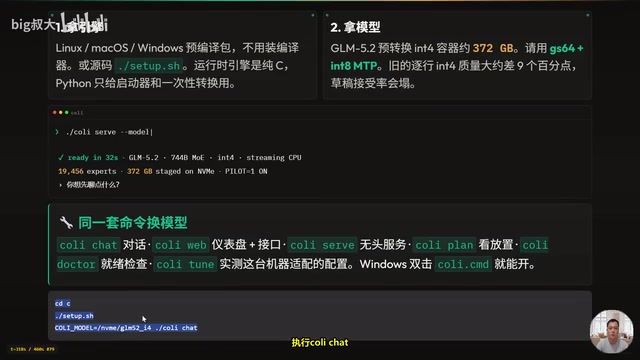
程序只有几百 KB,模型自带几个转换工具。第一步拿引擎,Linux/macOS/Windows 都有预编译包,不装编译器也能跑源码。第二步拿模型,比如 GLM 5.2 预转换 int4 容器约 372GB。常用命令包括 coli chat(对话)、coli web(仪表盘)、coli serve(无头服务)、coli plan(看放置)、coli doctor(就绪检查)、coli tune(为本机调优)。Windows 双击 coli.cmd 即可开跑。
三句话总结
这个项目本质上可以浓缩成三句话:
- 模型不必装进显存,它需要被正确放置。
- 权重是数据,不是必须驻留的状态。
- 越用越快,是因为引擎在学习你的负载。
Colibri 用纯 C、零依赖的方式,把 VRAM、内存、磁盘统一成一套推理层级——25GB 内存加一块有耐心的硬盘,就能把 744B 大模型跑起来。对希望在本地掌控权重、又受限于消费级硬件的开发者来说,这是一条值得关注的新路径。
相关推荐
Vibe Coding 深度解读:从写代码到指挥AI的一人公司实战路径
Vibe Coding 是什么?本文解读从「人写代码」到「人指挥AI」的开发新范式,涵盖Claude Code、Codex、Cursor等工具协同、全链路闭环、多端开发与AI自动化运营,剖析一人公司与超级个体的机会与误区。
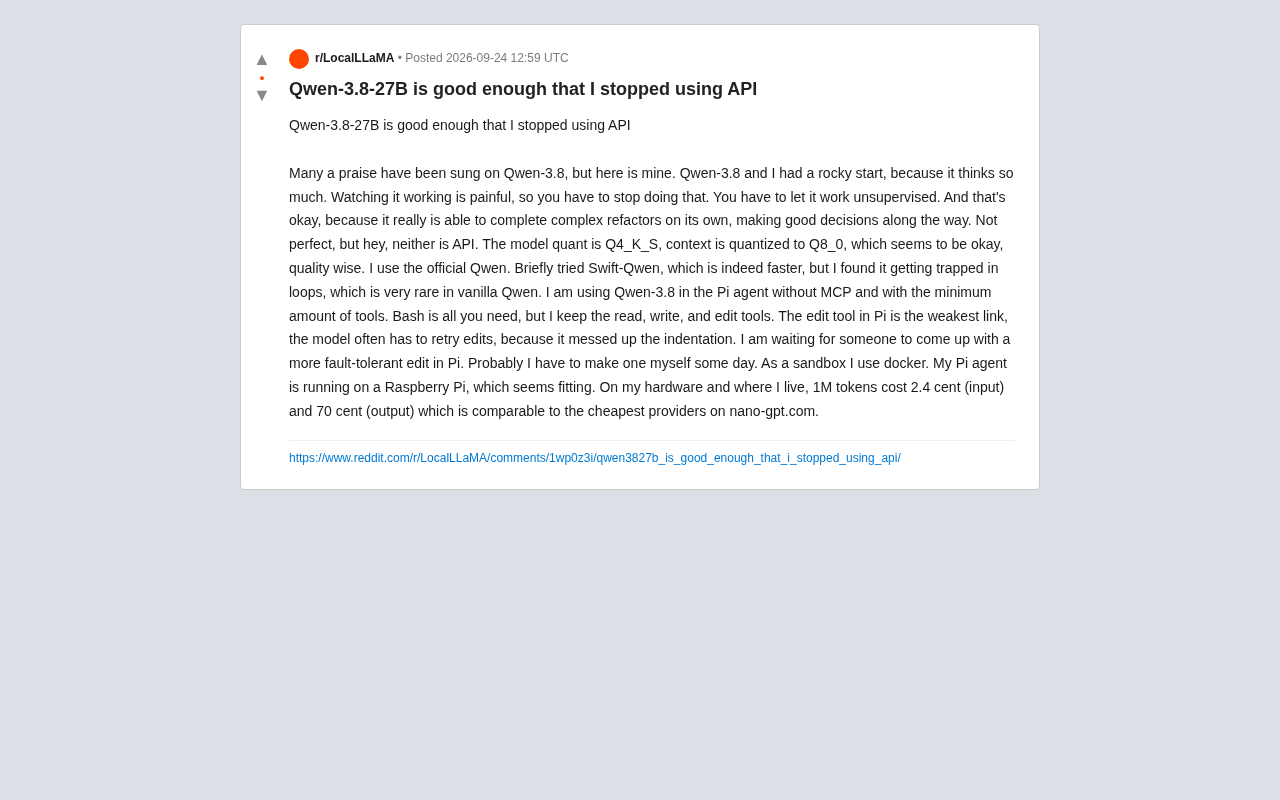
本地跑 Qwen-3.8-27B 替代 API:一位开发者的实战体验
一位 Reddit 开发者分享用本地 Qwen-3.8-27B 完全替代云端 API 的实战经验,涵盖 Q4_K_S 量化、Pi agent 极简工具链、树莓派部署与详细成本核算,探讨开源大模型「够用」的临界点。
生产环境中如何验证AI Agent的行为?运行时校验实战指南
AI Agent在生产环境代表用户执行操作时如何验证其行为?本文从非确定性输出、不可逆副作用等挑战出发,梳理策略护栏、人在回路、运行时追踪、LLM评判等验证方法,帮助团队构建分层防御体系。