从1000倍FLOPs到6倍延迟:GPT-2 KV缓存实测拆解

开发者手写 GPT-2 KV 缓存,实测 FLOPs 降千倍而延迟仅降 6 倍。
一位开发者在单张 A40 上用 PyTorch 实现 GPT-2 small 与 KV 缓存,并通过与 Hugging Face 的 logits 对比及 200 多 token 的逐 token 贪心输出校验保证正确性。实验显示,上下文长度 1000 时 FLOPs 估算下降约 1000 倍,但单 token 延迟仅从 29.69 ms 降至 4.95 ms(约 6 倍),生成 1016 个 token 的总耗时从 14.66 秒降到 5.03 秒。缓存后单 token 延迟基本不再随上下文增长,说明瓶颈已从矩阵乘法转移到 kernel 启动或显存带宽等开销。作者还揭示了两个陷阱:错误的缓存排列能通过单 token 测试;cuBLAS workspace 与分配器 block size 会污染显存基线。
一个被"理论收益"掩盖的工程真相
KV 缓存(KV Cache)几乎出现在每一篇讨论大模型推理优化的文章里,但大多数人只是重复"它能避免重复计算"这句话。Reddit 上一位开发者做了一件更有价值的事:亲手在 PyTorch 中实现 GPT-2 small 和 KV 缓存,把纸面数学与真实推理测量对齐。
实验设置相当克制、也相当严谨——单张 NVIDIA A40,fp32 且关闭 TF32,batch size 1,贪心解码,每次计时都做 CUDA 同步,每个上下文长度取五次运行的中位数。加载预训练权重后,他把 logits 与 Hugging Face 实现做了对比,并验证了缓存与未缓存的贪心输出在 200 多个 token 上完全一致。
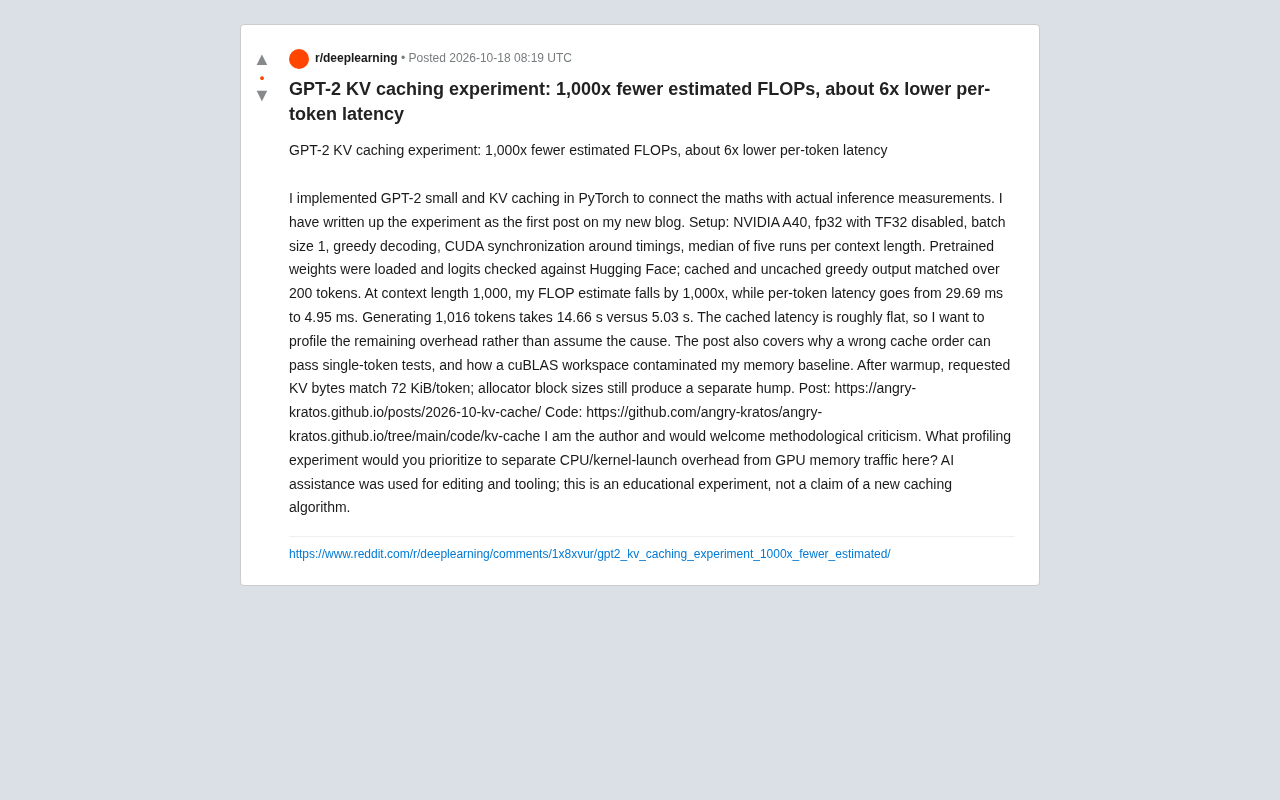
结果呈现出一种值得玩味的落差:在上下文长度 1000 时,FLOPs 估算下降约 1000 倍,而单 token 延迟只从 29.69 ms 降到 4.95 ms,约 6 倍。生成 1016 个 token 的总耗时从 14.66 秒降到 5.03 秒。理论与实测之间那道巨大的缝隙,才是这次实验真正的信息量所在。
FLOPs 省了 1000 倍,延迟为什么只有 6 倍
算术强度的变化
未缓存时,每生成一个 token 都要对全部历史上下文重做注意力计算,计算量随上下文长度线性增长;缓存后,历史 token 的 Key/Value 被保存下来,每步只处理新 token。所以在长上下文下,FLOPs 的下降幅度会非常夸张。
但延迟并不等价于 FLOPs。作者观察到一个关键现象:缓存后的单 token 延迟基本是平的,不再随上下文显著增长。这说明瓶颈已经不是矩阵乘法,而是别的东西——可能是 CPU 侧调度、kernel 启动开销,或者 GPU 显存带宽。
算术强度(arithmetic intensity)指一个计算任务中浮点运算次数与所需内存访问字节数的比值,单位通常是 FLOP/Byte。它决定了程序在硬件上究竟受限于算力还是带宽:当算术强度高于硬件的 “拐点”(即峰值算力除以峰值带宽)时,任务属于计算受限;低于拐点时则属于内存带宽受限。KV 缓存把每步的矩阵乘法从 “大矩阵乘大矩阵”退化为 “向量乘矩阵”,运算量骤减,但同时仍要读入全部缓存的 K/V,算术强度因此大幅下降,性能瓶颈也从 SM 的运算单元转移到 HBM 带宽和 kernel 启动等固定开销上。这解释了为何 FLOPs 降 1000 倍而延迟只降 6 倍——后者受限于另一条完全不同的资源曲线。
为什么作者拒绝下结论
值得称道的是,作者明确表示想"对剩余开销做 profiling,而不是假设原因"。在推理优化领域,这种克制很稀缺。很多博客会把 6 倍延迟直接归因于"内存带宽受限",但单 batch、fp32、A40 这个组合下,真实原因需要数据说话。他在文末公开提问:要区分 CPU/kernel 启动开销与 GPU 显存流量,应该优先做哪个 profiling 实验?
要区分 CPU 调度/kernel 启动开销与 GPU 显存带宽,常用的 profiling 手段有几类:NVIDIA Nsight Systems 提供时间线视图,能直观看到 CPU 侧下发与 GPU 执行之间的空隙,从而量化 launch overhead 与同步等待;Nsight Compute 则给出单个 kernel 的吞吐、achieved occupancy、DRAM 读写字节数与 “内存吞吐占峰值百分比”,可直接判断是否带宽受限。PyTorch 自带的 torch.profiler 能以较低成本采集 CPU/CUDA 活动并导出 Chrome trace,适合先做粗筛。实践中通常先用 Nsight Systems 看时间都花在哪,再对热点 kernel 用 Nsight Compute 做细粒度分析;若怀疑是 Python/调度开销,还可对比 CUDA Graph 捕获后的延迟变化。
两个容易翻车的实现细节
缓存顺序错了,单 token 测试也能通过
作者专门写了一节,讲为什么错误的缓存排列顺序可以通过单 token 测试。原因不难理解:只生成一个 token 时,缓存里只有一条历史记录,任何排列都退化成同一个结果。只有序列变长、缓存出现多条记录后,位置错配才会暴露成输出偏差。
这给所有自测推理实现的人提了个醒:单步验证几乎无法证明缓存正确性。作者的做法是让缓存与未缓存版本在 200 多个 token 上逐 token 对比贪心输出,这才是有效的回归测试。
在自回归注意力中,位置信息通过两种方式进入计算:一是显式的位置编码(GPT-2 使用可学习的位置嵌入,加到 token 嵌入上),二是注意力本身对序列顺序的依赖。如果缓存中 K/V 的排列顺序与查询向量所假设的位置错位,只有序列长度大于 1 时才会出现 “查询在第 t 位、却读到第 s 位缓存”的错配。加上因果掩码要求每个位置只能看到自己及之前的 token,顺序错误会直接改变可见集合,从而改变 softmax 权重和输出。单 token 场景下缓存长度为 1,任何排列都等价,因此这类 bug 具有极强的隐蔽性,必须用长序列逐 token 比对才能暴露。
cuBLAS workspace 污染了显存基线
第二个细节更偏工程:cuBLAS 的 workspace 会占用显存,从而污染显存占用的基准测量。作者在预热(warmup)之后测得,请求的 KV 字节数与 72 KiB/token 吻合,但分配器的 block size 仍会制造出另一个"鼓包",让显存曲线看起来比理论值多出一块。
这意味着,如果你只用 torch.cuda.memory_allocated() 之类的粗粒度指标去验证 KV 缓存的内存收益,很容易得出错误结论。区分"请求的字节"与"分配器实际占用的块"是必要的。
cuBLAS workspace 是 cuBLAS 在执行某些矩阵乘法时为临时结果或内部算法预留的显存区域,其大小由 CUBLAS_WORKSPACE_CONFIG 环境变量或库的默认策略决定,通常在首次调用相关 kernel 时才分配。它不属于用户张量,却会计入 PyTorch 缓存分配器所管理的显存池,因此在 warmup 之后测量显存时会出现一块无法归因于 KV 缓存的额外占用。同理,PyTorch 的 CUDA 缓存分配器以固定大小的 block 为单位向驱动申请显存,实际保留的字节数往往大于请求的字节数,memory_allocated() 反映的是已分配张量,memory_reserved() 则包含这些块级碎片。要验证 KV 缓存的理论内存收益,应结合 torch.cuda.memory_summary() 和逐层张量尺寸核算,而非只看单一粗粒度指标。
这次实验真正的价值
从工程角度看,这个项目的贡献不在"发现了 KV 缓存有用"——那是常识。它的价值有三点:
第一,它给出了一个可复现的、带正确性校验的基线。代码和文章都公开在作者的个人博客与 GitHub 仓库中(angry-kratos.github.io),任何人都能跑同一组数字。
第二,它把"理论加速比"和"端到端延迟"的差距量化了出来。1000 倍对 6 倍,这个比例本身就是对"FLOPs 决定一切"这种直觉的反驳。对于正在做推理服务容量规划的人来说,这个差距直接对应成本模型的误差。
第三,它诚实地标注了自己的边界。作者明确说明这是教育性质的实验,不主张提出了新的缓存算法,AI 仅用于编辑和工具链辅助。
如果你也在实现自己的推理栈,这个实验给出的下一步很清晰:先把正确性测试从单 token 扩展到长序列,再用 profiler 拆开那 4.95 ms 里到底有多少花在 kernel 启动、多少花在显存搬运上。
相关推荐

Workbuddy零基础入门:桌面AI智能体如何落地工作流
Workbuddy桌面AI智能体零基础教程解读:从安装、积分领取到文件管理与自动化工作流搭建,对比CodeX的适用场景与成本差异,帮助职场人完成从AI提问者到AI管理者的思维转变。

OpenAI智能体新栈:计算机操作、决策API与超速工作流
OpenAI Dev Day发布智能体新栈:Computer Use操作速度超越普通人,Decisions API基于Luna实现极低延迟分类,Agents API开放同源计算机操作能力,GPT-6.1 Sol成本仅为Astra七分之一。本文梳理核心更新、实测数据与开发者落地要点。

梁文峰开源推理框架DeepInfo,硬刚美国禁令
DeepSeek在开源模型后再开源推理框架DeepInfo,包含GPU/CPU交叉流水线、小模型预判大模型复核、华为昇腾与英伟达芯片全面适配等技术,直面美国联邦禁令。本文解析其对AI产业落地的意义与开源策略。