#推理优化
共 26 篇相关文章

DeepSeek V4.1 Flash:读写分离如何重构长对话成本
DeepSeek V4.1 Flash 通过更短输入路径、共享注意力记忆与选择性重建,实现读写分离,重构长对话场景下的推理成本结构,降低多轮交互的边际算力开销。
LLMD项目揭秘:开源推理如何实现生产级扩展
IBM 杰出工程师 Carlos Costa 分享 LLMD 项目最新进展:开源推理如何实现生产级扩展,涵盖智能体服务性能、多租户 QoS、零停机运维等关键能力,并将在 PyTorch Conference 上与 Red Hat、Google 联合展示。

多节点LLM推理编排拓扑:性能瓶颈与架构取舍
深入解读多节点LLM推理编排拓扑评估:标准以太网下跨节点张量并行的同步延迟问题,以及分离式prefill/decode配合KV感知路由在高并发多轮场景下的可预测性优势与架构权衡。

从芯片到Token经济学:AI推理基础设施的全栈优化
SemiAnalysis创始人Dylan Patel加入Fireworks Forge演讲阵容,探讨从芯片到应用层的AI推理基础设施全栈优化与Token经济学,解析大规模推理的成本结构。
SGLang-Diffusion:面向扩散模型的高性能服务框架
SGLang-Diffusion 是专为扩散模型打造的高性能推理引擎与服务框架,支持离线与实时场景,涵盖并行化方案与执行路径优化,将在 PyTorch Conference 上正式亮相。

KVFetch:填补KV缓存压缩缺失的时序召回通道
arXiv新论文KVFetch揭示KV缓存压缩的结构性缺陷——顺序遗忘,并提出无需训练的时序召回通道,在RULER-16K上将逐字拷贝得分从0.8恢复到78.4,为长上下文LLM推理提供即插即用的优化方案。

AttSVD:用注意力引导的SVD压缩KV缓存,内存砍半不掉点
AttSVD提出基于注意力引导SVD的KV缓存低秩压缩方法,无需训练,沿特征轴压缩而非删除token,在LongBench等基准上仅用50%显存即可保持与完整缓存相当的精度,为长上下文大模型推理提供新思路。

GPT-6.1 Sol「泄露」疑云:循环与嵌套模型架构浮出水面
一篇 Reddit 热帖通过推理速度数据反推 GPT-6/6.1 Sol、Astra、Luna 的底层架构,提出循环 Transformer 与嵌套模型可能同时被用于大规模低成本部署。本文梳理其推演逻辑与对开源社区的启示。

推理延迟的隐形成本:模型加载时间被你忽略了吗?
测试显示推理服务中模型加载可能比推理本身更耗时:首次请求13.9秒、后续仅1.6秒。本文解析模型可用性延迟、状态可观测性,以及常驻、按需加载、模型路由三种生产部署策略。

GLM-5.3 在 8×MI355X 实现 469 tok/s:vLLM 与 TileRT 分离式推理解析
TileRT 与 AMD 团队在 8×MI355X 上让 GLM-5.3 实现 469 tok/s 单用户解码,通过 vLLM 处理 prefill、TileRT 处理延迟关键的 decode 的分离式架构。本文解析其技术原理与行业意义。

金丝雀发布:生产环境零停机升级AI模型的实战方法
金丝雀发布(Canary Rollout)让生产环境AI模型升级实现零停机。本文解析分阶段流量爬升、指标门控与自动回滚三大机制,以及它在专用推理场景的落地实践。
过拟合推理引擎崛起:专用化如何重塑AI本地部署
一批名为Strata、ninfer、DwarfStar的"过拟合推理引擎"正在崛起,它们放弃通用性、专注单一硬件与模型的极致性能优化。本文解析这类专用推理运行时的技术逻辑、价值主张及其对AI本地部署民主化的意义。
实时AI推理为何贵56倍?持续推理与常驻内核的破局之道
实时AI模型为何服务成本高达应有的56倍?本文解析请求式推理与持续推理的差异,拆解全双工语音模型在H100上从1到56并发会话的优化方案——常驻GPU内核、同步批处理与编译期调度。

Fireworks推出Ember-1:推理更短,Token省40%
Fireworks Research发布Ember-1推理模型,基于Kimi K3构建,可减少约40%的token消耗同时保持顶级质量。本文解析其效率优化的意义与行业价值。

TPU megakernel 让 Kimi K3 达到 709 tokens/s,超越 GB200
@inferact 团队开源针对 Kimi K3 的 TPU megakernel,实现 709 tokens/s 吞吐,超越 GB200 的 450 tokens/s。文章解析其将 92 层 MoE 融合进单一 Pallas 内核及跨层权重预取的优化思路。
单张RTX 5090跑出16 FPS:LingBot-World 2.0实时世界模型优化实战
开发者将LingBot-World 2.0 1.3B世界模型在单张RTX 5090上优化到实时16 FPS,比SGLang快2.5倍、比NVIDIA FlashDreams快1.9倍,并开源代码。本文解析其低精度运算、SageAttention和自定义内核三大优化手段。
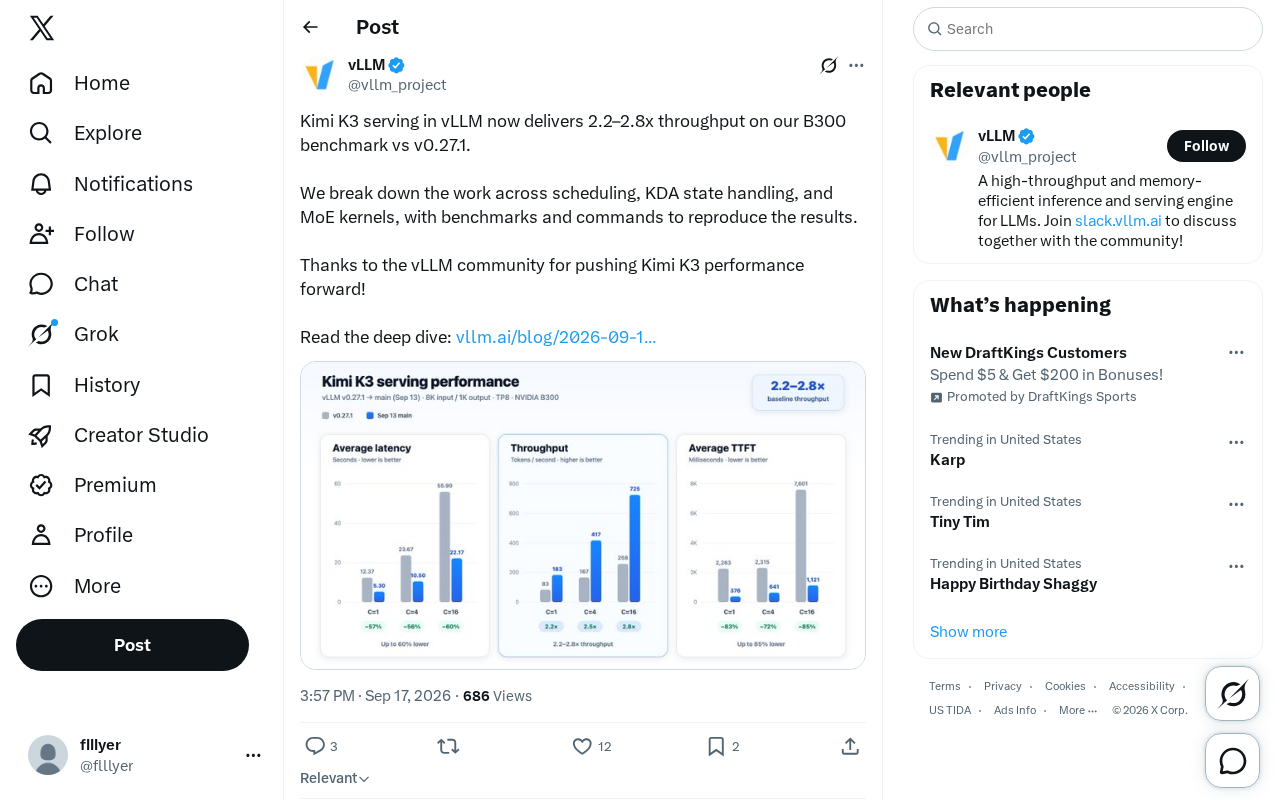
vLLM 部署 Kimi K3 吞吐量提升 2.2–2.8 倍:性能优化拆解
Kimi K3 在 vLLM 上的部署性能获得显著提升,B300 基准测试显示吞吐量较 v0.27.1 提升 2.2–2.8 倍。本文拆解调度、KDA 状态处理与 MoE 内核三大优化方向及其对推理成本的影响。
推理网络:用阈值策略优化大模型推理成本
arXiv 最新研究提出「推理网络」图框架,用于优化大语言模型的推理成本。论文证明最优模型激活策略具有阈值结构:先用低成本模型,置信度不足时再调用昂贵模型,在开源 LLM 上实现显著降本。