从传统开发到AI Agent:颠覆认知的六大思维转变

Agent开发颠覆传统编程直觉,资深工程师须重构六大核心工作逻辑。
本文指出一个反常现象:越是经验丰富的工程师,在构建AI Agent时反而越容易碰壁。根本原因在于Agent开发要求颠覆传统软件工程的核心直觉。文章梳理了六个必须完成的思维转变:用文本和上下文取代布尔值与硬编码状态;将控制流交给大模型动态决策而非手写穷举分支;把运行时错误视为新输入而非重启信号;用大规模可靠度评估(Evals)取代确定性单元测试;为Agent构建语义自述式的专属API;以及树立"为删除而构建"的一次性软件心态。整体主张:放下控制欲、拥抱不确定性,才是在AI时代存活的开发者心法。
为什么资深程序员做Agent反而更容易翻车
有个反常识的现象正在AI Agent开发圈里蔓延:越是身经百战的资深工程师,在构建智能体时反而摔得越惨。按理说老手学新技术应该最快,但现实是,用传统的标准套路去死磕Agent,通常会碰一鼻子灰。
原因在于,Agent这东西从根本上掀翻了程序员过去十几年积累的工作逻辑。传统软件开发里,你得像个神经高度紧张的交通警察,盯着每一个红绿灯、每一条车道,连车速都要管。而做Agent,你需要变成一个悠闲喝着咖啡的调度员——你只要喊一句「去伦敦」然后撒手就行了。Agent会自己琢磨是坐火车、赶飞机,还是开个小潜水艇摸过去。你只看最后结果,别去管它到底走了哪条路。
这种控制权的让渡,正是让老兵们最不适应的地方。本文梳理这套思维转变的六个核心维度,帮助从传统软件开发平滑过渡到Agent构建。
文本成为新的状态:告别布尔逻辑
第一个转变,是接受「文本成了新的状态」。这意味着要狠下心,跟过去那些死板的布尔值和数据结构说再见。
以前做审批系统,界面上就是两个冷冰冰的按钮:同意或者拒绝,非黑即白的布尔逻辑。但Agent能听懂语义和弦外之音。你可以直接丢给它一段话:「计划通过,但重点盯紧美国市场,直接略过加州」。Agent根本不需要什么布尔值,它嚼碎了这段文字里的上下文就能照办,把个性化体验拉到了全新维度。
再举个做菜APP的例子:平时你习惯看摄氏度,今天突然想用华氏度烤披萨。以前你得去数据库里把「单位=摄氏度」的硬编码改成华氏度。现在呢,一句提示词的事——「今天用华氏度」,Agent就能结合语境自己变通。文本和上下文,才是现在的王道。
交出控制权:别再跟大模型较劲
老手们最容易犯的毛病,就是非得把AI塞进那种一步步安排好、铁板一块的工作流里。
看个经典的客服流程:用户喊「我要退订」,系统立马跳到第二步打上「流失客户」标签,然后像机器人一样死板地走完退订流程。但如果用户随口说了句「要是给我打个八折我也不是不能留下」,这种老系统瞬间就傻眼了——它根本不知道怎么跳出预设的剧本。

用户的意图本来就是动态的、千变万化的。把方向盘交给大模型吧:当用户改变主意,模型能实时跟用户讨价还价、提供替代方案,轻松应付突发状况。你根本不用累死累活写满屏代码来处理边缘情况,模型自己就能见招拆招。
这里涉及的核心概念是"控制流"(Control Flow)的归属问题。传统软件工程中,控制流由开发者通过条件分支、状态机或流程图显式定义,每一个分支都有对应的代码路径。而在Agent架构中,控制流被委托给大语言模型(LLM)在运行时动态决策——这种模式有时被称为"LLM作为路由器"(LLM as Router)。模型根据当前对话上下文、用户意图和可用工具,自主决定下一步应该调用哪个函数、跳转到哪个流程节点,甚至是否需要向用户反向澄清需求。这种架构的代价是可预测性降低,收益是对长尾边缘场景的覆盖能力大幅提升,无需为每种可能性编写穷举式的if-else代码。
错误只是新的输入:告别粗暴重启
第三个转变,是把「错误只是新的输入」这个理念内化。就像现在流行的编程语言那样,把错误和返回值一视同仁地看待。
以前写代码,HTTP请求很便宜。一个任务跑到第14分钟突然崩溃了,一般怎么办?简单粗暴,直接从零重跑一次,反正重试不花几个钱。但在Agent这里千万别这么干——跑Agent那是真金白银地烧算力,而且它脑子里存着一大堆上下文。
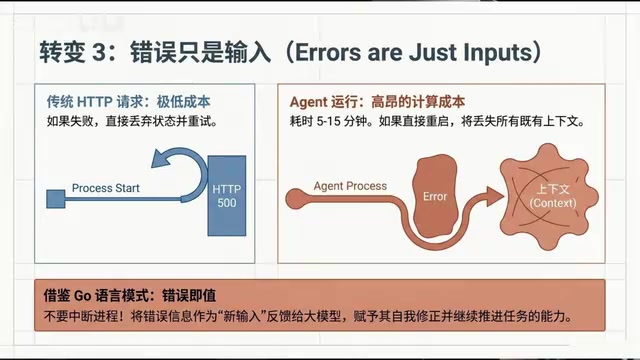
如果在第14分钟报错,正确做法是把这个错误当成新输入甩给模型:「前面这条路不通,换个方式绕过去」。这样不仅省了算力的钱,更重要的是保住了之前的上下文,让任务继续往前推进。这种「松弛感」正是Agent开发所需要的。
从单元测试到评估:拥抱不确定性
这一点让很多老程序员后背发凉:闭着眼睛都能写的单元测试,在新世界里基本算废了。
以前的逻辑是确定性的:输入A丢给代码B,输出一定是C,你可以写断言去测试它。但把输入A丢给Agent,就算跑100次,它的中间步骤和最终输出可能都不一样。这种不确定性,真能把习惯了掌控一切的资深工程师逼疯。
更关键的是,我们不能再满足于「这个功能能不能跑通」。如果一个Agent十次里只有一次完美,剩下90%不是翻车就是抽风,这玩意绝对不敢放到生产环境。所以测试重点变了:我们要测的是它在大规模运行下的可靠度,而不是单一断言。
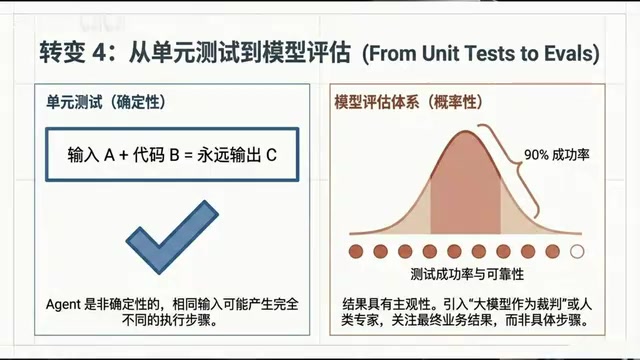
Agent的结果往往非常主观。比如让它总结一篇调研报告,没有任何死板的单元测试能判断这报告写得好不好。这时候就要引入评估机制:要么请真人专家来打分,要么让另一个更聪明的大模型当裁判,客观评估最终质量。
这套针对AI系统的测试新范式通常被称为"评估"(Evals),是当前LLM应用工程领域最活跃的研究方向之一。与单元测试的确定性断言不同,Evals通常采用以下几种形式:一是基于标注数据集的打分,用黄金答案与模型输出做相似度对比;二是"LLM-as-Judge",即用一个能力更强的模型(如GPT-4o)作为裁判,对被测模型的输出质量按照预设标准打分;三是人工标注,招募领域专家对输出进行盲评。评估的核心指标也从单次通过/失败转向通过率(Pass@k)、一致性(Consistency)和鲁棒性(Robustness)等统计指标。OpenAI、Anthropic等主流机构均已将Evals能力视为AI应用能否进入生产环境的关键门槛。
为Agent打造专属API
Agent一天天在变聪明,但后端的API还是老样子,这里面的摩擦太大了。
一个干了十年的后端老手看到delete_item这个接口,闭着眼睛都知道它是删数据的。但Agent没有你十年的业务经验,它只能看到函数结构和注释。所以工具和接口必须自述、有语义:参数、文档写得清清楚楚,这样Agent才能真切明白调用这个接口到底会发生什么。这是填平Agent能力与传统后端之间鸿沟的关键一步。
这一理念对应的工程实践通常称为"工具定义"(Tool Definition)或"函数调用"(Function Calling)。主流LLM平台(如OpenAI的Function Calling、Anthropic的Tool Use)要求开发者以结构化的JSON Schema格式声明每个可调用工具的名称、参数类型及自然语言描述。模型正是依赖这些描述来理解工具的语义,而非靠命名约定或代码实现。这意味着传统后端开发中可以"意会"的命名惯例(如RESTful动词约定)对Agent完全失效。一个好的工具定义需要像给新员工写操作手册一样:明确说明该工具做什么、不做什么、副作用是什么、什么情况下不应调用。描述质量的高低,直接决定Agent调用工具的准确率。
为删除而构建:一次性软件的心态
如果想在这波AI浪潮里活下来,最后一个理念必须刻在骨子里——为删除而构建。快速盘点这些生存法则:
- 信任模型:让它放手去干,但一定要有验证机制
- 保留语义:别管什么死板的布尔值,语义和上下文才是王道
- 恢复优先:遇到错误别动不动就重启,要为系统恢复而设计
- 拥抱评估:放下对断言的执念,拥抱系统性的全面评估
软件注定是一次性的。听着挺苦涩,但也让人如释重负。在这个AI狂奔的时代,你今天通宵敲出来的完美代码,也许明天就被更聪明的模型重写了。既然如此,何必死死抱着老包袱?放下控制欲,拥抱不确定性——这或许才是成为下一个时代开发者的必修课。
相关推荐

Harness架构实战:企业级智能体项目拆解与AI岗位进阶指南
深度拆解基于Harness(驾驭工程)架构的企业级智能体实战项目,涵盖多模型配置、ASGI部署、MCP协议对接ERP系统、Sandbox沙箱隔离等核心模块,帮助AI大模型求职者理解工程化落地方向的面试要点。

fal.ai API密钥配置与n8n集成完整教程
手把手教你创建 fal.ai API 密钥并连接到 n8n:涵盖官方集成节点配置、凭证保存、HTTP 请求替代方案以及密钥安全注意事项,快速跑通首次 AI 媒体生成工作流。

系统设计面试笔记开源项目:2.4万星的学习利器
开源项目 liquidslr/system-design-notes 整理了经典书籍《System Design Interview》的学习笔记,GitHub 收获 2.4 万 Star。本文解析其内容价值、适用人群及系统设计面试复习建议。