Harness架构实战:企业级智能体项目拆解与AI岗位进阶指南

面向AI大模型就业的企业级智能体架构解析,涵盖Harness编排、MCP协议、沙箱隔离等核心工程实践。
本文以一个贴近企业的智能采购助手项目为例,系统梳理了AI大模型工程化落地方向的核心技术栈。文章首先区分了算法研究与工程化落地两条就业路径,指出后者门槛更友好且招聘需求更旺盛。随后重点介绍Harness(驾驭工程)架构——一种通过多模型配置和结构化编排管控智能体行为的新型框架,并逐层拆解其关键组件:FastAPI+uvicorn构成的ASGI生产部署链路、基于MCP协议打通已有ERP等存量系统的集成方案、以及用Docker容器实现Skill执行隔离与多用户数据隔离的Sandbox沙箱机制。整套架构完整覆盖了面试官最关心的工程落地维度,帮助求职者建立系统性认知。
AI大模型就业市场正在悄然变化。面试官对求职者的要求比以往更高,尤其是在大模型应用方向,仅靠基础的调用和微调经验已经难以脱颖而出。这篇文章基于一个贴近企业的实战项目,梳理Harness(驾驭工程)架构下复杂智能体的完整设计思路,帮助求职者理解当前面试官真正关心的技术点。
AI大模型的两条就业路径
大模型岗位大致可以分成两个方向。第一个方向是算法研究,专门负责训练和研发新版本的基座模型,比如参与某个模型下一个大版本的预训练工作。这类岗位对学历和论文要求较高,通常需要985硕士及以上背景。
第二个方向是大模型工程化落地,注意这里不等同于简单的应用开发——它涵盖了应用开发,但范围更广。这个方向的核心是拿着已有的基座模型,结合企业实际业务做定制化开发,可能包括微调、智能体开发、推理优化,甚至调用传统算法(如用YOLO做目标检测)。它一般不涉及模型的预训练。
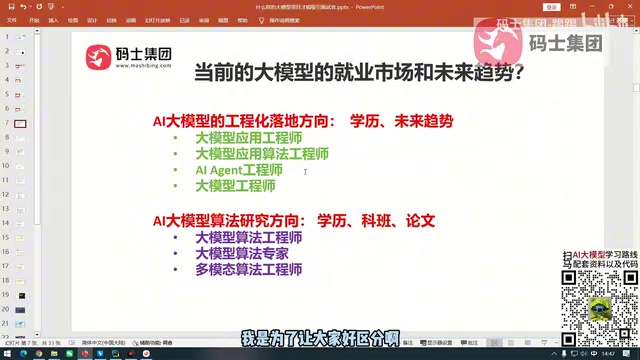
需要强调的是,岗位名称在业内并没有统一标准。同样是做微调的工作,A公司可能叫它"大模型算法工程师",B公司可能叫"大模型应用工程师"或"智能体工程师"。求职者更应关注岗位背后实际要做的事情,而不是纠结于头衔。对大多数人来说,工程化落地方向门槛相对友好,也是当前招聘需求的主力。
什么是Harness(驾驭工程)架构
本项目最大的亮点在于采用了Harness架构,也就是所谓的"驾驭工程"。这是一种面向复杂任务处理的新型智能体架构,正是当前不少面试官特别感兴趣的技术方向。
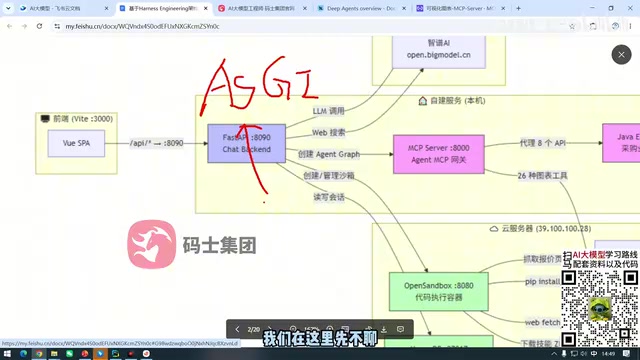
与早期简单的"调用大模型API返回结果"不同,Harness架构强调的是对智能体行为的系统化编排与管控。它需要连接的组件相当多:外部的推理模型、摘要模型,以及已有的企业系统。在本项目中,推理模型使用了DeepSeek广告,备用模型用的是智谱,另外还配置了多个摘要模型。这种多模型配置的设计思路,本身就体现了企业级项目在稳定性和成本上的权衡。
Harness架构的核心理念来源于"驾驭"这一隐喻——就像骑手通过缰绳控制马匹,开发者通过一套结构化的编排层来约束和引导大模型的行为,而非放任模型自由生成。与ReAct(推理+行动循环)、AutoGPT等早期智能体框架相比,Harness更强调对智能体生命周期的全程管控:任务分解、工具调用顺序、异常回退、多模型切换策略都被纳入统一的编排逻辑中。多模型配置(主模型+备用模型)是其典型特征之一,当主推理模型出现限流、超时或返回质量不达标时,系统可自动降级到备用模型,从而在不牺牲可用性的前提下控制API调用成本。这种设计思路与微服务架构中的熔断降级概念高度类似,对有分布式系统背景的工程师而言尤为容易理解。
项目整体架构:前后端分离与ASGI部署
这个项目是一个基于已有ERP系统的智能采购助手,典型的前后端分离结构。前端采用Vue(端口3000),后端使用FastAPI(端口8090)。
为什么智能体项目需要这样一套后端服务?关键在于生产环境的部署规范。Python开发的智能体在企业中通常要跑在ASGI服务上,本项目使用uvicorn作为ASGI服务器。
ASGI之所以成为智能体部署的标准选择,主要解决两个核心问题:
- 高并发异步处理:能够应对大量异步请求
- 流式输出:真正实现智能体回复的流式返回,这是提升用户体验的关键能力
换句话说,个人玩票可以随意部署,但企业生产环境几乎都会走"智能体 → ASGI服务 → 前端界面"这条链路。理解这一点,对面试中回答"如何将智能体落地到生产"这类问题非常有帮助。
对接已有系统:MCP协议与网关
大多数企业在智能体流行之前,早已拥有自己的业务系统——可能是CRM、ERP或其他平台。一个真正落地的智能体几乎不可能独立存在,它必须与这些已有系统对接、交付数据。
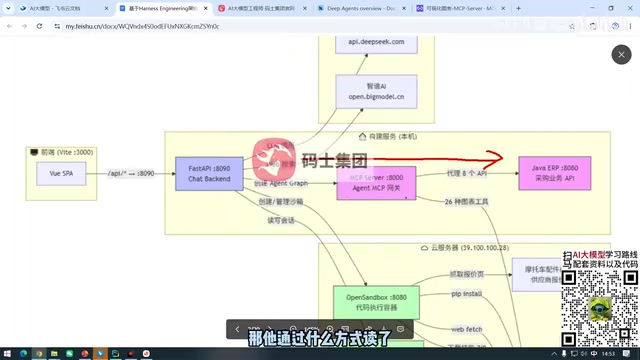
本项目以ERP为例,假设公司已有一套ERP系统,而智能采购助手需要读取其中的数据。项目特意设计了通过MCP协议配合网关的方式来读取已有Java项目中的ERP数据。这种"智能体 + 存量系统"的集成模式,恰恰是企业级定制化开发中最真实的场景,也是区分"玩具项目"和"实战项目"的分水岭。
此外,作为采购助手,它还需要关联供应商信息,因此会通过Skill或网络爬虫的方式访问供应商官网上的报价页面等公开信息。
MCP(Model Context Protocol,模型上下文协议)是Anthropic于2024年底提出并开源的一套标准化协议,旨在解决大模型与外部数据源、工具之间的集成碎片化问题。在MCP出现之前,每个智能体项目往往需要为不同的外部系统(数据库、API、文件系统)单独编写适配代码,维护成本极高。MCP通过定义统一的Server/Client接口,让智能体可以用同一套调用方式访问不同的数据源——无论是本地文件、关系型数据库,还是已有的Java/Python业务服务,只需对应系统实现一个MCP Server即可。在本项目中,Java编写的ERP系统通过MCP Server暴露数据接口,FastAPI后端作为MCP Client发起调用,网关层负责鉴权和路由,这套链路是当前企业级智能体集成存量系统的主流模式之一。
安全与隔离:Sandbox沙箱机制
当智能体支持Skill(技能)时,无论是从网络下载的,还是由智能体自身生成的Skill,都可能存在安全隐患。同时,前端意味着多用户并发——张三和李四各自操作智能体、生成中间文件,这些文件和数据必须彼此隔离。
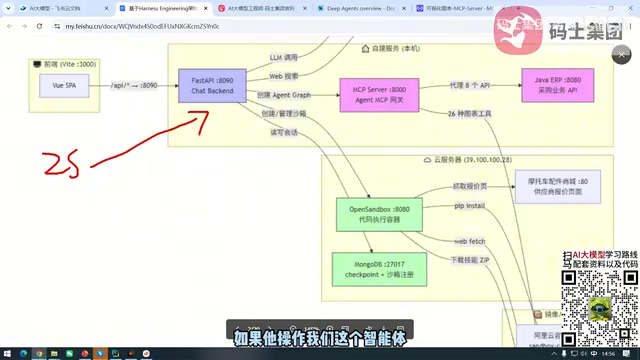
项目的解决方案是引入Sandbox沙箱。它本质上就是一个Docker容器,并不神秘。沙箱主要解决两个问题:
- Skill执行的安全问题:隔离不可信代码的运行环境
- 用户间的数据隔离:为每个用户分配独立沙箱,天然实现文件隔离
举例来说,张三拥有自己专属的沙箱,他在执行复杂任务(如生成分析报表、处理文件)过程中产生的所有中间文件都留在自己的沙箱内,李四无法访问。沙箱服务在本项目中通过OpenSandbox-Server启动,运行在独立的Linux服务器上。
由于不同用户的容器环境和功能可能有差异,项目还配套了一个镜像仓库,提前准备好多个不同的容器镜像,按需分配给不同用户。
Docker容器之所以适合充当沙箱,核心在于其namespace和cgroup机制:namespace实现文件系统、进程、网络的隔离,cgroup限制CPU和内存的最大占用,从而防止某个用户的恶意或失控代码耗尽宿主机资源。在智能体场景中,Skill(技能脚本)往往是动态生成或从外部下载的Python/Shell代码,直接在宿主机执行存在极高风险。将每次Skill执行限定在专属容器内,即便代码包含危险操作(如删除文件、建立外网连接),影响范围也被严格限制在该容器内。镜像仓库的配套设计则解决了"不同用户需要不同运行时环境"的问题,例如某用户的任务需要PyTorch环境而另一用户只需基础Python,预构建多个镜像并按需分配,比每次动态安装依赖效率更高也更安全。
这套架构对求职者的价值
把以上组件串起来看,这个项目完整呈现了一个企业级智能体应有的样貌:Harness架构负责任务编排、多模型保障推理能力、ASGI服务支撑生产部署、MCP协议打通存量系统、Sandbox沙箱解决安全与隔离、镜像仓库支持环境定制。
对于求职者而言,理解这样一套架构的意义在于——它正好覆盖了工程化落地方向面试官最关心的几个维度。相比只会调API的候选人,能够清晰讲出"智能体如何安全地在生产环境中处理复杂任务并对接企业系统"的人,显然更具竞争力。
本文仅梳理了项目的宏观框架,具体的功能实现与代码结构细节仍需进一步拆解。但即便只是把握整体设计思路,也足以让你在面试中对复杂智能体项目建立起系统性的认知。
相关推荐

智能体底座(Harness)比模型本身更关键:YC深度解析Agent架构演进
YC在Harness Night分享会上提出:决定智能体能力的关键不是模型本身,而是外层的Harness底座。本文梳理从GPT-2到自改进Harness的演进,解析Prime Agent、OpenJarvis、QM三大实践及Agent架构设计要点。

用n8n搭建LinkedIn线索抓取与丰富化自动工作流
一套基于n8n的LinkedIn线索抓取与丰富化自动工作流:只需填写职位、地点、行业和公司规模,系统即可自动生成含专业邮箱和验证状态的客户名单并写入Google表格。本文解析其流程、输出字段与合规注意事项。

SageMaker HyperPod:跨团队共享GPU集群的隔离与公平性实践
Amazon SageMaker HyperPod 推出跨团队共享GPU集群的参考架构,通过IAM Identity Center认证、Kubernetes命名空间隔离、Task Governance公平调度和成本分摊,实现算力安全共享与费用透明化。