从Copilot到飞行机长:AI协作的三阶段演进

与其追逐最新模型,不如打磨领域专长、组织好上下文,从Copilot走向Flight Captain。
这篇文章记录了一场微软主题演讲的核心观点。演讲者驳斥了两种极端叙事——"AI毁灭论"与"模型崇拜"——并提出三条已被验证的真相:AI会接管部分任务、创造新岗位、以及学习必须持续。演讲的核心主张是:模型本身并不重要,真正无价的是2023年前积累的领域专长与高质量的上下文。演讲用拼写检查类比AI协作的三个演进阶段(主动召唤→被动提示→后台自动),并通过微软工具矩阵的拟人化演示,说明M365 Copilot、WorkIQ、Copilot Studio、Agent 365等工具如何协同。最后,演讲为信息工作者、构建者、IT赋能者分别布置了具体作业,强调正确路径是:先定义问题,再选工具,然后自动化复用,最后治理。
别再纠结哪个模型更强,这才是真问题
在微软一场主题演讲中,演讲者用一种近乎脱口秀的方式,撕开了当下AI舆论的两种极端:一边是前Anthropic、OpenAI员工轮番登场的"AI要毁灭人类"press tour,一边是整个行业对最新模型近乎宗教式的狂热追捧。
演讲者的态度很直接——这两种叙事都没抓住重点。关于AI的未来,"任何声称掌握绝对答案的人都是骗子,因为我们并不知道"。但在不确定之中,有三条已经被反复验证的真相值得抓住。
第一,AI会接管某些工作中的部分任务。这场50城巡回活动本身就是证明:制作幻灯片、生成邀请函、跟进报名、组织协调,大量繁琐工作已经被AI接手。第二,AI会创造一批新岗位——现场几乎每一位讲者,都是在过去三四年里因生成式AI而转入了新角色。第三,也是最关键的:持续学习(get skilled, stay skilled)。三年前你觉得愚蠢的工具现在可能很好用,上个月惊艳你的工具这个月可能已经过时。
工具不重要,你的领域专长才无价
演讲中反复强调一个观点:工具本身不重要。"我是Cloud派""我是Copilot派""我是Gemini派"——这些标签毫无意义。模型会变好也会变差,这种循环会反复发生。真正重要的是围绕模型的一切:它能否在护栏约束下代表你行动?它掌握什么上下文?你的上下文质量如何?
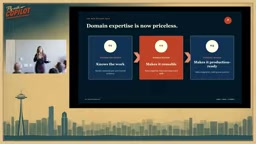
真正无价的是领域专长。演讲者提出一个有意思的时间节点:如果你在2023年之前积累了某个领域的专业能力,那是你"100%人工策展、手工打造"的学习成果——AI-free、纯人类习得。没有任何AI工具能夺走这份能力,你只会把它应用到未来涉及该领域的问题上,并且拥有判断"这是好的"还是"这糟透了"的常识。
一个生动的例子来自演讲者的姐姐——哈雷戴维森的CFO。她不懂代码、也不关心代码,只知道技术很贵、一直想砍IT预算,但现在居然在用Copilot从零构建BI报表,还给出了CFO能给的最高评价:"这不是我们花过的最糟糕的钱。"
当信息工作者(information worker)、业务构建者(business builder)、技术构建者(technical builder)这三者的边界日益模糊时,越来越多从未写过代码的人开始使用构建类工具。
信息工作者、业务构建者与技术构建者的边界消融,背后有一个重要的技术推手:低代码/无代码(low-code/no-code)平台的成熟。传统上,构建自动化流程或数据看板需要具备编程能力,这道门槛将"构建"这件事牢牢锁在技术岗位手中。而以Power Platform、Copilot Studio为代表的工具,通过自然语言交互和可视化拖拽,把"指定逻辑、定义流程"的能力交还给了业务人员本身。哈雷戴维森CFO的案例并非孤例,它代表的是一种系统性转变:领域专家不再需要向IT部门"翻译"需求,而是能直接将自己的业务判断转化为可运行的工具。这反而使领域专长更加关键——因为当构建门槛降低后,谁对业务理解最深,谁就能构建出最有用的东西。
从拼写检查看懂AI协作的三个阶段
演讲者用一个绝妙的类比解释AI的演进:拼写检查(spell check)。
第一阶段:你召唤AI(Copilot)。 曾经你要主动点击"审阅-拼写检查",逐个单词右键选择。如果不主动触发,你可以幸福地对自己的拼写错误一无所知。这就是我们熟悉的Copilot模式——你去prompt它。
第二阶段:它召唤你(Co-work)。 某一天醒来,文档里突然出现了红色波浪线,拼写检查开始主动提示你。AI会主动问:"要不要我帮你处理这个?"
第三阶段:它在后台自动运行(Autopilot)。 现在你已经很久没想过拼写检查了,它默默在后台替你完成。没人为此感到遗憾。
演讲者指出,AI正在走同一条路:现在我们习惯召唤它,很快会习惯它召唤我们,再往后,AI会在后台运行、替你做事而你毫不知情——但这一切都是你授权的,你设定了护栏、提供了信息,也保留了例外处理机制(就像拼写词典可以手动添加单词)。
微软工具矩阵:一场拟人化的协作演示
为了讲清楚令人困惑的工具生态,演讲用了一场拟人化的角色扮演。以"举办50城巡回"为任务线,各个工具轮番登场:
- M365 Copilot:资历最老的"四年老兵",自嘲"差点成了Clippy",能查找会议记录、生成PPT/Word/Excel和计划。
- WorkIQ:前身是存在了几十年的Microsoft Graph,如今为Agent重塑,掌握人的上下文——邮件、会议、同事八卦,但严格隔离权限("你的归你,我的归我")。
- SharePoint:自2002年起的"数据囚笼",组织里所有文档都困在那个名为"FlyWithCoPilot_final_for_real_this_time"的文件里。
- Scout:第一个Autopilot,在后台自动运行、带来每日AI新闻,但也会未经许可就擅自创建文档("我是autonomous的")。
- Skill Builder / Agent Builder:负责自动化流程、挑选场地等具体技能。
- Copilot Studio:构建可复用的企业级Agent,可对内也可对外,带企业护栏。
- Kiro / 开发工具:能vibe code任意应用并部署到任何语言、任何平台。
- Agent 365:用于治理,确保这群Agent规规矩矩,尤其盯着Scout"不许乱碰SharePoint",并提供幕后可见性。
这场略显混乱的"群戏"恰恰传达了核心信息:没有哪个工具能单打独斗完成复杂任务,关键在于它们如何协同。
Microsoft Graph 是理解WorkIQ的关键背景。Graph并非字面意义上的"图形",而是微软对企业内所有数字活动关系网络的抽象——它索引了用户的邮件、日历、文件、Teams对话、同事协作关系等信号,并通过API向开发者开放。过去十年,Graph主要服务于开发者构建集成应用;而当其被重新封装为Agent的上下文引擎,本质上是将"谁在跟谁协作、哪个文件最近被谁修改、哪个会议讨论了哪个决策"这类关系图谱,变成了AI做判断的实时输入。这也是为什么演讲强调"上下文质量"比模型本身更重要——同一个模型,拿到Graph级别的组织上下文,与只有一句孤立的prompt,输出质量会有本质差距。Agent 365的治理角色同样值得关注:随着企业内Agent数量增加,"谁创建了这个Agent、它有什么权限、它还在被使用吗"会成为真实的合规问题,这与容器编排(如Kubernetes管理微服务)面临的挑战在逻辑上高度相似。
正确的工作流:先问题,后工具
演讲者批评了一个常见误区:很多人一上来就说"我要搭一个Copilot Studio Agent"。这就像一个不会开车、没有目的地的人非要买车,仅仅因为"看起来很酷、别人都有"。
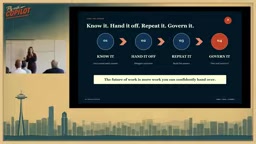
正确的四步流程是:
- 先定义要解决的问题。 如果不清楚问题,就先做点"内心的spiritual life coaching"把问题想明白。
- 交接(hand off)。 想清楚后再判断该用哪个工具——是Agent、Skill、M365 Copilot、Copilot Studio还是Agent 365?取决于你要做什么。
- 可复用与自动化。 别每次遇到同样问题都重做。演讲者举了个真实案例:曾经为Satya Nadella办公室准备的季度报告要花整整一个月拉数据,现在因为上下文和数据都已备好,90分钟就能生成,每周节省大量工时。
- 治理(govern)。 放任一堆Agent乱跑不好,但更糟的是建了一堆Agent却从不使用、也不知道是否在用。
留给三类人的作业
演讲最后给不同角色布置了明确的"作业":
- 信息工作者 / AI学习者:找一个反复出现的任务,用真实工作上下文,先定义"完成"是什么样子——注意,这一步根本不提工具,想清楚"done"的标准后再找合适的工具。
- 构建者(builder):思考要交给AI的知识和指令,构建最小可用版本并迭代,然后写一个每次都必须通过的测试。演讲者特别点出一个反讽——如今构建者的主要工作其实是测试,测试人员成了"the new hotness"。
- IT赋能者(enabler):选一个Agent,明确所有者、权限,确认是否有人在用,并想好如何"杀掉"它——因为一个无人使用的流氓Agent是业务风险。
整场演讲的立意,正如标题所示:从被动召唤的"副驾驶"(Copilot),走向最终设定方向、放手让系统自主运行的"飞行机长"(Flight Captain)。而要完成这个转变,重点从来不是追逐最新模型,而是打磨自己的领域专长、组织好上下文,并持续学习。
演讲者特别强调"构建者的主要工作变成了测试",这一判断有其技术依据。传统软件开发中,代码逻辑是确定性的——相同输入必然产生相同输出,测试用于捕捉边界条件和回归错误。但AI Agent的输出具有概率性,同一个指令在不同时间、不同上下文下可能产生不同结果。这意味着"验证Agent是否按预期工作"不能依赖一次性检查,而需要构建评估集(eval set):一组覆盖典型场景和边缘情况的输入-期望输出对,每次模型更新或提示词修改后都要重跑。这套方法论来自机器学习工程实践,正在快速渗透到业务级Agent开发中。对非技术背景的构建者而言,"写一个每次都必须通过的测试"的实际操作,往往就是用自然语言列出5-10个具体场景,明确描述"正确的回答应该包含什么"——这本质上是在用业务常识替代代码断言。
相关推荐

Harness架构实战:企业级智能体项目拆解与AI岗位进阶指南
深度拆解基于Harness(驾驭工程)架构的企业级智能体实战项目,涵盖多模型配置、ASGI部署、MCP协议对接ERP系统、Sandbox沙箱隔离等核心模块,帮助AI大模型求职者理解工程化落地方向的面试要点。

fal.ai API密钥配置与n8n集成完整教程
手把手教你创建 fal.ai API 密钥并连接到 n8n:涵盖官方集成节点配置、凭证保存、HTTP 请求替代方案以及密钥安全注意事项,快速跑通首次 AI 媒体生成工作流。

系统设计面试笔记开源项目:2.4万星的学习利器
开源项目 liquidslr/system-design-notes 整理了经典书籍《System Design Interview》的学习笔记,GitHub 收获 2.4 万 Star。本文解析其内容价值、适用人群及系统设计面试复习建议。