从零构建Agent智能体:ReAct范式与架构蓝图解析
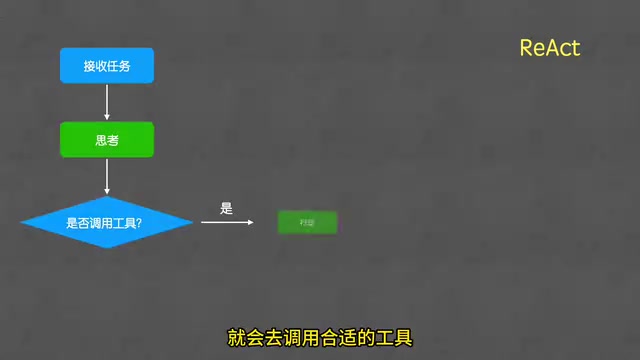
拆解Agent运行原理:以ReAct循环为内核,配合Provider适配器、上下文与工具系统构建完整架构。
本文系统讲解了Agent的运行范式与工程架构。核心范式ReAct(Reasoning and Acting)将执行过程拆解为「思考—行动—观察」三步闭环循环,当大模型判断现有信息已足够完成任务时停止调用工具并输出结果。为应对多模型切换的现实需求,架构引入Provider适配器作为解耦层,使核心逻辑独立于具体模型API。在此基础上,完整的Agent系统还需补齐上下文系统(记忆)和工具系统,并通过微信、钉钉等用户入口实现真正落地。整套架构层次清晰,为后续编码实践提供了可执行的蓝图。
在上一节明确了「Agent是什么」之后,真正的问题浮出水面:一个智能体究竟是如何运转的?这一节要拆解的是Agent的运行范式,以及一个完整Agent系统应该由哪些模块拼装而成。理解了这套架构蓝图,后续写代码时才不会迷失在细节里。
Agent的主流范式:为什么ReAct是黄金标准
Agent的运行范式并不止一种,目前比较流行的有三类:ReAct模式、Plan and Execute(先规划后执行)模式,以及Multi-Agent(多智能体协作)模式。三者各有适用场景,但使用最广泛、最值得优先掌握的,是ReAct模式。
ReAct的全称是 Reasoning and Acting,直译就是「推理然后行动」。它来自一篇发表于2022年10月的论文,尽管已经过去数年,它至今仍是Agent领域公认的黄金标准。市面上绝大多数Agent产品,底层跑的都是ReAct这套逻辑。换句话说,想真正入门Agent开发,绕不开对ReAct的理解。
另外两种范式也值得简要了解。Plan and Execute 模式将任务拆分为两个阶段:先由规划器(Planner)一次性生成完整的执行计划,再由执行器(Executor)逐步落实。这种模式适合任务结构清晰、步骤可预判的场景,但对计划的质量依赖较高,若前期规划出错则容易「将错就错」。Multi-Agent 模式则是让多个专职Agent协同工作,每个Agent负责特定子任务,适合复杂的流程自动化场景,但调度与通信开销也随之增大。ReAct之所以成为黄金标准,在于它把规划与执行交织在一起——每一步都能根据最新观察结果动态调整,容错性更强,也更符合现实中任务信息不完整的常态。
ReAct循环:思考、行动、观察的闭环
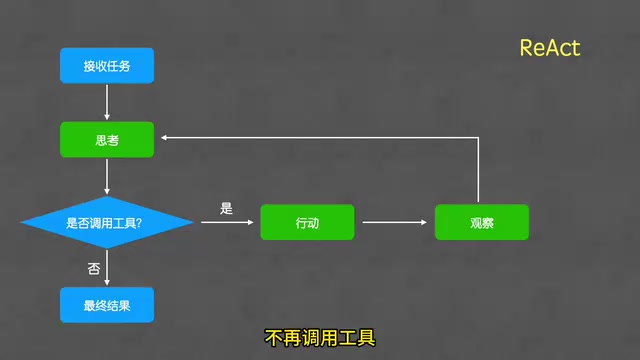
ReAct的运行过程可以拆成一个不断循环的三步走。
第一步是思考(Reasoning)。Agent接到任务后,先开始推理,判断当前该做什么,是否需要借助外部工具。
第二步是行动(Acting)。如果思考的结论是「需要工具」,Agent就会去调用合适的工具,比如读取文件、修改文件等操作。
第三步是观察(Observation)。工具执行完毕后,Agent会查看结果——文件读到了什么内容、修改是否成功等等。
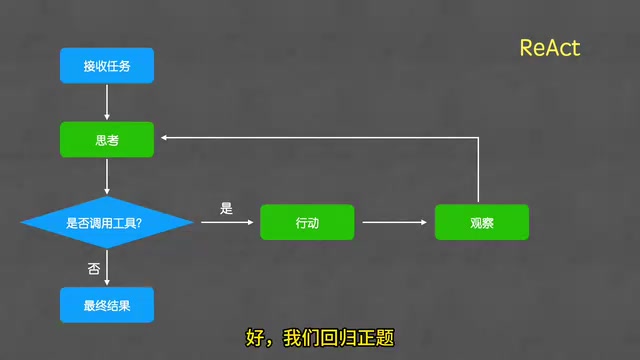
观察之后,Agent回到思考环节,再次判断是否还需要调用工具。如果需要,就重复「思考—行动—观察」的流程;如果不需要,就输出最终结果。这个不断循环的过程,就是大名鼎鼎的 ReAct Loop。
这里其实有个值得点破的地方:Loop这个词听起来很高端,本质上就是一个循环。AI领域充斥着大量听着唬人、实则简单的新名词,剥开外壳,核心概念往往朴素得多。
关键判断:Agent何时停止调用工具
整个ReAct循环里,最关键的一步是最后那个判断——Agent认为不需要再调用工具,于是输出最终结果。这背后的逻辑值得深究。
回顾上一节的核心结论:大模型本身无法感知和改变外界环境。而有了工具之后,大模型就获得了感知与改变环境的能力。所以当Agent判断「不再需要工具」时,本质上是在说:现有的信息已经足够完成任务了。
那如果此时输出的结果并不理想,问题出在哪?既然信息已经足够,那只能是大模型自身能力不足。这就好比有些同学做数学题「一看就会,一做就错」——题目条件齐全,卡壳的是解题能力本身。解决办法也直接:换一个能力更强的模型。
这里隐含着一个潜在风险:无限循环。如果模型能力不足或任务目标表述不清,Agent可能陷入反复调用工具却始终无法满足停止条件的死循环。工程实践中通常会设置最大迭代次数(Max Iterations)作为安全阀,超过阈值后强制终止并返回当前最优结果。此外,停止判断本身也依赖大模型的推理能力——模型需要正确评估「现有信息是否已经足够」,这对模型的指令遵循(Instruction Following)能力提出了较高要求,这也是为什么底层模型的选择会直接影响Agent的整体表现。
从核心引擎到完整架构
换模型这个动作,直接牵出了架构设计上的一个现实问题。
Provider适配器:解耦模型与核心逻辑
市面上模型众多,国产的有DeepSeek广告,国外的有OpenAI、Anthropic,每家的API都不一样。如果把某个模型的API直接硬编码进Agent核心代码,那每次换模型都得改代码,成本极高。
解决方案是引入一个中间层——Provider适配器。所有大模型都对接这个适配器,Agent的核心逻辑只与适配器交互。这样一来,切换模型时只需调整适配器,核心代码保持不变。这是典型的解耦设计思路。
至此,Agent的核心引擎(Engine)就成型了:ReAct循环 + Provider适配器。结构直观且清晰。
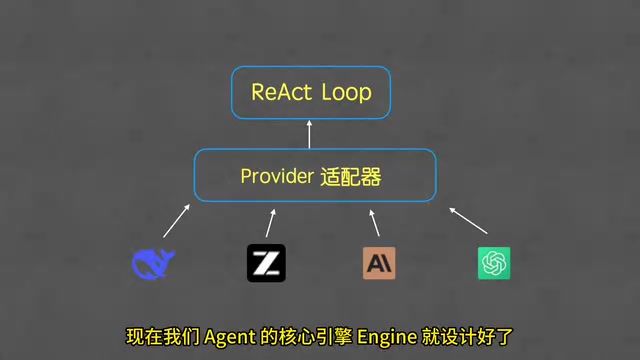
Provider适配器本质上是软件设计中**适配器模式(Adapter Pattern)**的直接应用:定义一套统一的接口规范,让不同来源的模型API都实现这套接口,核心逻辑只面向接口编程而非具体实现。实际开发中,OpenAI已成为事实上的接口标准,DeepSeek、国内多家厂商的API均提供了OpenAI兼容模式,这在一定程度上降低了适配层的工作量。但各模型在上下文窗口大小、函数调用(Function Calling)格式、流式输出行为等细节上仍存在差异,适配器还需处理这些边界情况,避免因模型切换引发静默错误。
补齐记忆与工具
有了核心引擎还不够。回到上一节的公式:Agent = 大模型 + 记忆 + 工具。核心引擎解决了大模型的调用问题,接下来要补上记忆和工具两块。
记忆本质上就是上下文,需要一套上下文系统来维护对话与任务状态;工具则需要一套工具系统来统一管理各种可调用的能力。加上这两部分,Agent的主体框架就基本齐全了。
用户入口:让Agent真正可用
最后还差一环——用户入口。总不能要求每个用户都去跑代码才能使用Agent。因此需要接入微信、钉钉、飞书这类日常沟通工具,用户直接发消息就能指挥Agent干活。
到这里,Agent的整体架构就完整了:核心引擎(ReAct循环 + Provider适配器)+ 上下文系统 + 工具系统 + 用户入口。整套设计逻辑清晰、层层递进,为后续动手写代码打下了蓝图基础。
小结
这一节的价值在于把抽象的Agent概念,还原成了一张可落地的工程蓝图。ReAct的三步循环是运行内核,Provider适配器保证了灵活性,记忆与工具补齐了能力短板,用户入口则让整套系统真正触达用户。理解了这套结构,下一步的编码环节就有了清晰的方向。
相关推荐
AI游戏做得烂,问题不在AI而在你
一篇Reddit热帖指出:借助AI生成的游戏之所以质量差,问题不在AI而在开发者。AI能写代码却判断不了游戏是否好玩,测试与迭代打磨依然是人的责任。本文解析AI时代创作者面临的真正分水岭。
入门聊天机器人开发:RAG技术栈需要哪些编程语言
想用 RAG 技术开发聊天机器人却不知从何学起?本文梳理 Python、JavaScript 等编程语言的选择逻辑,解析 RAG 技术栈核心流程,并给出新手学习资源与实践建议。
百万级上下文窗口的工程挑战:VRAM碎片与动态KV缓存
百万级上下文窗口对大模型推理提出严峻的显存挑战。本文解析VRAM碎片化与动态KV缓存两大工程难题,探讨分页式缓存、显存池、分层卸载等架构应对策略。