入门聊天机器人开发:RAG技术栈需要哪些编程语言
面向新手的RAG聊天机器人开发语言选择指南,推荐以Python为起点快速上手。
本文针对想用RAG技术构建聊天机器人的新手,给出了语言选型与学习路径的实用建议。Python因其完整的大模型生态(LangChain、LlamaIndex、各大模型SDK)成为几乎唯一的起点;当需要做成可交互的Web产品时,才有必要引入JavaScript/TypeScript。文章还拆解了RAG的三个核心环节——文档切分、向量化存储、检索生成,强调理解工作流程比死磕语言语法更重要。学习策略上,建议以官方文档和动手小项目驱动,行动优先于完美选型。
聊天机器人开发的语言选择
一位 Reddit 用户在社区提出了一个新手常见的困惑:想用 RAG(检索增强生成)技术构建聊天机器人,应该学习哪些编程语言?又该从哪些课程和书籍入手?
这个问题看似简单,但背后涉及现代 AI 应用开发的整个技术选型逻辑。原帖信息有限,本文结合聊天机器人与 RAG 开发的通用实践,给出一个可落地的学习路径参考。
为什么 Python 几乎是唯一起点
对于想做 RAG 聊天机器人的新手,Python 是最优先的选择,原因很直接:整个大模型与向量检索的生态几乎都以 Python 为核心。
主流的 RAG 框架如 LangChain、LlamaIndex,向量数据库客户端如 Chroma、Pinecone、Weaviate,以及 OpenAI、Anthropic 等模型提供商的官方 SDK,都优先提供 Python 接口。这意味着你能找到最完整的文档、最多的示例代码和最活跃的社区支持。
如果目标是快速搭建原型、验证一个聊天机器人的想法,Python 能让你把精力集中在业务逻辑而非底层实现上。
RAG(Retrieval-Augmented Generation,检索增强生成)是一种将外部知识库与大语言模型结合的技术范式。传统大模型的知识被固化在训练参数中,无法感知训练截止日期之后的信息,也难以回答基于私有文档的问题。RAG 的解决思路是:在生成回答之前,先从外部数据库检索出与问题最相关的内容,再将这些内容作为上下文(Context)一并输入模型,让模型「看着资料回答问题」,而非凭记忆作答。这一机制既降低了模型幻觉的风险,也使聊天机器人能够基于实时更新的私有知识库运作,是目前企业落地大模型应用最主流的技术路径之一。
什么时候需要 JavaScript/TypeScript
当聊天机器人需要嵌入网页、做成前端可交互的产品时,JavaScript 或 TypeScript 就成了绕不开的一环。
LangChain 官方也提供了 JS 版本,配合 Next.js、React 等框架,可以直接把 RAG 能力接入 Web 应用。对于希望做全栈产品的开发者,Python 负责数据处理与模型调用的后端、TypeScript 负责前端交互,是一种常见的组合。
简单来说:只想跑通逻辑和实验,用 Python 足够;要做成给用户使用的产品,就需要补上前端语言。
RAG 技术栈的核心组成
除了编程语言,理解 RAG 的工作流程比死磕语法更重要。一个基础的 RAG 聊天机器人通常包含以下环节:
文档处理与切分
把原始文档(PDF、网页、数据库)切分成合适大小的文本块,这一步直接影响检索质量。
向量化与存储
用嵌入模型(Embedding Model)把文本转换成向量,存入向量数据库。常见选择包括 Chroma(本地轻量)、Pinecone、Weaviate 等。
嵌入模型(Embedding Model)是将文本转化为高维向量的神经网络模型,其核心思想是让语义相近的文本在向量空间中距离更近。常见的嵌入模型包括 OpenAI 的 text-embedding-ada-002、开源的 sentence-transformers 系列,以及 Cohere 的 Embed 模型。向量数据库则专为高效相似度检索而设计,支持近似最近邻(ANN)算法,能在数百万条向量中毫秒级找到最相关的片段。Chroma 适合本地开发和原型验证,无需注册账号即可使用;Pinecone 和 Weaviate 则提供云端托管服务,适合生产环境部署。选择哪款向量数据库对新手来说影响不大,核心是先理解「文本→向量→存储→检索」这条链路的运作方式。
检索与生成
用户提问时,先从向量库检索最相关的文本片段,再连同问题一起交给大模型生成回答。这就是「检索增强」的核心。
掌握这套流程后,语言只是实现工具,换一门语言并不会推翻你对 RAG 的理解。
学习资源的建议方向
原帖还询问了课程和书籍推荐。对于新手,建议按这样的顺序推进:
- 打好 Python 基础:不需要精通,能读懂函数、循环、API 调用即可。
- 官方文档优先:LangChain 和 LlamaIndex 的官方教程通常是最新、最准确的入门材料,很多都带 RAG 的完整示例。
- 动手做小项目:与其看完整本书,不如先跑通一个「基于自己文档的问答机器人」,遇到问题再针对性查资料。
- 补充理论:想深入理解嵌入、向量检索、大模型原理时,再去看系统性的书籍或课程。
给新手的实用建议
RAG 开发领域迭代很快,框架和工具几个月就可能大更新。因此,与其纠结「学哪门语言最好」,不如先用 Python 快速上手,把一个最小可用的聊天机器人跑起来。
实践中积累的问题会自然引导你去学习该补的知识——无论是前端语言、向量数据库调优,还是提示词工程。对入门者而言,行动比完美的技术选型更重要。
相关推荐
自建AI监控Agent:自动追踪KLSE持仓股新闻
一位马来西亚散户自建AI监控Agent,每30分钟轮询KLSE新闻与Bursa公告,仅在持仓股被点名时通过微信/Telegram/飞书推送。本文解析这个精准静默的个股信息工具及其产品思路。
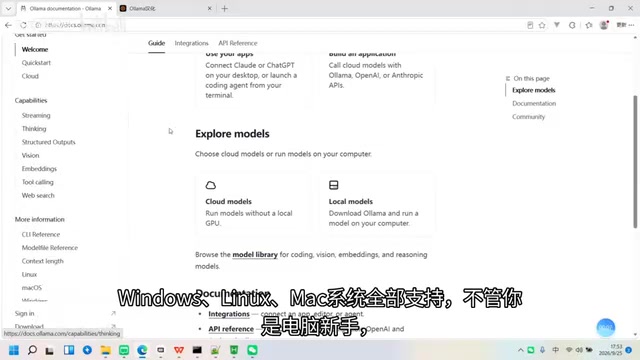
Ollama本地大模型部署入门:中文手册助你少走弯路
不会安装 Ollama 本地大模型?本文介绍一份覆盖安装部署、模型下载、Modelfile 定制、OpenAI 兼容接口和 GGUF 量化的中文手册,帮新手和开发者快速上手本地大模型,少走弯路。
AI破解图灵未竟难题:Astra与Opus的密码学突破
前沿AI模型Astra与Opus据报正在完成图灵二战时期未竟的密码破译工作,这项'图灵的另一项测试'标志着AI从对话模仿走向硬核逻辑推理,也反映出AI能力评估范式的深刻转变。