从零手写Transformer:5.3万参数造恐龙名字生成器
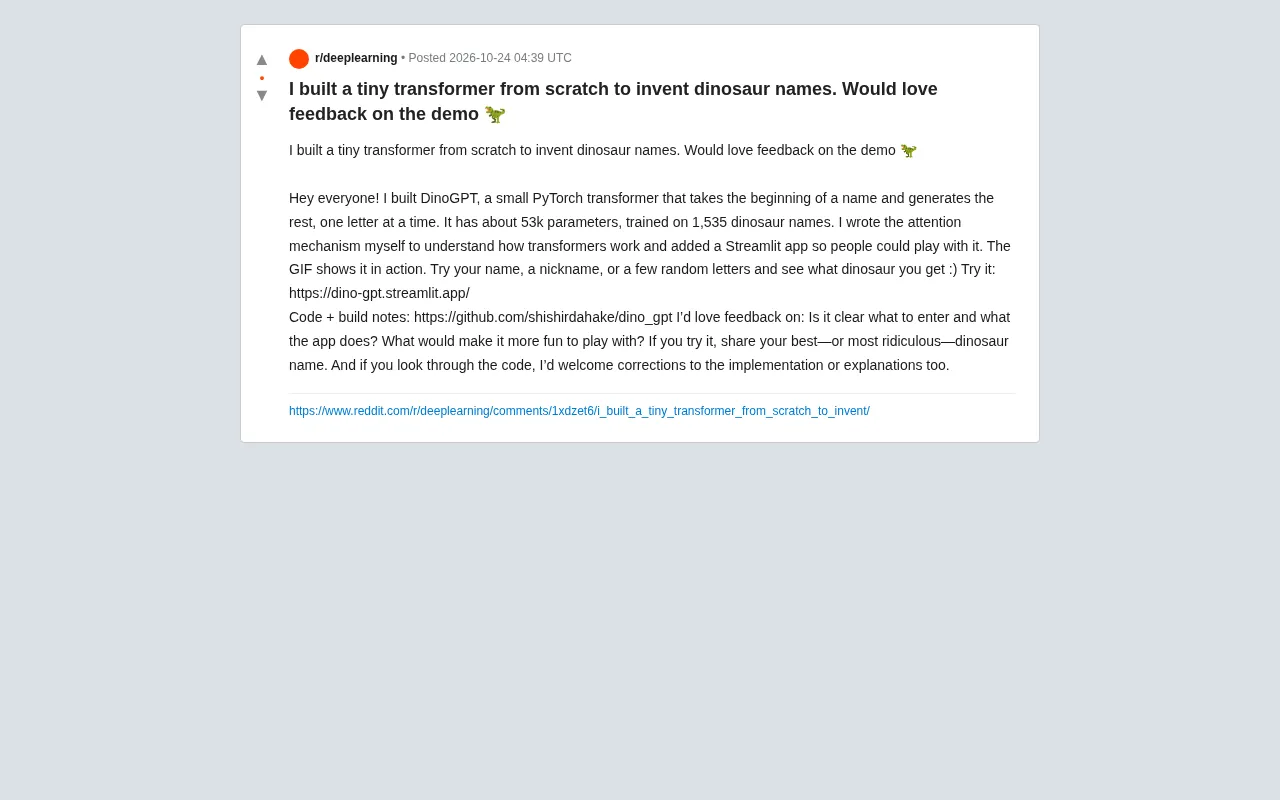
开发者用 PyTorch 手写 5.3 万参数 Transformer,生成恐龙名字并做成可玩 demo。
DinoGPT 是一位开发者从零实现的字符级 Transformer,仅有约 5.3 万个参数,训练数据是 1,535 个真实恐龙名称。用户输入名字开头,模型便逐字母预测,拼出新的恐龙名。项目用 Streamlit 封装成网页应用,几乎无需前端代码即可分享体验。作者坦言目标不是生成质量,而是通过最小可行项目理解 Transformer 的内部机制:注意力层一行行手写,各组件维度小到可以追踪每个权重的变化。文章认为,这种“小任务+最小模型+可分享 demo”的路径覆盖数据处理、模型实现、训练调参与产品化部署,是一条低成本且高效的 AI 学习路线,比单纯读论文更能建立直觉。
一位开发者用 PyTorch 从零实现了一个微型 Transformer,取名 DinoGPT,专门用来生成恐龙名字。项目只有约 5.3 万个参数,训练数据是 1,535 个真实恐龙名称,还配了一个 Streamlit 网页应用,让任何人都能输入开头几个字母,看看能“孵化”出什么恐龙。
项目是什么:一个字符级名字生成器
DinoGPT 的玩法很直接:你给它一个名字的开头——比如自己的名字、昵称,或者随便几个字母——它就会逐字母预测后续内容,拼出一个完整的恐龙名。模型规模小到可以在浏览器里轻松跑起来,但麻雀虽小五脏俱全,注意力机制是作者一行行手写出来的。
作者在帖子里说得很坦诚:造这个项目的核心目的不是追求生成质量,而是想搞懂 Transformer 到底怎么工作。这种“用最小可行项目反向学习”的思路,对很多想入门 AI 的开发者来说,比读十篇论文都管用。
字符级建模(Character-level Modeling) 指的是模型以单个字符而非单词作为最小输入单元。在 DinoGPT 中,词表就是 26 个英文字母加上少量标点符号,因此嵌入矩阵和输出层的维度都极小。这与 GPT 系列常用的 BPE(字节对编码)子词分词不同:子词分词能压缩序列长度、捕捉常见词片段,但需要额外训练分词器;字符级方案则完全免去分词步骤,序列变长但每一步的粒度更细,非常适合观察模型如何从零学会拼写规律。它的代价是序列更长、长程依赖更难学,不过在恐龙名字这种短文本任务上几乎不构成问题。
为什么 53k 参数值得关注
大模型动辄千亿参数的时代,5.3 万参数看起来像个玩具。但这恰恰是这个项目最有价值的地方:它把 Transformer 的完整训练和推理链路压缩到了一个可以完整读完的代码库里。
字符级建模意味着词表极小(26 个字母加少量符号),嵌入层、位置编码、多头注意力、前馈网络这些组件一个不少,但每一层的维度都小到可以用纸笔推演。对于想理解“注意力到底在注意什么”的人来说,这种规模反而是优势——你能真正追踪到每个权重的变化。
训练数据只有 1,535 个恐龙名字,这个量级也很有意思。数据少意味着过拟合风险高,但作者的目标是演示而非生产,所以模型学到的是恐龙名字的拼写“风格”——常见的拉丁化词根、双元音组合、结尾的 -saurus 或 -raptor 模式,而不是真实的古生物分类学知识。
位置编码(Positional Encoding) 是 Transformer 中用来注入顺序信息的关键组件。自注意力本身是排列不变的——把输入顺序打乱,注意力输出只是跟着重排,模型无法知道哪个字母在前。常见的做法有两种:一是正弦/余弦形式的固定位置编码,不参与训练;二是可学习的位置嵌入,作为参数随模型一起优化。DinoGPT 这类微型模型通常采用可学习位置嵌入,参数量等于最大序列长度乘以隐藏维度。理解位置编码有助于看清一个事实:Transformer 的“顺序感”不是天然具备的,而是显式加上去的,这也是它与 RNN 在结构上最根本的差异之一。
从代码到可玩:Streamlit 降低了体验门槛
作者把模型封装成了 Streamlit 应用,这是整个项目从“个人实验”变成“可分享作品”的关键一步。Streamlit 的好处是几乎不用写前端代码,几十行 Python 就能搭出一个有输入框和输出结果的交互页面。
从演示截图看,界面围绕“输入开头、生成名字”这一条主线设计,没有多余的按钮和配置项。作者自己在帖子里问的第一个问题就是“是否清楚该输入什么、应用是做什么的”,说明他在意的是首次使用者的理解成本,而不是炫技。这种产品意识在个人项目里并不多见。
Streamlit 是一个面向数据科学与机器学习的 Python 框架,开发者只需写普通脚本,用 st.text_input、st.button 等函数声明界面元素,框架会自动处理前端渲染与状态刷新。它的运行模型是“脚本自上而下重跑”:每次用户交互都会重新执行整个脚本,因此模型加载通常需要用 @st.cache_resource 缓存,避免每次点击都重新初始化权重。对 DinoGPT 这类推理极快的微型模型,这种模式几乎没有性能负担;而它最大的价值在于把“模型 → 可分享网页”的距离压缩到几十行代码,让个人实验能迅速变成他人可体验的作品。
作者想要什么样的反馈
帖子里列出的问题很具体:交互是否清晰、怎样让它更好玩、有没有生成出最离谱的恐龙名,以及代码实现或解释上的错误欢迎指正。最后一条尤其值得注意——他把项目当作学习笔记公开,主动邀请懂行的人来挑错,这比单纯晒成果的帖子更有讨论价值。
对想复现类似项目的人来说,GitHub 上的构建笔记可能比代码本身更有参考意义。从零手写注意力层时踩过的坑、维度对不上的调试过程、字符级 tokenizer 的设计取舍,这些细节往往是教程里看不到的。
小项目的大启示
DinoGPT 这类项目的意义不在于生成多逼真的恐龙名,而在于它展示了一条低成本的 AI 学习路径:选一个有趣的小任务,用最小的模型规模把完整流程跑通,再把成果做成别人能上手玩的东西。整个过程覆盖了数据处理、模型实现、训练调参和产品化部署,每个环节都能独立深入。
如果你也想搞懂 Transformer,与其从推导公式开始,不如先定一个类似“生成某种名字”的小目标,把模型跑起来再说。53k 参数足够让你看清每一层的输入输出,而一个能分享出去的 demo,会让学习过程多一层外部反馈的驱动力。
相关推荐
Dioxus 全栈生产环境一年实践:收获与痛点
一位开发者分享 Dioxus 全栈框架在生产环境运行一年的真实体验,涵盖全栈 Rust 的类型安全收益、编译时间与生态成熟度等痛点,为技术选型提供参考。
AGI领袖的隐秘信仰:人类没有特殊之处?
Vergecast播客揭示AGI领袖圈内的隐秘信念:人类没有特殊之处,意识只是计算。探讨计算功能主义如何影响技术精英的世界观与AI未来。
通用汽车转向混动:从纯电押注到务实并行的战略调整
通用汽车此前跳过混动直接押注纯电,如今计划为SUV产品线推出混合动力版本,本文解析这一战略调整的原因、对SUV品类的意义以及对消费者的实际影响。