从LLM API转向自托管:这笔账到底划不划算?

一位工程师发帖追问自托管LLM的真实成本,揭示GPU之外被低估的闲置与人力隐性支出。
这篇文章围绕一个Reddit帖子展开,一位基础设施工程师公开追问:API账单涨到多少才值得自托管大语言模型?文章系统梳理了这一决策的核心维度:自托管的真实成本远不止GPU租金,还包括GPU闲置成本、工程师人力以及7x24运维责任;冷启动延迟、自动扩缩容复杂性、显存溢出和凌晨报警是运维最高频的痛点;部分团队自托管后又回迁API,主要原因是运维负担超出预期且开源模型难以跟上API厂商持续的模型迭代节奏。文章最终提炼出一个实用决策框架:只有调用量大、流量稳定、团队具备MLOps能力、能接受开源模型质量,且全成本TCO低于API费用时,自托管才真正划算。
一个基础设施工程师的灵魂拷问
在Reddit上,一位自称基础设施工程师的开发者抛出了一个让无数团队纠结的问题:到底什么时候自托管大语言模型(LLM)才真正划算,而不是继续为API付费? 他吐槽说,几乎每篇博客文章给出的答案都是那句万能的「it depends(看情况)」,这显然无法指导实际决策。
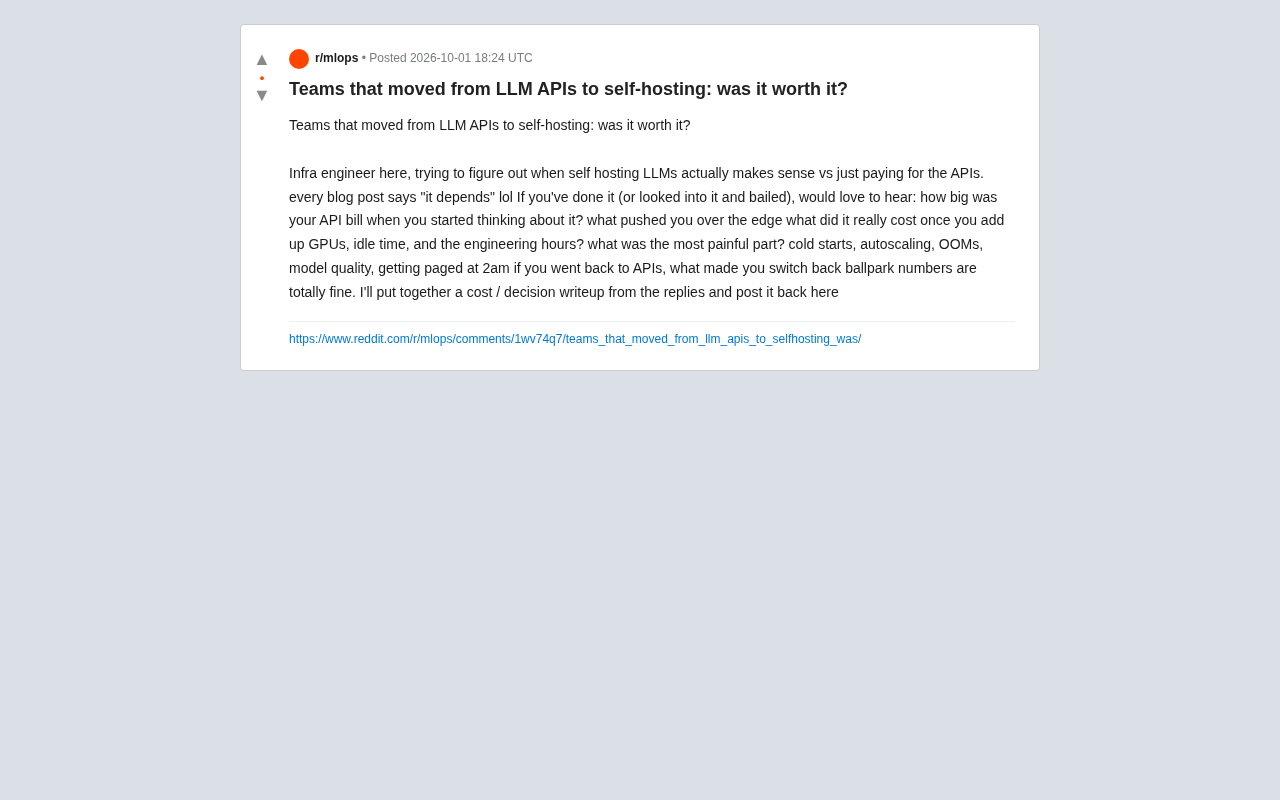
这个问题之所以引发关注,是因为它触及了当下AI工程实践中最现实的成本权衡。随着OpenAI、Anthropic等厂商的API调用费用持续累积,越来越多的团队开始评估:自建GPU集群、维护推理服务,究竟是省钱还是在制造新的麻烦?
决策的触发点:API账单到了多少钱?
发帖者提出的第一个核心问题很直接——当初是API账单涨到多少,才开始考虑自托管? 这其实是整个决策链条的起点。
对大多数团队而言,API成本在早期几乎可以忽略不计。真正的转折点往往出现在使用量规模化之后:当月度账单从几百美元跳到数万美元时,自托管的固定成本模型才开始显得有吸引力。按token计费的模式在高并发、高频调用场景下会快速放大,而自托管的边际成本在GPU买断或长期租用后趋于稳定。
但这里有个容易被忽视的陷阱:API账单是显性的,而自托管的成本是隐性且分散的。 单纯对比「每月API费用」和「GPU月租」是一种危险的简化。
真实成本远不止GPU租金
原帖特别强调了一个关键点:算总账时,不能只看GPU的价格,还要加上闲置时间(idle time)和工程师的人力工时(engineering hours)。
这恰恰是自托管最容易被低估的部分:
- GPU利用率问题:如果流量存在明显的峰谷波动,你为峰值采购的GPU在低谷期大量闲置,但费用照付。这种闲置成本往往吞噬掉理论上的节省。
- 工程人力成本:搭建和维护推理服务、监控、调优所消耗的工程师时间,折算成薪资后是一笔巨大开销。对小团队而言,这可能比API账单本身还贵。
- 机会成本:投入到基础设施维护的工程资源,本可以用于产品核心功能开发。
换句话说,自托管把「可变的现金支出」转换成了「固定的资产+人力投入」,这笔转换是否划算,高度依赖具体的使用模式。
最痛的那些坑:冷启动、自动扩缩容与凌晨两点的报警
发帖者直接点名了自托管运维中最折磨人的几个环节,每一个都是实战中踩过坑的人才会第一时间想到的:
冷启动(Cold Starts)
大模型加载到显存需要时间,第一个请求可能要等待数十秒。对于需要即时响应的应用,这是致命的体验问题,而保持模型常驻又回到了闲置成本的老问题。
自动扩缩容(Autoscaling)
GPU实例的扩缩容远比普通Web服务复杂。模型加载慢、GPU资源稀缺且昂贵,使得弹性伸缩很难做到既及时又经济。
显存溢出(OOMs)与模型质量
上下文过长、并发过高都可能触发OOM(Out of Memory)。同时,自托管的开源模型在质量上是否能匹配旗舰API模型,也是需要反复验证的变量。
凌晨两点被报警叫醒
发帖者半开玩笑地提到「getting paged at 2am」——这正是自托管最隐蔽的成本:7x24的运维责任。API服务的可用性由厂商保障,而自托管意味着你的团队成了自己的SRE。
OOM(Out of Memory,显存溢出)是大模型推理服务特有的稳定性威胁,与普通服务的内存问题有本质区别。GPU显存是物理隔离的固定资源,无法像CPU内存那样借助虚拟内存或Swap临时扩展。一张80GB的A100装载一个70B参数的模型后,留给KV Cache(存储推理中间状态的缓冲区)的空间极为有限。当并发请求增多、上下文窗口拉长时,KV Cache会迅速耗尽显存,触发OOM并导致整个推理进程崩溃,而非优雅降级。这意味着自托管团队需要精细管理并发上限、最大上下文长度,并为不同场景做显存容量规划——这本身就是一项需要专业知识的运维工作,无法靠简单配置解决。
回流API:为什么有人又切回去了?
帖子还专门询问了那些尝试自托管后又切回API的团队,是什么让他们做出了回退决定。
这个问题的价值在于揭示了一个常被营销话术掩盖的现实:自托管不是单向的技术升级,而是一个可逆的权衡。回流的常见原因通常包括——运维负担超出团队承受能力、实际成本节省不及预期、模型质量或迭代速度跟不上API厂商的更新节奏。
API厂商持续发布更强、更便宜的模型,这种「免费升级」是自托管难以企及的优势。当你的自建模型还停留在某个版本时,API侧可能已经迭代了好几代。
给正在纠结的团队的决策框架
综合这场讨论的问题脉络,可以提炼出一个更实用的判断思路,而不是那句无用的「看情况」:
- 看规模与稳定性:只有当调用量大、流量模式稳定可预测、GPU利用率能维持在高位时,自托管的成本优势才成立。
- 看团队能力:是否有专职的基础设施/MLOps人力承接运维?没有的话,人力成本会悄悄抹平账面节省。
- 看质量容忍度:你的场景能否接受开源模型的质量,以及无法实时跟进前沿模型迭代的代价。
- 算全成本(TCO):GPU费用 + 闲置成本 + 工程人力 + 运维风险,对比API账单,才是公平的比较。
这场由一位工程师发起的众包式调研,本质上是在用一线实战经验对抗空泛的理论建议。对于任何正在评估这条路的团队来说,它提供的问题清单本身就是最有价值的决策起点。
TCO(Total Cost of Ownership,总拥有成本)是评估自托管与API方案的核心财务框架,但实际计算中容易遗漏几类隐性成本:其一是网络与存储成本,大模型权重文件动辄数十至数百GB,每次节点重启或扩容时的模型下载、分布式存储费用不可忽视;其二是合规与安全投入,自托管意味着团队需要自行承担数据安全审计、访问控制和漏洞修复的责任,这在金融、医疗等受监管行业尤为突出;其三是试验迭代成本,API模式下切换模型几乎零成本,而自托管环境下每次模型升级都需要重新进行性能测试、显存评估和压力测试。将这些成本纳入TCO计算后,通常会显著抬高自托管方案的盈亏平衡点。
相关推荐

层级感知RAG分块工具包:为法律文档打造的私有化处理方案
一套面向RAG流水线的层级感知分块工具包,含法律交叉引用与法案提取脚本,支持私有化部署与源码交付,专为法律文档等结构化场景优化检索质量,兼容LangChain生态。
Cursor入门指南:AI编程工具全景解析与主流对比
Cursor入门教程第一讲:解析AI编程核心逻辑,横向对比Cursor、GitHub Copilot、Windsurf、Trae、通义灵码等主流AI编程工具的优劣势与适用场景,助你快速选型。
Cursor的Agent团队实践:如何突破40%生产力瓶颈
Cursor团队分享Agent团队实战经验:为何AI编程效率停滞在40%?答案在于AI只替代了软件开发生命周期的一小部分。本文解析PM Agent、安全Bot、代码审查与增长自动化如何重构研发全流程。