从MMLU到FrontierCode:AI评测基准为何越来越难

AI基准测试从MMLU选择题演进到FrontierCode级别的复杂工程任务,折射出大模型能力的代际跃升。
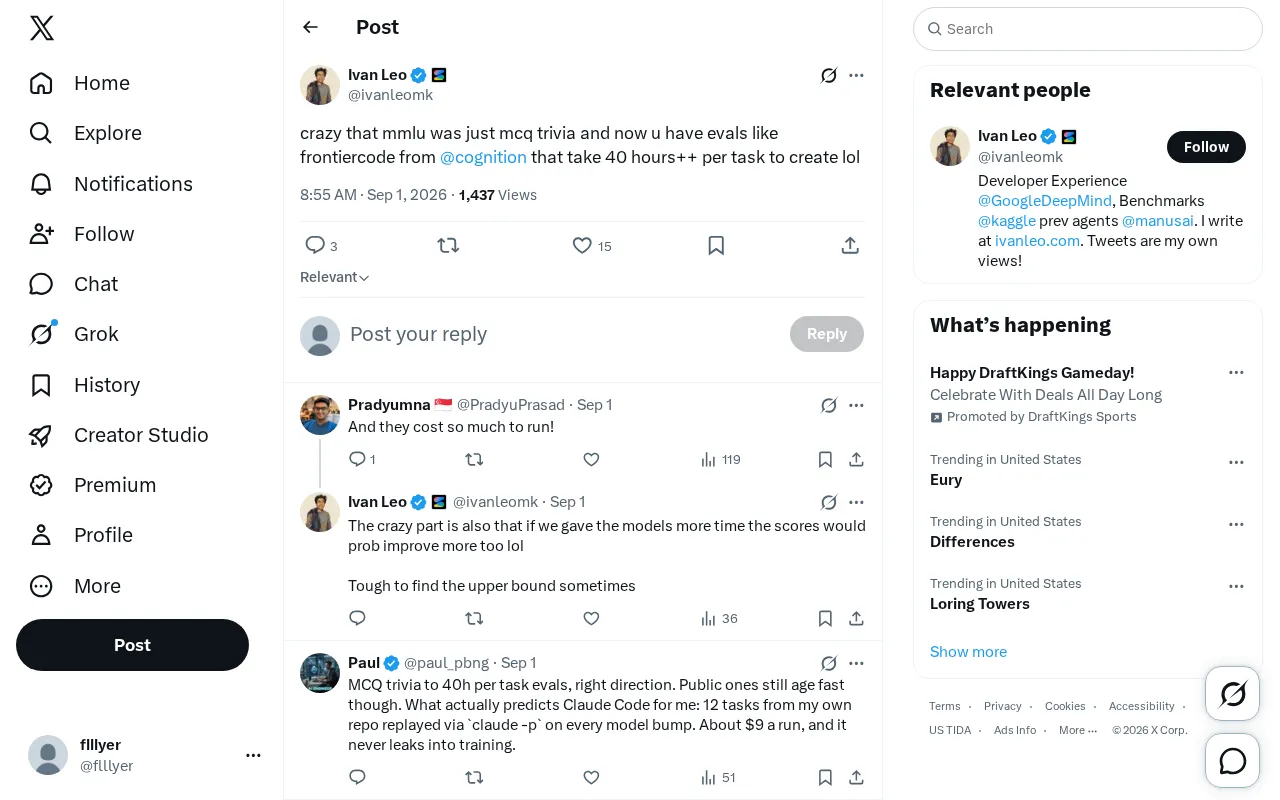
文章以一位AI研究者的推文为切入点,梳理了AI评测体系从MMLU到FrontierCode的演进历程。MMLU曾凭借标准化、易评分的多选题格式成为行业黄金标准,但随着顶尖模型准确率逼近90%以上,其区分度与有效性迅速衰退。Cognition推出的FrontierCode代表新范式:每道题耗时40余小时构建,测试的是模型在真实、长程、专家级工程任务中的实际完成能力,而非知识记忆。这背后是模型能力与评测难度之间持续的"军备竞赛"——模型刷爆旧基准,倒逼研究者设计更昂贵、更真实的新评测。结论指向一个更宏观的转变:AI已从"知识理解"阶段迈入"自主完成复杂专业工作"的新阶段,高质量评测基准本身正成为推动和衡量AI进步的关键基础设施。
一条推文引发的思考
近日,一位AI研究者在Twitter上发出感叹:"疯狂的是,MMLU不过是选择题问答,而现在你有了像Cognition推出的FrontierCode这样的评测,每道题目的构建就要花费40多个小时。"
这句看似随意的调侃,精准地捕捉到了AI评测领域正在发生的深刻变革。从早期简单的多选题测验,到如今需要专家投入数十小时才能设计出一道题目的复杂评测体系,AI基准测试(benchmark)的演进映射出整个大模型能力的飞速跃升。
MMLU:曾经的AI评测黄金标准
什么是MMLU
MMLU(Massive Multitask Language Understanding,大规模多任务语言理解)曾是衡量大语言模型知识水平的黄金标准。它涵盖从初等数学、美国历史到计算机科学、法律等57个学科领域,总计约1.6万道多选题。
在ChatGPT刚问世的年代,MMLU几乎是每一份模型发布报告的必备指标。研究者通过模型在这些选择题上的正确率,判断它"懂"多少知识。这种评测方式的优势显而易见:标准化、可量化、易于自动评分。只需比对模型选择的选项与标准答案是否一致,就能得出一个清晰的分数。
选择题范式为何失效
然而正如推文中所调侃的,MMLU本质上只是"选择题问答"(MCQ trivia)。随着GPT-4、Claude、Gemini等模型相继在MMLU上突破90%的准确率,这个基准的区分度迅速消失。当所有顶尖模型都拿到接近满分时,测试便失去了衡量能力差异的意义。
更深层的问题在于:选择题无法反映真实世界的复杂任务。现实中的工程问题、科研难题,很少有四个整齐排列的选项供你挑选。模型能选对答案,不代表它能独立完成一项需要长时间推理、多步骤规划的复杂工作。
FrontierCode:AI评测的范式转移
40小时构建一道题意味着什么
Cognition公司推出的FrontierCode代表了AI评测理念的根本性转变。当创建单个评测任务需要投入40小时以上的专家工时,背后传达的信号非常明确:我们正在测试的,是接近甚至超越人类专家水平的AI能力。
一道需要40小时构建的编程或工程任务,通常包含了:
- 真实的复杂场景:模拟实际软件工程中的大型代码库、多模块依赖关系
- 长程推理需求:需要模型进行数十步甚至上百步的连续推理与决策
- 难以取巧的答案:没有标准选项,只能通过实际运行和测试来验证正确性
- 专家级的验证成本:设计者本身必须是领域专家,才能构建出有挑战性的题目并判断答案质量
从测知识到测能力
这种转变的核心,是从"测知识"到"测能力"的跨越。MMLU测的是模型"知道什么",而FrontierCode这类评测测的是模型"能做什么"。
Cognition正是Devin——被称为"首个AI软件工程师"产品的开发商。他们对评测的重投入并非偶然,而是与产品定位高度一致:要证明AI可以像人类工程师一样工作,就必须用工程师级别的真实任务来考验它。
AI评测为什么越来越"贵"
模型能力与评测难度的军备竞赛
评测成本的飙升,本质上是被模型能力的进步"逼"出来的。当模型轻松刷爆简单基准时,研究社区不得不设计出更难、更接近现实的测试。这形成了一个持续的"军备竞赛":
- 模型能力提升 → 现有基准饱和
- 研究者设计更难的基准 → 评测成本上升
- 模型再次突破 → 循环重复
近年来涌现的一系列高难度评测,如GPQA(研究生级科学问答)、SWE-bench(真实软件工程任务),以及各类需要长时间执行的Agentic评测,都印证了这一趋势。
优质评测数据正成为稀缺资源
当一道题目的制作成本高达40小时,优质评测数据本身就成为极其宝贵的资产。这也解释了为什么Cognition、OpenAI、Anthropic这样的前沿实验室,愿意投入大量资源和顶尖专家来构建私有评测集。高质量的AI评测基准,正在成为衡量和推动AI进步的关键基础设施。
从评测进化看AI发展的新阶段
从MMLU到FrontierCode的演进,不仅仅是评测方法的技术升级,更折射出AI发展阶段的根本变化。
我们正在从"AI能否理解和记忆知识"的时代,迈入"AI能否自主完成复杂专业工作"的时代。当评测任务的难度和真实性逼近人类专家的日常工作,我们对AI能力的判断也从抽象的分数,转向了更具实际意义的"生产力"衡量。
对于开发者和企业而言,这意味着评估AI工具时,应当更加关注它在真实、复杂、长程任务中的表现,而非停留在简单的benchmark分数上。对于整个行业来说,评测的"通货膨胀"恰恰是AI能力突飞猛进最生动的注脚。
相关推荐

合理使用制度为何对AI时代人人有益
从Hacker News讨论出发,解析合理使用(Fair Use)原则在AI训练与内容创作中的法律逻辑、争议焦点及其对创作者与技术生态的双重影响。

Salesforce 3.75亿美元收购Rune,AI物流技术补强国防业务
Salesforce 据报道以 3.75 亿美元收购国防科技初创公司 Rune,这家 AI 物流公司的技术将用于补强 Salesforce 的 Missionforce 国防平台,也延续了 Salesforce 近期的并购节奏。

Mistral Large 4开源万亿参数,微软6万员工自愿离职
Mistral Large 4 开源万亿参数多模态模型,编码智能体评测得分 48;闪迪财报显示 AI 推理重塑 NAND 需求;谷歌 Gemini 上线应用内文件编辑,OpenAI 上调 Codex 额度,微软向 6 万员工提供自愿离职方案。