从Opus迁移到自托管Ollama:35KB长提示词的踩坑笔记
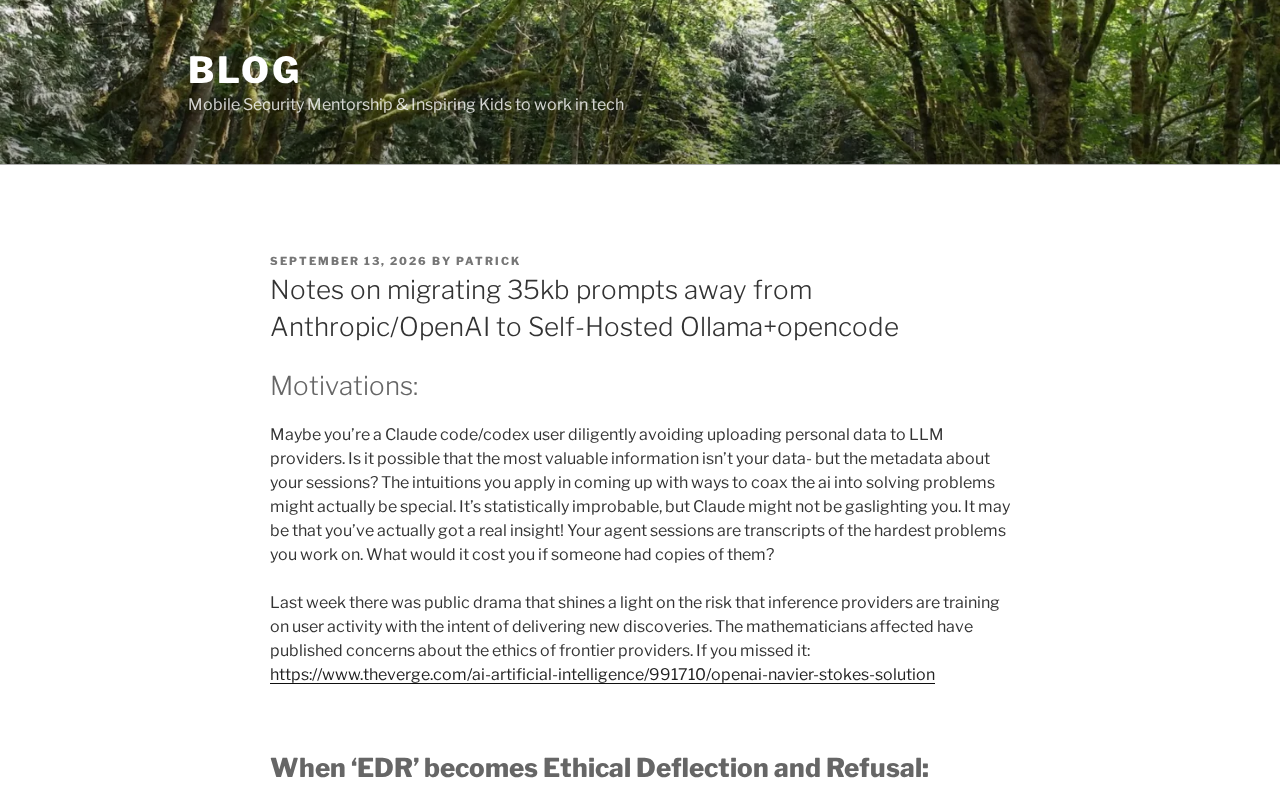
将35KB长提示词从Anthropic Opus迁移至本地Ollama,面临上下文截断、模型能力差距与模板不兼容三大核心挑战。
本文记录了将约35KB大型预置提示词从云端商业模型(Anthropic Opus)迁移至本地自托管Ollama时遭遇的实际问题。核心挑战集中在三个层面:一是上下文窗口错配,35KB文本约合8000-10000 token,Ollama默认配置可能静默截断提示词而不报错,必须通过num_ctx参数显式扩容;二是模型能力鸿沟,顶级商业模型与本地7B/13B开源模型在指令遵循和推理一致性上差距显著,提示词往往需要针对目标模型重写而非直接复用;三是格式兼容性问题,不同模型家族的chat template和特殊标记各有约定,为Opus优化的XML风格标签结构在其他模型上可能失效。文章建议迁移前建立检查清单,先用真实提示词做小规模验证,用实测数据评估能力落差,再权衡完全替换还是采用保留高难度任务在商业模型的混合方案。
迁移长提示词的现实挑战
将大型语言模型工作负载从云端商业API(如Anthropic的Opus)迁移到自托管的Ollama,是不少团队出于成本、隐私和可控性考虑正在尝试的路径。但当涉及到体量庞大的预置提示词(preprompt)时,事情往往没有想象中简单。这篇来自Hacker News社区的分享,记录了作者在迁移一份约35KB的preprompt过程中遇到的实际问题。
35KB的提示词并不是随意堆砌的字符,它通常承载着复杂的系统指令、行为约束、示例样本以及领域知识。这类内容在Opus这样的顶级商业模型上运行良好,但换到本地部署的开源模型时,模型能力、上下文处理方式和推理表现的差异会被迅速放大。原帖虽然讨论热度有限(20 points、4条评论),但触及的是许多实践者真实面对的痛点。
上下文窗口与提示词体量的错配
35KB的文本按英文估算大约相当于8000到10000个token,这个规模已经逼近或超过部分开源模型的默认上下文窗口。Ollama在本地运行时,上下文长度受模型本身架构和显存/内存资源双重限制。
如果不显式配置,Ollama可能会静默截断超出默认窗口的部分内容——这意味着你精心编写的提示词后半段可能根本没有进入模型视野。这是迁移中最隐蔽也最致命的陷阱之一:模型没有报错,只是"看不见"你的完整指令,导致输出行为莫名其妙地偏离预期。
实践中,需要通过num_ctx等参数显式设置更大的上下文窗口,并确认所选模型确实支持该长度。同时要意识到,更长的上下文会显著增加内存占用和推理延迟。
模型能力差异带来的行为漂移
Opus属于当前第一梯队的大参数量商业模型,其指令遵循能力、长文本理解和推理一致性远超多数可本地部署的开源模型。同一份提示词,Opus能准确解析并执行的复杂约束,7B或13B级别的本地模型可能只能部分理解。
这就要求迁移不是简单的"复制粘贴",而往往需要针对目标模型重写提示词。原本依赖模型强推理能力隐式完成的任务,在弱模型上可能需要拆解成更明确、更结构化的步骤指令。示例(few-shot)的作用会被放大,而过于依赖抽象描述的部分则需要具体化。
换句话说,提示词是与特定模型能力耦合的工程产物,跨模型迁移本质上是一次针对新目标的重新调优。
格式与特殊标记的兼容性问题
不同模型家族使用不同的对话模板和特殊标记(chat template、special tokens)。Anthropic的Opus有其特定的提示词组织习惯和XML风格标签偏好,而Ollama背后的各类开源模型(如Llama、Mistral、Qwen系列)各有各的模板约定。
直接搬运为Opus优化的格式,可能在本地模型上产生解析混乱。例如系统提示与用户消息的边界处理、角色标记的写法、以及模型对结构化标签的敏感度都存在差异。迁移时需要检查Ollama对应模型的Modelfile模板配置,确保提示词的结构化元素被正确注入。
迁移前值得建立的检查清单
综合这类实践经验,跨模型迁移长提示词时可以关注几个关键点:
- 确认上下文窗口:明确目标模型支持的最大token数,并通过参数显式配置,避免静默截断。
- 评估硬件资源:长上下文与大模型对显存和内存要求较高,需提前压测推理延迟。
- 重构而非照搬:根据目标模型的能力水平,将隐式约束显式化、抽象描述具体化。
- 对齐提示模板:检查目标模型的chat template和特殊标记,调整提示词结构。
- 建立回归测试:用一组代表性输入对比迁移前后的输出质量,量化能力落差。
成本与可控性之外的隐性代价
自托管Ollama的吸引力在于数据不出内网、无API调用费用、以及完全的部署控制权。但这篇笔记提醒我们,这些收益背后存在被低估的迁移成本和维护复杂度。
提示词工程与模型深度绑定,一旦更换底层模型,前期在商业API上积累的调优成果可能大打折扣,需要投入额外的工程精力重新适配。对于依赖长提示词、复杂指令的应用场景,从顶级商业模型迁移到本地开源模型,本质上是在成本、隐私与输出质量之间做权衡。
对正在评估类似迁移路径的团队来说,最实际的建议或许是:先用真实提示词在目标模型上做小规模验证,用数据看清能力差距,再决定迁移策略——是完全替换,还是采用混合方案,将高难度任务保留在商业模型上。
相关推荐
抛弃向量数据库:用BM25为LangChain智能体构建记忆层
一位开源开发者构建了 CogniCore——用 BM25 检索替代嵌入向量、无需向量数据库的 LangChain 智能体记忆层,并在 LongMemEval 基准上小上下文场景反超嵌入方案,还实现了跨平台智能体记忆迁移。
一体化AI平台真的靠谱吗?告别多订阅困境的实用指南
内容创作者厌倦了同时订阅ChatGPT、Claude和Midjourney。一体化AI平台真能省钱又好用吗?本文分析聚合平台的真实权衡,并给出实用的工具组合建议。
iPhone 18 Pro发布前,谷歌Pixel 11降价抢市场
苹果iPhone 18 Pro将于9月18日发售,谷歌抢先为Pixel 11系列降价。Pixel 11 Pro亚马逊售价约1007美元,几乎抵消了今年100美元的涨幅。本文解析这场发布前价格战的市场逻辑与消费者影响。