Context Encoders 深度解析:用图像修复实现自监督特征学习
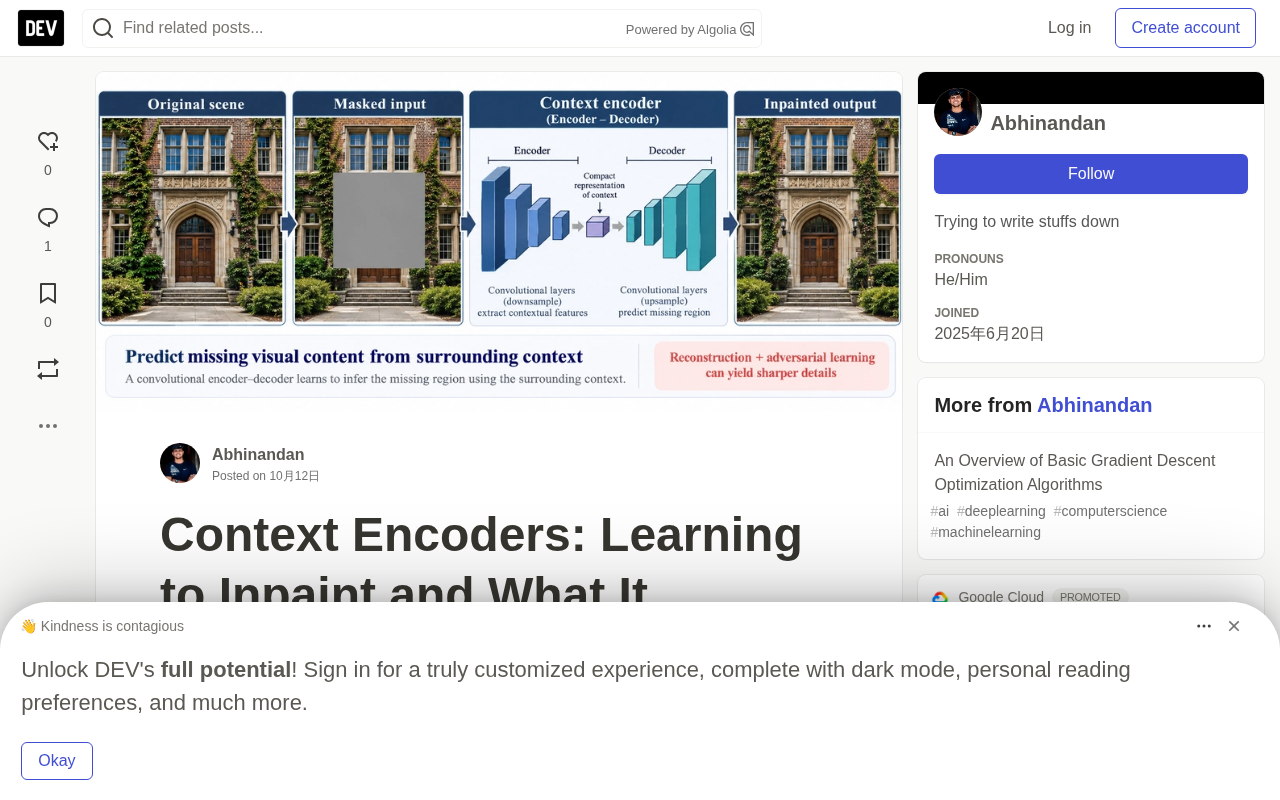
Context Encoders 用「图像填空」任务无监督学习可迁移视觉特征,是掩码建模方法的奠基性工作。
Context Encoders 是一篇 2016 年的经典论文,提出用图像修复(Inpainting)作为自监督任务来学习图像特征。网络以带空洞的图像为输入,通过编码器-解码器结构预测缺失内容,核心创新是「通道级全连接层」——在不引爆参数量的前提下实现远距离空间信息传递。损失函数由重建损失(L2)与 GAN 对抗损失联合构成:前者保证结构连续性,后者将模糊的均值预测逼向清晰逼真的输出。训练无需任何人工标签,学到的编码器特征可直接迁移到分类、检测与分割任务,效果与当时其他无监督方法相当。该工作被视为掩码自编码器(MAE)等现代掩码建模方法的重要思想先驱。
我们的视觉世界高度多样,却又充满结构,而人类拥有一种难以言喻的能力去理解这种结构。
人类面对画面残缺时有一种近乎本能的预测能力。看到一座建筑一角被遮挡,我们几乎能自动「脑补」出缺失的部分——因为我们知道那里应该有窗、有墙、有相应的纹理。计算机视觉能否也具备这种能力?这正是经典论文 Context Encoders: Feature Learning by Inpainting 所回答的问题。本文将基于原始论文,结合一个 PyTorch + CelebA 的从零复现,梳理 Context Encoders 的核心思想与实现细节。
什么是图像修复(Inpainting),它为何能学到特征
Inpainting 指的是修复或填补图像中缺失、损坏或不需要的区域,使修补后的部分与周围无缝衔接。这个定义里藏着一个关键的洞察:一个网络要想合理地填补缺失的区块,它就必须理解图像里到底有什么内容——而这个理解过程不需要任何人工标签。
这正是 Context Encoders 下的赌注。它同时追求两个目标:
- 语义修复(Semantic Inpainting):为空洞生成合理的内容,而不是简单地把邻近像素涂抹进去。
- 无监督特征学习(Unsupervised Feature Learning):证明一个仅在「填空」任务上训练的编码器,所学到的特征可以迁移到分类、检测和分割等下游任务。
换句话说,修复只是表象,真正的收获是编码器在这个过程中被迫学会了图像的语义表征。这也是它被视为自监督学习奠基性一步的原因。
编码器-解码器架构:为什么没有瓶颈层
Context Encoder 本质上是一个卷积编码器-解码器结构。编码器把残缺图像压缩成一个紧凑的潜在特征表示,解码器再用这个表示生成缺失的图像内容。它的整体思路接近经典的 自编码器,但有一个关键差异。
原论文的编码器取自 AlexNet 的前五个卷积层加池化层,一张 227×227 的输入会变成 6×6×256 的表示。但它并非为 ImageNet 分类而训练,而是以随机权重从零开始,只在修复任务上训练。
与传统自编码器最大的不同在于:这里没有狭窄的瓶颈层。普通自编码器需要重建整个输入,因此必须用一个小的编码来避免直接「复制」输入;而 Context Encoder 的输入本身就带有空洞,目标是缺失内容,网络天然被迫去「推断」而非「复制」。
在本文的 128×128 CelebA 版本里,作者保留了 AlexNet 的风格,但调整了步长,让潜在特征图变为 8×8×256,并在每个卷积后加入 BatchNorm 和 LeakyReLU——其中 BatchNorm 是为稳定训练而额外添加的,并非论文原文描述。
class Encoder(nn.Module):
    def __init__(self):
        super().__init__()
        def block(cin, cout, k, s, p):
            return nn.Sequential(
                nn.Conv2d(cin, cout, k, s, p, bias=False),
                nn.BatchNorm2d(cout),
                nn.LeakyReLU(0.2, inplace=True))
        self.net = nn.Sequential(
            block(3,   64,  7, 2, 3),   # 128 -> 64
            nn.MaxPool2d(3, 2, 1),      # 64  -> 32
            block(64,  192, 5, 1, 2),   # 32
            nn.MaxPool2d(3, 2, 1),      # 32  -> 16
            block(192, 384, 3, 1, 1),   # 16
            block(384, 256, 3, 1, 1),   # 16
            block(256, 256, 3, 1, 1),   # 16 (conv5)
            nn.MaxPool2d(3, 2, 1),      # 16  -> 8 (pool5)
        )
    def forward(self, x):
        return self.net(x)
自编码器(Autoencoder)是一种将输入压缩为低维「瓶颈」表示再重建的神经网络。其核心假设是:若网络必须从比输入小得多的编码中还原输入,它就被迫只保留最重要的信息,从而学到有意义的特征。然而这个假设也埋下了隐患——过小的瓶颈会丢失过多细节,过大则退化为简单复制。Context Encoders 绕开了这一两难:空洞的存在本身就消除了「直接复制」的可能,网络必须依靠上下文「推断」而非「记忆」缺失部分,因此无需人为缩窄瓶颈来制造学习压力。这一设计思路后来被 MAE(Masked Autoencoders)等工作进一步发扬光大——用高掩码率替代瓶颈约束,迫使模型学习语义表示。
通道级全连接层:让信息跨越整张图像
这是 Context Encoders 最核心的架构创新。卷积层会把所有特征图连接在一起,却从不连接单张特征图内部的远距离位置——换句话说,一个角落的信息无法直接传递到对角。对修复任务而言这是个真正的限制,因为最能预测人脸中心的像素,可能恰好位于远离中心的位置。
全连接层能解决这个问题,因为每个激活都与其他所有激活相连,但代价是参数爆炸。将一个 256 通道、尺寸 n×n 的特征图用完整 FC 层连接到解码器,需要 m²n⁴ 个参数,论文指出这会超过一亿参数,在当时的 GPU 上根本无法训练。
解决方案是带分组的全连接层:每张特征图拥有自己的 n²×n² 权重矩阵,不同特征图之间互不相连,参数量从 m²n⁴ 降到 m·n⁴。对于本文的 8×8×256 潜在特征,这意味着约 256 × 8⁴ ≈ 105 万 个权重,而完整 FC 层则需约 2.68 亿。由于这一层不混合通道,论文随后接一个 stride-1 卷积(本文用 1×1 卷积实现)来跨通道传播信息。
class ChannelWiseFC(nn.Module):
    def __init__(self, channels, size):
        super().__init__()
        self.n2 = size * size
        self.weight = nn.Parameter(torch.empty(channels, self.n2, self.n2))
        self.bias = nn.Parameter(torch.zeros(channels, self.n2))
        bound = 1 / self.n2 ** 0.5
        nn.init.uniform_(self.weight, -bound, bound)
    def forward(self, x):
        B, m, n, _ = x.shape
        x = x.reshape(B, m, self.n2)
        x = torch.einsum('bmi,mij->bmj', x, self.weight)
        return (x + self.bias).reshape(B, m, n, n)
解码器则由通道级 FC 层、1×1 卷积和五个上卷积层(up-convolution)组成,逐步把特征图放大回像素空间,最后用 Tanh 匹配 [-1, 1] 的归一化范围。
双重损失:重建损失与对抗损失的分工
一个空洞往往有多种合理的填法,因此 Context Encoders 采用了一个解耦的联合损失函数,分别处理「与上下文的连续性」和「输出的多模态性」。
重建损失:抓住结构,却带来模糊
第一个是归一化的掩码 L2 距离,只在空洞内部比较预测与真实值。掩码 M 会将网络已经看到的像素全部置零,使模型无法通过复制上下文得分。论文尝试了 L1 和 L2,发现差异不显著。
class ReconstructionLoss(nn.Module):
    def forward(self, pred, target, mask):
        diff = mask * (target - pred)
        sq_err = diff.pow(2).sum(dim=(1, 2, 3))
        norm = mask.sum(dim=(1, 2, 3)) * pred.size(1) + 1e-8
        return (sq_err / norm).mean()
重建损失有个大家都知道的弱点:它鼓励缺失物体的大致轮廓,却无法捕捉高频细节。原因在于,当多种填法都合理时,L2 最安全的预测是分布的「均值」——而许多张清晰人脸的均值,就是一张模糊的脸。
对抗损失:用 GAN 把模糊逼成清晰
为了修复这种模糊,论文引入了一个 GAN 风格的对抗损失。判别器 D 学习区分真实图像与 Context Encoder 的输出,而充当生成器 G 的 Context Encoder 则试图骗过它。这样一来,生成一张清晰逼真的脸就比生成模糊的均值得分更高。
论文在适配 GAN 时做了两个关键选择:
- 只让生成器以上下文为条件,判别器不加条件。如果判别器也看到上下文,它会轻易利用生成区域与原始区域之间可见的不连续性来识别假图,走捷径。
- 不使用噪声向量。作者发现不给生成器噪声反而效果更好,上下文本身已提供了足够的变化。
class AdversarialLoss(nn.Module):
    def __init__(self):
        super().__init__()
        self.bce = nn.BCEWithLogitsLoss()
    def d_loss(self, d_real, d_fake):
        return (self.bce(d_real, torch.ones_like(d_real)) +
                self.bce(d_fake, torch.zeros_like(d_fake)))
    def g_loss(self, d_fake):
        return self.bce(d_fake, torch.ones_like(d_fake))
最终目标是两种损失的加权和,重建项占主导,对抗项起到「锐化推力」的作用。生成器与判别器通过交替更新联合优化。值得一提的是,论文指出对抗训练在其 AlexNet 特征学习实验中会发散,因此对抗损失仅用于修复实验。
生成对抗网络(GAN)由 Goodfellow 等人于 2014 年提出,其核心思想是让生成器(Generator)与判别器(Discriminator)相互博弈:生成器试图合成以假乱真的样本,判别器则试图识破它。两者交替训练,形成一个动态的「猫鼠游戏」,理论上最终达到纳什均衡。GAN 的关键优势在于它定义了一个隐式的、依赖数据的损失函数——判别器会自动学会惩罚任何与真实分布不一致的输出,包括模糊、色块、纹理缺失等 L2 损失无法感知的问题。但 GAN 训练也以不稳定著称,容易出现模式崩塌(mode collapse,生成器只产出少数几种输出)或训练发散。Context Encoders 中对抗损失仅用于修复实验而未用于特征学习预训练,正是因为论文作者观察到在 AlexNet 特征学习设置下对抗训练会发散。
掩码策略、训练与结果
论文使用了三种掩码策略:
- 中心区域(Central Region):图像中央的方形块,最简单,但网络可能过拟合空洞位置,学到无法泛化的特征。
- 随机块(Random Block):随机位置的多个小矩形,位置有变化,但锐利的矩形边缘仍会给网络暗示。
- 随机区域(Random Region):以随机游走笔刷绘制的不规则斑块,最接近真实遮挡,论文报告它在特征学习上效果最好。
本文的实现中每种掩码最多覆盖约四分之一的图像,训练时每个 batch 随机选择一种掩码类型,共训练 20 个 epoch。
class ContextEncoder(nn.Module):
    def __init__(self):
        super().__init__()
        self.encoder = Encoder()   # AlexNet 风格
        self.decoder = Decoder()   # 通道级 FC -> 1x1 卷积 -> 5 个上卷积
    def forward(self, masked_img):
        return self.decoder(self.encoder(masked_img))
论文的结论是:仅用重建损失会得到模糊的填补,而加上对抗损失后能产生更清晰、更真实的补全。更重要的是,用这种方式预训练的编码器在 PASCAL VOC 上微调后,在分类、检测和分割任务上取得了与当时无监督预训练方法相当的成绩——完全不依赖 ImageNet 标签。
对于小规模复现,几千张 CelebA 图像加上几十个 epoch,补全结果通常合理但偏柔和。人脸因高度结构化而相对容易,但发丝、皮肤等精细纹理需要远更多的数据和训练,这反映的是数据与算力的限制,而非架构缺陷。
局限与影响:从 Context Encoders 到掩码建模
这一方法有真实的局限:输出的清晰度依赖微妙的 GAN 平衡;单一的确定性输出无法表征大空洞的多种合理填法;而通道级 FC 层绑定了固定的潜在尺寸,使网络难以原生处理不同分辨率的图像。
但它的思想一路延续下来。后续基于 GAN 的修复方法加入了全局与局部判别器、上下文注意力和门控卷积,以处理更大、更不规则的空洞。而掩码自编码器(Masked Autoencoders)等掩码建模方法则回到了同一个核心赌注:遮住输入的一部分,去预测它,并把学到良好表征作为副产品。Context Encoders 正是最早、最清晰地证明这一思路对图像有效的工作之一,它在自监督视觉学习的发展史上留下了关键的一笔。
掩码自编码器(Masked Autoencoders,MAE)由 He 等人于 2021 年提出,将掩码建模思路与 Vision Transformer(ViT)结合,在 75% 的极高掩码率下预训练编码器,取得了优异的下游迁移性能。与 Context Encoders 相比,MAE 不使用对抗损失,完全依赖像素级重建损失,却因 Transformer 的全局注意力机制天然具备跨位置信息传递能力,无需专门设计通道级 FC 层。这一对比清晰地展示了架构进步如何让更简单的目标函数获得更强的表征能力。Context Encoders 提出时(2016 年)GPU 算力和大规模数据集的限制,使得论文不得不做出大量工程妥协;而 MAE 所在的时代让「暴力掩码 + 大模型」成为可行选项,但其背后的核心假设与 Context Encoders 如出一辙。
相关推荐

一句提示词引发的全球PHP安全风暴:AI是救星还是隐患?
一句AI提示词竟引发全球PHP安全危机,维基百科、互联网档案馆受波及。本文梳理事件脉络,解析OpenAI与亚马逊的争议,探讨AI时代漏洞发现门槛降低带来的安全悖论与开发者应对策略。

当AI被拿走:依赖捷径如何削弱你的解题韧性
一项涉及1,222人的研究发现:使用AI答题后,一旦AI被移除,人们放弃解题的比例高于从未使用AI的对照组。文章分析AI依赖对学习韧性和元认知的影响,并探讨AI学习工具的设计启示。

Carta联手NewView:让创业公司员工提前套现股权
Carta 与 NewView Capital 合作推出新计划,简化创业公司 tender offer 流程,帮助员工提前出售股权套现。本文分析该合作的核心机制、员工股权流动性痛点及对创业公司股权激励的影响。