Context Mode实测:AI Agent上下文瘦身98%是真是假

Context Mode 用沙箱加检索压缩上下文,热度惊人但 98% 的宣传数字缺乏独立验证。
Context Mode 是一个以 MCP Server 形式接入 18 种 AI Agent 的上下文压缩工具,通过沙箱执行加本地检索的方式,让原始输出不直接进入模型上下文,官方示例把 315 KB 压到 5.4 KB。项目在不到 8 个月拿下 28000+ 星标、60 万 NPM 下载和 HN 570 分,说明上下文膨胀是真实痛点。但宣称的 98% 缩减没有第三方验证,自测平均 96%、最差 13%,用户体感仅 30%-40%,差距源于统计口径被极端样本拉高。它适合超大日志、浏览器快照等重任务,小任务则可能被工具自身约 15000 Tokens 的每次开销抵消。3 月起项目切换至 Elastic License,商业集成需留意条款。
Context Mode实测:AI Agent上下文瘦身98%是真是假
AI Agent 干到一半突然"失忆",是很多人用 Claude Code、Cursor 时的共同体验。根因往往不是模型不行,而是上下文窗口被塞满了。一个叫 Context Mode 的 GitHub 项目声称能把进入模型的数据砍掉 98%,它在不到 8 个月里拿下 28000+ 星标。这个数字站得住脚吗?
Context Mode 到底做了什么
Context Mode 是一个 MCP Server,通过 Hooks 接入 Claude Code、Codex、Cursor、Gemini CLI 等工具。按 Readme 的说法,它兼容的 Agent 总数达到 18 个。
它的核心设计可以概括为一句话:不让原始输出直接进模型。
具体流程是——命令先在一个沙箱里执行,只有最终结果回传给 Agent,其余的大量中间数据被写进一个本地搜索数据库,Agent 需要时再去检索。官方给出的示例是:315 KB 的上下文被压缩到 5.4 KB。会话时长也从大约 30 分钟拉长到最长 3 小时。
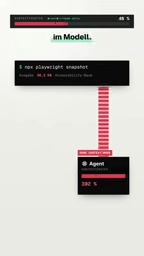
这个思路本质上是把"全量灌注"换成"按需检索",对跑大型日志、浏览器快照、大文件分析的场景来说,方向是对的。
MCP(Model Context Protocol) 是 Anthropic 在 2024 年底推出并开源的协议,用来标准化 AI 模型与外部工具、数据源之间的连接方式。在此之前,每款 Agent 产品(Claude Code、Cursor、Codex 等)都要为每个工具单独写适配层,生态碎片化严重。MCP 把这件事抽象成统一的 Server-Client 结构:工具方实现一个 MCP Server,暴露若干"工具"和"资源",任何支持 MCP 的 Agent 都能直接调用。Context Mode 正是以 MCP Server 的形式发布,这也是它能同时兼容 18 个 Agent 的根本原因——写一次,处处可用。
Hooks 则是 Agent 在执行流程中预留的拦截点,比如"工具调用前""工具返回后""会话开始时"。Context Mode 通过注册 Hooks,在工具输出即将进入上下文的那一刻把它截走,改写后再放行,从而实现"原始输出不进模型"。可以理解为:MCP 决定了它能被谁调用,Hooks 决定了它能在哪个环节动手。
社区热度:数据确实漂亮
从增长曲线上看,Context Mode 不是一个小打小闹的项目。28000+ 星标、近 2000 个 Fork、111 位贡献者,NPM 下载量超过 60 万次。在 Hacker News 上拿到 570 分,本周再次冲上 GitHub Trending 第 4 名,单日新增近 1000 星。
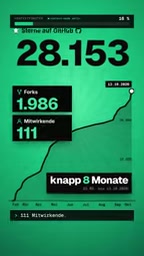
这些数字至少说明一件事:上下文膨胀是真实存在的痛点,而不是被制造出来的需求。一个工具能在短时间内聚集这么多关注,通常意味着它踩中了普遍性问题。
98% 这个数字经得起推敲吗
项目宣称的 98% 缩减,目前没有独立第三方验证。
它自己的 Benchmark 平均下来是 96%,最差的情况下只有 13%。而用户的体感普遍落在 30% 到 40% 之间——和宣传口径之间的落差不算小。
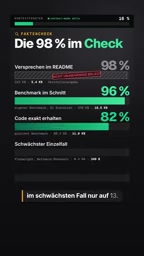
这组数据值得拆开看。96% 的平均值很可能被极端场景拉高了:一个几百 KB 的日志文件被压到几 KB,单次缩减比例自然惊人。但日常开发中的大量任务是中等规模甚至小规模的,这时候压缩空间有限,体感自然接近 30%-40%。98%、96%、13%、30-40% 这四个数字并不矛盾,它们描述的是不同场景下的分布。
Benchmark 与体感数据为何差距这么大,关键在"压缩率"的统计口径。 压缩率通常按 (原始上下文 − 压缩后上下文) / 原始上下文 计算,属于比值型指标,对极端样本极为敏感。一个 315 KB 的日志压到 5.4 KB,单次就是 98.3% 的缩减,足以把整体平均值大幅抬高;而日常任务里上下文可能只有几 KB,压缩后仍有几百字节的固定开销,比值自然落在 30%-40%。这和平均值容易被少数极端值主导是同一类统计现象。
因此看这类宣传数字时,更该关注的是中位数和分位数分布,而不是平均值。项目自测"最差 13%"其实反而透露了真实分布的下沿。对使用者来说,判断标准不应该是"能不能压到 98%",而是"我的典型任务落在分布的哪个位置"。
用户反馈:效率提升是真的,代价也是真的
正面反馈集中在两点:Token 消耗明显下降,且多数用户没有察觉到输出质量的下滑。有人提到一次大型分析从 45 分钟缩短到 5 分钟。
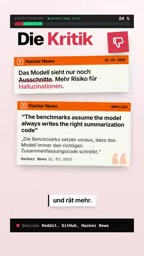
批评同样具体。部分配置下,光工具本身每次请求就要消耗约 15000 Tokens——这个开销对小任务来说可能直接抵消了节省。另有用户反映,模型因为只能看到片段,猜测的成分变多了。
这暴露了 Context Mode 的根本权衡:你换来的上下文效率,是用"模型看不到全貌"作为代价的。对于需要全局推理的任务,这个代价可能不划算。
"模型看不到全貌"为什么会导致猜测变多,涉及检索增强的一个固有缺陷。 当 Agent 只能拿到片段而非完整输出时,它对全局结构的把握变弱:变量在哪定义、函数被谁调用、日志前后哪一段才是根因,这些跨片段的推理必须靠多次检索拼凑。如果检索命中不精准,模型就会用"看起来合理"的内容去填空,表现为幻觉增多。
更麻烦的是错误会累积:一次错误的片段理解可能让后续检索方向跑偏,最终答案表面通顺、实则失准。这类问题在需要全局推理的任务(重构、跨文件调试、架构分析)中尤其突出,而在"找一条日志里的报错"这种局部任务里几乎无感。这也解释了为什么用户反馈呈两极:轻度使用者只觉得省了 Token,重度分析型用户则抱怨模型变"聪明但健忘"。评估时最好按任务类型分别测,而不是看总体满意度。
许可证变化需要留意
从 3 月起,Context Mode 从传统开源协议切换到了 Elastic License。这意味着它可以被自由使用,但在商业分发和托管服务方面受到限制。如果你打算把它集成进商业产品,需要仔细读一遍条款。
Elastic License 2.0(ELv2)不是 OSI 认可的开源协议。 它允许你自由使用、修改、分发源码,但设了两条核心限制:不得把该软件作为托管或管理服务提供给第三方,也不得绕过其许可证密钥功能。也就是说,自己内部用、集成进非售卖产品都没问题,但如果你想基于它做一个 SaaS 卖给客户,就触碰了红线。
从 Apache/MIT 这类传统开源协议切到 ELv2,是近几年不少基础设施项目的常见路径:早期用宽松协议换增长和社区贡献,等产品跑通、商业化压力上来后收紧条款。对 28000+ 星标的项目而言,这种切换会直接影响下游商业集成者和云厂商。如果你只是个人开发者,影响不大;如果你在评估把它放进公司产品,需要在集成前就让法务过一遍条款,尤其是"托管服务"的界定边界。
什么时候值得用
Context Mode 的适用边界比较清晰:
- 适合:处理超大日志、浏览器快照、大型代码库分析等上下文天然膨胀的任务
- 不太适合:小规模、短会话的日常编码任务,工具本身的 Token 开销可能得不偿失
- 建议先测:项目自带统计命令,可以在自己的实际工作流里量化压缩效果,而不是直接采信宣传数字
一个有趣的细节:制作这条评测视频的 AI Agent,自己就跑在 Context Mode 上。工具方自己用,至少说明他们对产品有基本信心,但这也意味着评测视角天然带有一定偏向。
最终判断很简单——上下文压缩这个方向是对的,98% 这个具体数字需要打个问号,而它对你是否有效,取决于你的任务有多"大"。
相关推荐

OpenAI与Shield合作:Astra智能体如何革新IT故障修复
OpenAI与Shield合作推出Astra智能体,可自动登录电脑和遗留系统,实时修复IT故障,比传统模型快35%到40%,仅在需要人类判断时引入人工。

iPhone Duo续航实测:一天一充跑不掉,大屏是耗电元凶
iPhone Duo续航实测:重度使用一天需至少充电一次,6.5小时亮屏约剩30%电量。大屏展开频率是耗电关键,MagSafe电池背夹可救场,长期衰减同样值得关注。

Kimi K3.1 Pro开源发布:2.8万亿参数逼近Opus
Moonshot发布开源MoE模型Kimi K3.1 Pro,2.8万亿总参数、1040亿激活参数,Terminal Bench 4.0仅落后Opus 5.5不到1分,单任务成本约三分之一,API价格减半,开源权重11月4日开放。