Cursor + MetaMuse Spark 1.3 实测:低成本AI编程能否媲美前沿模型

MetaMuse Spark 1.3 以约4.25美元/百万token的低价,在Cursor中实现接近主流模型的编程辅助体验。
MetaMuse Spark 1.3 是一款在讨论热度上低于 GPT 和 Claude 的模型,但其输出 token 价格(约 4.25 美元/百万)仅为 Claude/Opus 的一半左右。本文基于一位开发者的实测视频,记录了该模型在 Cursor IDE 中搭配 Plan Mode 生成 SaaS 仪表盘的全过程:约七分钟、消耗 78K token,产出带有可交互图表的深色主题 Next.js 应用。测试还覆盖了多轮迭代(修改配色、新增分析页)、跨对话任务(在新会话中独立生成 api.js 并配置路由结构)以及 Ask Mode 问答。结论认为,Spark 1.3 在 UI 生成速度和问答准确性上表现良好,适合作为中小型任务的高性价比替代选项,大型严肃项目仍建议保留旗舰模型。
MetaMuse Spark 1.3 并没有像 GPT 或 Claude 那样频繁出现在讨论中,但它在基准测试上的表现却逼近前沿模型。更关键的是,它的价格只有主流模型的一小部分。本文基于一位 YouTube 开发者的实测视频,验证这款模型搭配 Cursor 用于日常编程时的真实表现。
成本优势是最大卖点
按照视频作者的说法,MetaMuse Spark 的输出 token 价格约为 每百万 token 4.25 美元,而 Claude 或 Opus 这类模型大约在 10 美元上下。单从输出成本看,每百万 token 可节省约 5.75 美元,差距接近一半以上。
对于高频调用、需要反复迭代代码的开发者来说,这种价格差异在长期使用中会被显著放大。作者的核心疑问也正源于此:在性价比的前提下,Spark 1.3 是否足够胜任日常开发工作? 这不是要它取代最强模型,而是看它能否在成本敏感的场景下成为可靠的替代选择。
在大语言模型的定价体系中,输入 token 与输出 token 通常分开计费,且输出 token 的单价普遍高于输入 token——因为生成每个 token 都需要模型进行完整的前向推理,而处理输入可以借助 KV Cache 等机制摊薄计算成本。对于代码生成场景,一次完整的对话往往包含大量输出(函数、注释、配置文件),输出成本因此成为实际账单的主要构成部分。文中提到的"每百万 token 4.25 美元"即指输出侧单价,是评估编程场景长期使用成本的核心指标。此外,78K token 的上下文消耗量也值得关注——部分模型对超长上下文会额外收费或性能下降,这在选型时同样需要纳入考量。
用 Cursor + Plan Mode 搭建 SaaS 仪表盘
作者长期使用 Cursor,认为它是目前体验最好的 AI IDE,可以接入大多数前沿模型。这次测试的流程是:在 Cursor 中切换到 Plan Mode,让 Spark 先规划,再执行代码编写。
首个提示词很简单——创建一个 SaaS 仪表盘,技术栈指定为 Next.js(App Router)、Tailwind CSS 和 Lucide React 图标。进入 Plan Mode 后,Spark 的规划速度明显比 Claude 快。作者提到 Claude 通常在准备阶段会花费较多时间,而 Spark 很快就列出了依赖项和需要实现的函数。
七分钟产出初版
从 8:05 开始生成,到 8:12 完成初版,整个过程约 七分钟,上下文消耗约 78K token。作者评价生成速度相当快。
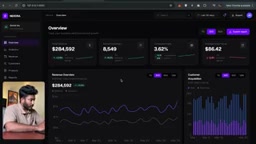
产出的应用名为 Netzora,采用深色界面,带有可交互的图表——鼠标悬停时能显示具体数据。不过这一版只完整实现了首页,Analytics、Revenue 等标签页尚未落地,但界面已提供导出 CSV 报表的功能。
Plan Mode 是 Cursor 提供的一种两阶段工作流:模型先输出结构化的执行计划(列出将要创建/修改的文件、依赖项及函数签名),用户确认后再进入实际代码生成阶段。这与直接让模型一次性写代码的方式不同——先规划再执行可以减少"写到一半发现方向错误"的情况,也便于开发者在高成本的生成步骤开始前发现需求偏差。Ask Mode 则是另一种模式,模型只回答问题、解释代码,不对文件做任何修改,适合在不改动代码库的前提下快速查询或做代码审查。两种模式搭配使用,可以将 AI 的介入程度按需分级,既控制成本,也降低误操作风险。
迭代与多轮对话能力
作者随后给出第二个提示词,要求实现 Analytics 分析标签页,并把配色改为柔和的薄荷绿(pastel green)。模型成功完成了颜色切换,并为分析页生成了相应的 mockup。
真正考验模型理解力的是后续测试:作者新开一个对话,要求为未来的后端接口编写一个 api.js 文件,并把所有后端路由按当前页面结构配置好。
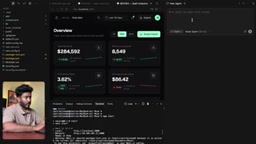
在没有延续上一轮上下文的情况下,Spark 依然理解了需求,生成了放置在合适目录下的 api.js。作者指出,这样的结构设计意味着将来接入真实后端时,只需替换和补充相应内容即可直接工作。
Ask Mode 下的问答表现
作者还切换到 Ask Mode 对代码进行提问。第一个问题是询问项目使用的图标包,模型快速准确地回答是 Lucide React。
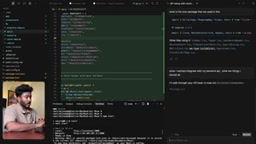
第二个问题更复杂:集成后端 API 时需要注意哪些事项。模型围绕 api.js 给出了相当完整的回答,包括设置 base URL、配置 endpoints、处理 headers 和认证(auth)等,基本覆盖了后端对接的关键环节。
结论:小任务的高性价比之选
从这次实测看,MetaMuse Spark 1.3 在 UI 生成方面表现突出——界面美观、图表效果到位,规划和生成速度都快于 Claude。它在多轮对话和跨对话理解上也展现了不错的连贯性。
作者给出的定位相当务实:对于严肃的大型项目,仍可依赖更强的旗舰模型;但处理一些体量不大的任务时,Spark 完全够用,且能省下不小的成本。 这正是它的价值所在——用更低的价格覆盖大部分日常开发需求。
需要提醒的是,本文结论基于单一来源的演示测试,样本有限,模型在复杂业务逻辑、大型代码库维护等场景下的能力仍有待更系统的验证。
相关推荐

农业革命另一面:疾病如何帮农民击败狩猎采集者
历史学者Kyle Harper解读农业社会如何击败狩猎采集者:不仅靠单位土地能量提取效率带来的人口增长优势,还依靠定居生活催生的病原体在扩张中造成额外死亡率,形成双重替代机制。

渐进式披露让Agent提速2.3倍:上下文工程新思路
Hacker News讨论提出用渐进式披露优化AI Agent上下文,实现2.3倍提速。本文解析上下文膨胀的三大性能损耗,介绍分层工具目录、按需检索、历史压缩等实践路径及落地注意事项。
Perplexity Computer 登陆 Mac:本地运行模型与智能体
Perplexity Computer 登陆 Mac:本地运行模型与智能体
Perplexity Computer 现可在 Mac 上完全本地运行,模型与智能体均在设备端执行,支持原生 Mac 应用和本地文件,敏感数据无需上传云端,已在 Perplexity Mac 应用上线。