Cursor硬核代码审查Skill实测:能挡住AI烂代码吗?

实测Cursor硬核代码审查Skill:七条发现五条靠谱,误报可忍、漏报最危险。
文章记录了开发者Matt Pocock对Cursor"硬核级代码质量审查"Skill的实测。该Skill仅一个skill.md,却要求审查者跳出diff、在全代码库寻找"代码柔道"式简化机会,并设定文件行数、类型边界、嵌套判断等硬性标准。Matt用Sandcastle项目最近五个PR实测,七条发现中五条靠谱,涵盖文件膨胀、特例判断散落三层、吞掉错误等问题,另有一条属误报。他指出Skill的主要短板是指令重复过多导致Agent难辨优先级,且完全忽视测试、CI与改进反馈回路。核心结论是:误报易处理,漏报才危险;好的审查Skill应野心大而指令瘦,而非规则堆砌。
AI写代码越来越快,但产出的代码质量参差不齐。自动代码审查被很多人视为提升Agent产出质量最有效的抓手,可真正落地一个可复用的审查Skill并不容易。GitHub上有个review skill仓库已经攒了10.9万星,却仍标着"开发中"——说明这事没那么简单。知名开发者Matt Pocock(B站有中文配音版)最近做了一次实测:把Cursor的"硬核级代码质量审查"Skill拉到本地,用自己的真实项目跑了一遍,看看它到底能审出什么。
这个Skill到底在要求什么
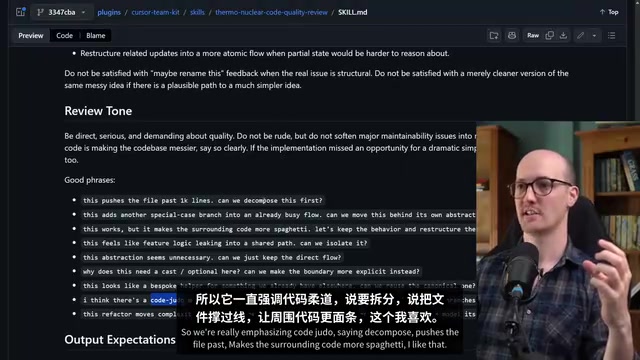
整个Skill只有一个skill.md文件,但里面的措辞相当激进。它要求审查者"有野心",全程寻找"代码柔道"的机会——也就是用四两拨千斤的方式简化实现。开篇基调就很明确:深度审计当前分支改动的代码质量,重新思考改动该如何实现,在不改变行为的前提下真正提升质量,改进抽象与模块化,减少面条代码。
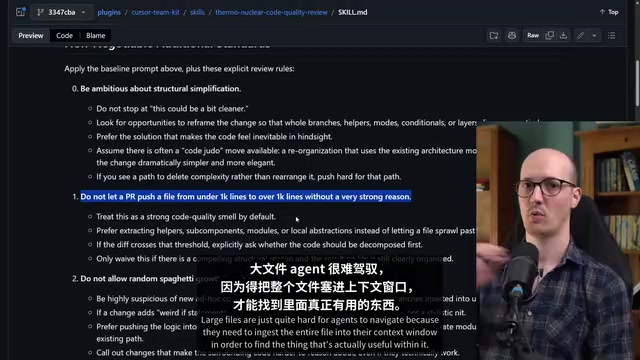
最值得注意的一条是:它不把diff当作活动范围。通常给Agent一个diff,它就在diff里打转;这个提示词却要求从改动出发,在整个代码库里找改进机会。配套的硬性标准包括:别让PR把文件从1000行以内撑到1000行以外(除非理由充分)、别让现有代码随便长出面条代码、把嵌套if和怪条件判断当设计问题而非风格小毛病、逻辑优先抽成专用抽象或独立模块。
Matt对"1000行"这条很有共鸣。他自己的经验是超过5000 token就拆文件——大文件Agent很难驾驭,因为得把整个文件塞进上下文窗口才能找到真正有用的部分;拆成多个文件后,文件名本身就是上下文指针,效率高得多。
代码柔道(Code Judo) 是这次审查Skill反复强调的核心方法论,它并非编程领域的标准术语,而是一种比喻性表达。其含义是:不靠堆砌代码或打补丁来解决问题,而是找到阻力最小的路径,用四两拨千斤的方式消解复杂度。具体表现为识别重复模式后抽取泛型函数、把散落的特例判断收进类型系统、用更少的抽象层数表达同等逻辑。与之相对的是"面条代码"——控制流像面条一样缠绕、难以追踪执行路径的实现。代码柔道要求审查者不满足于"能跑就行",而是追问"这段逻辑本来能不能更短、更直"。
文中提到的上下文窗口(context window) 是理解"大文件为什么难驾驭"的关键。LLM每次推理只能处理有限数量的token,这个上限就是上下文窗口。当Agent要修改一个上千行的文件时,它必须把整个文件读入窗口才能定位相关片段,这会挤占本可用于推理和其他文件的预算,也容易在长文本中丢失细节。把大文件拆成多个小文件后,Agent只需按文件名判断该读哪个,文件名本身成了低成本的检索线索,这正是Matt主张超过5000 token就拆文件的底层原因。
让Matt点头和皱眉的地方
类型与边界这条他挺喜欢。Skill要求对多余的可选参数、unknown/any乱转类型严格把关。Matt说Agent给React组件加prop时总爱加成可选的,哪怕一直是必填的也要图个"向后兼容",这每次都让他抓狂。
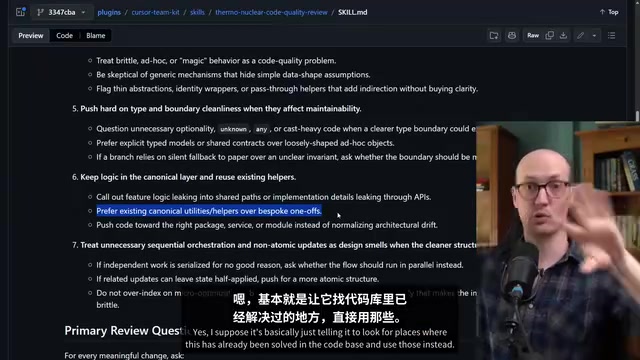
输出排序他也认可:按重要性排列结果,结构性质量退化放最上面,可读性可维护性放最下面,还要求给出批准或拒绝的明确结论。
但问题同样明显:重复太多。"要有野心""代码柔道""拆分大文件""类型边界"这些概念在文中反复出现,Matt担心指令太多太杂,Agent很难判断优先级——"对Agent就是一大坨烂泥"。另外,Skill完全没提测试、没提CI,也没提如何建立改进反馈回路,而这恰恰是代码库长期健康的关键。
可辨识联合(discriminated union) 是TypeScript中的一种类型建模手法:给联合类型的每个成员加一个字面量字段(如kind: 'issue' | 'custom'),编译器便能据此收窄类型、穷尽检查所有分支。审查Skill建议用它替换unknown/any乱转的写法,本质是把运行时的隐式约定搬到类型系统里,让非法状态无法被构造。与之配套的"可选项泛滥"问题则相反:把本应必填的prop标成可选,编译器就不再替调用方把关,错误被推迟到运行时才暴露。
拿真实项目开刀:七条发现,五条靠谱
Matt用自己正在开发的Sandcastle项目实测,让Skill审查最近合入main的五个PR。结果如下:
- init service膨胀到超1000行,混杂多种职责,Skill给出了不错的拆分方案,还想加一个小型泛型函数一次性删掉约20行重复样板代码。
- issue tracker的特例判断散落在三层,建议用代码柔道把自定义tracker的差异收进类型里。Matt对这一块代码很熟,评价是"两条都对"。
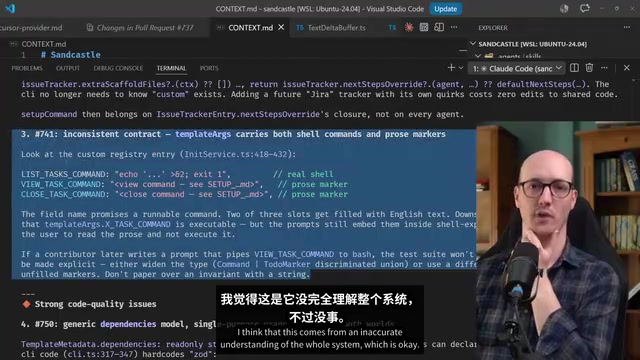
- template args类型不一致,建议改成可辨识联合或独立字段。Matt认为这是误报——对方没完全理解系统,但这类误报哪个审查提示词都免不了。
- 吞掉的错误:execSync包在吞错误的调用里,失败就直接返回false。这正是他希望审查者盯住的东西。
- 大文件只拆了一半、两个提示词里有一字不差的重复改动——后者Matt不完全认同,他认为提示词就该各改各的。
七条里五条靠谱。还有一个耐人寻味的结论:按这个Skill的审批标准,最近有三个实质性PR本不该合进去——行为都对,但代码库比一周前乱了不少。
误报不是问题,漏报才是
Matt的核心判断是:让审查"超有野心"、多提结构性方案,误报必然增多,但误报很好处理,真正危险的是漏报——那些你从没看见的改进机会,你永远不会知道自己错过了什么。
他的改进方向也很具体:精简重复内容,让指令更DRY;增加对测试和CI的关注;借鉴他自己架构Skill里对代码库sims(相似模式一致性)的重视。总体结论是这个Skill值得拉下来试试。
对想给Agent加一道质量防线的团队来说,这次实测的价值在于:一个好的审查Skill不是把规则堆得越多越好,而是给Agent一套清晰的"好坏"语言和足够大的施展空间——野心要大,但指令要瘦。
误报(false positive)与漏报(false negative) 借自检测领域的术语。在代码审查语境下,误报指审查者提出的、实际并不成立或不值得改的建议;漏报指真实存在的质量问题未被指出。二者存在此消彼长的权衡:审查标准越激进、越鼓励提出结构性重构,误报率越高。Matt的判断建立在成本不对称之上——误报只需人工花几秒驳回,代价可忽略;漏报则意味着问题永久潜伏,团队甚至不知道自己失去了什么改进机会。因此他倾向把阈值调向"宁可多报",再通过精简指令、补充测试与CI关注点来压低误报的噪音。
相关推荐

iPhone Duo续航实测:一天一充跑不掉,大屏是耗电元凶
iPhone Duo续航实测:重度使用一天需至少充电一次,6.5小时亮屏约剩30%电量。大屏展开频率是耗电关键,MagSafe电池背夹可救场,长期衰减同样值得关注。

Kimi K3.1 Pro开源发布:2.8万亿参数逼近Opus
Moonshot发布开源MoE模型Kimi K3.1 Pro,2.8万亿总参数、1040亿激活参数,Terminal Bench 4.0仅落后Opus 5.5不到1分,单任务成本约三分之一,API价格减半,开源权重11月4日开放。

Costco科技产品价格竞猜:显示器、键鼠、Bose音响值不值?
YouTube博主在Costco竞猜科技产品价格:2K 180Hz显示器、罗技键鼠、Bose音响和CyberPower UPS实测估价,揭示仓储会员店的选品定价逻辑与品牌溢价真相。