大厂AI工程化面试:前端监控到Agent全链路可观测性

从浏览器性能监控到AI Agent优化,再到全链路可观测性的三层递进体系。
文章围绕前端AI岗位面试,拆解了从浏览器到AI链路的监控体系。第一层是前端监控底座:采集层用PerformanceObserver收集LCP、INP、CLS等指标,异常捕获依赖onerror与unhandledrejection两个入口,传输层需处理批量合并、失败重试与trace ID贯穿。第二层是AI Agent优化,分效果、成本、稳定性三个维度:RAG链路每个环节均可优化,上下文摘要压缩可将747 token压至约280 token,多智能体协作有串行、并行、辩论三种形态,并延伸出Agentic RAG与Graph RAG。第三层是全链路可观测性,需将各层能力指标化,融合Sentry式异常聚类与LangSmith式模型调用分析,形成监控、聚类、溯源、修复的运维闭环。
面试前端岗位时,性能优化和异常监控是经典问题。但当岗位变成"前端AI"或"AI全栈",考察范围就从浏览器扩展到了整条AI链路——从用户输入提示词,到Agent内部每个节点、每次工具调用,再到最终输出,全部都需要被监控。本文围绕三个递进层次的问题,拆解这条监控体系如何从概念落到代码。
第一层:前端监控体系的底座
性能指标怎么采
前端监控的骨架分三层:采集层通过SDK收集性能、异常、资源和埋点数据;传输层做批量合并与队列上报;存储层落到ClickHouse这类列式数据库,最终在告警层以实时看板呈现。
核心性能指标包括LCP(最大内容绘制)、INP(交互到下一次绘制的延迟)、CLS(累计布局偏移)。以CLS为例,图片初始占位100像素、加载后撑到300像素,这200像素的布局跳动就是偏移量的来源。除核心指标外,FP、FCP、FMP、TTFB、TTI等自定义指标因团队而异。
采集依赖浏览器提供的 PerformanceObserver API。订阅对应entry类型后,回调中即可拿到 startTime 等数值,Web Vitals库则封装了常见指标的采集逻辑。
Web Vitals 是 Google 提出的核心网页健康度量标准,LCP、INP、CLS 就是其中的三个 Core Web Vitals。它们之所以重要,是因为直接关联用户感知的加载速度、交互流畅度和视觉稳定性,也会影响搜索排名。Web Vitals 库通过 PerformanceObserver 自动订阅 largest-contentful-paint、layout-shift、event 等 entry 类型,并对指标做归一化处理,解决了各浏览器实现差异的问题。INP 是 2024 年才正式取代 FID 成为核心指标,它衡量的是从用户交互到页面下一次绘制之间的延迟,能更全面地反映交互响应性。
异常捕获的两个关键入口
JS执行异常靠 window.onerror 监听,同步错误一网打尽;异步任务(如 Promise.reject)抛出的拒绝则需 unhandledrejection 事件单独捕获,两者缺一不可。资源加载异常、接口请求异常需要自行封装fetch做上报改造,白屏检测则可通过顶层节点是否在限定时间内出现来判定,严格场景下用 MutationObserver 观察DOM变化更可靠。
业务埋点覆盖曝光、点击、转化三个场景,PV/UV、转化漏斗、留存是通用指标体系。有意思的是,电商产品对购物车的不同处理——有的弱化购物车、有的强化收藏——背后正是埋点数据分析驱动的产品决策。
传输层的工程细节
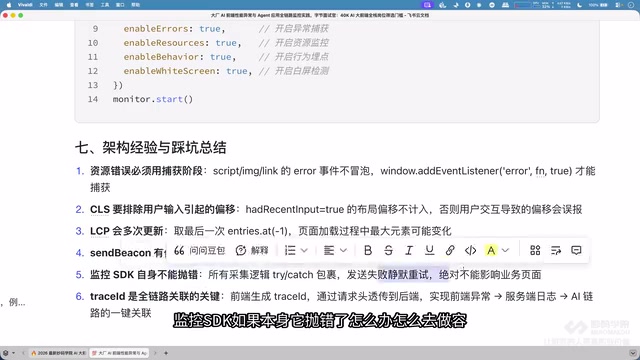
SDK采集的数据进入上传队列后,需要处理批量合并、失败重试、体积限制、SDK自身抛错的容错降级,以及trace ID如何贯穿全链路。这些细节才是面试中能体现架构经验的部分。
第二层:AI Agent的优化维度
Agent优化的讨论可以拆成效果、成本、稳定性三个层面。RAG链路是绕不开的样本:文档加载(含多模态处理)→分片→向量化→存储→相似度检索→重排→拼接生成。每个环节都是优化点——向量数据库选pgvector还是Milvus,混合检索用全文加向量如何配比,重排用交叉编码器还是双编码器,都直接影响最终质量。
上下文工程:压缩比想象中直接
提示词越写越长,模型反而记不住关键信息,还会推高token成本。上下文工程的核心手段之一是对话摘要压缩:把临近窗口上限的对话交给模型,要求它保留事实、目标、约束和待办事项。实测一段747 token的内容压缩后约280 token,压缩率超过26%,关键信息基本无损。
滑动窗口保留最近N轮对话是更暴力的方案,代价是可能丢掉早期关键信息,因此摘要压缩通常更受青睐。
多智能体协作的三种形态
串行(Serial)、并行(Parallel)、辩论(Debate)是多智能体协作的基础模式,Supervisor主智能体模式则常见于复杂任务编排。比如"一句话生成设计图、再一键生成代码"的场景,就是主智能体统领若干子智能体并行完成导航栏、内容区、品牌故事等模块设计。
RAG的进阶形态同样值得关注:Agentic RAG让检索过程具备自主决策能力,Graph RAG用图结构替代线性链,把复杂业务流程抽象成节点与分支,检索增强的结果更贴合预期。
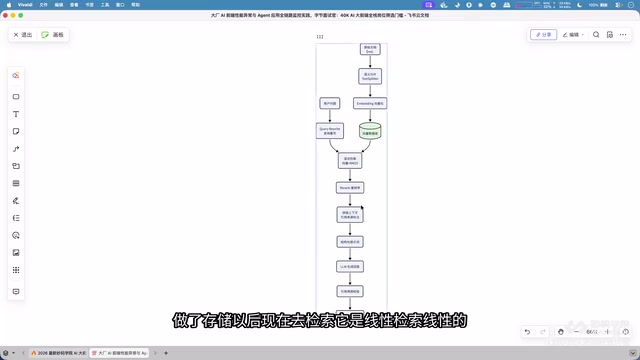
Agentic RAG 与传统 RAG 的关键区别在于检索过程引入了自主决策:模型会判断是否需要检索、检索什么、是否要多次检索、何时停止,而不是固定按“一次检索→生成”的流程执行。Graph RAG 则把知识组织成实体与关系的图结构,检索时沿着图遍历,能回答需要多跳推理的问题,比如“A 公司的 CEO 毕业于哪所大学”。两者都提升了复杂场景的准确性,但代价是更高的延迟与成本,因此需要结合业务场景做取舍。
第三层:全站AI全链路可观测性
指标化是关键动作
前面讲的前端、服务端、AI层优化,落到监控体系时都要转为可度量的指标。缓存看命中率与雪崩预警,高可用看分布式集群的健康度,流量削峰看消息队列(Kafka或RabbitMQ)的承压表现。
AI层需要采集的指标更细:链路调用中从提示词到响应的时延、token消耗、错误率(限流、超时分类记录)、模型版本;RAG全链路要记录检索耗时、召回数量与Top-K、重排前后的顺序与得分变化、回答中实际引用的片段命中率;成本侧则要按模型、用户、任务三个维度拆分token消耗,并设置预算告警。
对标LangSmith与Sentry
完整的可观测体系需要融合两类能力:Sentry式的异常聚类、Source Map还原、Issue与Release追踪;LangSmith式的模型调用分析、全链路token统计、提示词版本管理与在线编辑、数据集评测与执行回放。两者拼合,才构成从监控采集、故障聚类到智能溯源、AI诊断、修复迭代的运维闭环。
工程实现上,标准化模板通常分层为API层(Controller)、服务层(Services)与Web层,业务按Apps、Services、Packages、Infrastructure组织。基础设施用Docker Compose统一编排Kafka、ClickHouse、向量数据库、API服务与Web前端,一条命令拉起全部服务,一条命令整体关闭。
LangSmith 是 LangChain 团队推出的 LLM 应用可观测与评测平台,核心能力包括追踪每次模型调用的输入输出与耗时、管理提示词版本、构建评测数据集并做回归测试。Sentry 则是经典的前端异常监控平台,强项是错误聚类、Source Map 还原堆栈、按 Release 追踪问题。两者面向的链路阶段不同,前者关注 LLM 调用的质量与成本,后者关注代码层异常,融合后才能覆盖从代码错误到模型输出异常的全栈问题。
面试中真正值钱的表达
把上述内容串成一句话,就是面试时的差异化表达:主导过从监控采集、异常聚类到智能溯源的完整运维闭环设计,覆盖前端性能、异常、埋点,服务端缓存与削峰,以及AI层的token与RAG全链路指标。
只会说"我会用AI工具写前端",和能讲清整条链路的架构取舍,在面试官耳中是完全不同的量级。AI降低了编码成本,但架构思维、链路理解、指标设计这些能力,恰恰是指挥AI干活的前提——同一个项目,不同的人让AI实现,产出的风险值天差地别。
相关推荐
一人量产90集AI漫剧:10小时10块钱的完整制作流程
没有编剧经验也能做AI漫剧:10小时10块钱成本,红果平台单部收益4200元。本文拆解从AI生成剧本、分镜脚本到成片的六步完整流程,附万能提问公式和新手避坑指南。
豆包Agent自制报价测算器:接单报价告别凭感觉
B站UP主用豆包Agent零代码自制报价测算器,输入项目类型、数量、周期即可自动生成报价明细,支持加急与版权买断费率,一键复制发客户,手机端也能随时报价。
WorkBuddy实战教程:10个Agent项目从入门到简历级
WorkBuddy 实战教程解析:用中文交代任务的 AI 工作助手,配置环境比 Codex、Claude Code 更简单。10 个 Agent 实战项目覆盖文件整理、表格汇整、网页生成,新手三步上手,学完可写进简历。