大模型本地部署实战:Ollama、vLLM与量化方案全解析

梳理Ollama/vLLM/LM Studio三大工具定位,并以Qwen3 27B为例详解量化方案与显存需求。
本文聚焦大模型本地化部署的两个核心决策:工具选型与硬件规划。在工具层面,Ollama适合个人轻量实验,vLLM面向企业生产高并发,LM Studio服务非技术用户;三者在性能、复杂度和开源属性上各有取舍。在硬件层面,以通义千问Qwen3 27B为例,BF16原厂模型权重约50GB、加KV Cache峰值约56GB,需80GB级专业显卡;通过FP8量化可将需求压至26-29GB,INT4量化后消费级4090即可运行。文章建议生产环境坚守BF16保证精度,测试环境可用INT4,并以INT4为最低精度底线,从而在成本与模型能力之间找到合理平衡。
大模型本地化部署已经成为企业和个人开发者绕不开的技术话题。无论是出于数据安全、成本控制还是定制化需求,掌握主流部署工具及其对应的硬件规划,都是落地大模型应用的前提。本文结合实际部署经验,梳理三大常用部署工具的适用场景,并以通义千问 Qwen3 系列为例,详解不同量化方案对显存的实际需求。
三大本地部署工具的定位与取舍
当前大模型本地部署领域,有三款工具最为常见,它们各自面向不同的使用群体。
Ollama 名气最大,是一种轻量级部署工具,上手简单,适合个人开发者做本地测试或实验性项目。对于想在自己电脑上快速跑通一个模型的人来说,Ollama 几乎是零门槛的首选。
vLLM 则是生产级的大模型推理框架,专为企业级高并发环境设计。如果你需要在生产环境中稳定对外提供推理服务,vLLM 是更合理的选择。但它的代价是复杂度最高、硬件要求也最高——必须配备 GPU 卡才能运行,换来的回报是三者中最强的推理性能。
LM Studio 走的是图形化路线,提供可视化界面来部署和管理大模型,特别适合非技术背景的用户。不过对于专业 IT 人员而言,个人测试用 Ollama、生产部署用 vLLM 已经足够,LM Studio 的使用场景相对有限。此外需要注意,LM Studio 属于闭源工具,而 Ollama 和 vLLM 都是开源方案,这在企业选型时也是一个需要权衡的因素。
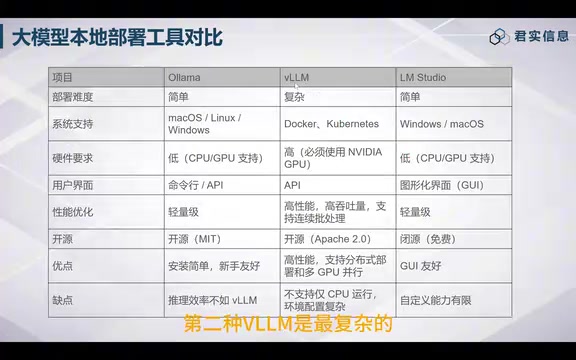
简单总结选型逻辑:个人实验选 Ollama,企业生产选 vLLM,非技术用户或快速演示可考虑 LM Studio。
vLLM 的核心竞争力来自其 PagedAttention 技术——借鉴操作系统虚拟内存的分页思想,将 KV Cache 切分为固定大小的块进行动态管理,大幅减少显存碎片,使 GPU 利用率和吞吐量显著高于传统推理框架。Ollama 底层实际调用的是 llama.cpp,以 CPU/GPU 混合推理见长,在没有独立 GPU 的 Mac 或普通 PC 上也能运行,但并发能力有限,不适合多用户同时访问的生产场景。理解这一底层差异,有助于解释为何两者在性能和硬件要求上差距如此悬殊。
以 Qwen3.8 为例:原厂模型的参数规模与硬件门槛
在实际本地化部署中,通常会选择最新版的大模型。通义千问广告 Qwen3.8 系列提供了多个原厂模型版本,覆盖从旗舰到轻量的不同规模。
- Qwen3.8 Max:参数量高达 2.4 万亿,大约是 DeepSeek广告 671B 的 4 倍。671B 模型本身就需要约 10 张 H100 显卡,Max 版本按 4 倍推算则需要约 40 张 H100——这个规模已经远超绝大多数企业的承受范围。
- 27B Flash(125B):参数量约为 27B 的 5 倍。如果 27B 需要一张 Pro 6000 显卡,那么它大约需要 5 张。按一张 Pro 6000 约 10 万元计算,5 张就是约 50 万元的硬件投入,对多数企业来说仍有不小压力。
- 27B:这是生产端本地化部署中使用最多的版本,基本上一张 Pro 6000 显卡即可胜任,性价比和落地难度都比较友好。

此外还有 3.8 Flash、3.8 Live Translate(实时同传模型)等专用版本,以及社区提供的各种量化版。社区量化版正是让 27B 这类模型能在更低硬件配置上跑起来的关键,下面重点展开。
Qwen3 是阿里云推出的第三代通义千问大模型系列,于 2025 年发布,主打混合专家架构(MoE)与稠密模型两条产品线并行。其中 Max 版本采用 MoE 架构,总参数量(2.4T)虽然巨大,但每次推理实际激活的参数只占一小部分,这也是 MoE 模型"参数多但推理成本相对可控"的核心逻辑——不过激活参数所需的显存仍远超单张消费级显卡。27B 稠密版本则是每次推理都使用全部 270 亿参数,结构更简单,工程部署门槛更低,因而成为企业本地化落地的主流选择。
27B 模型的量化方案与显存实测
要理解量化的价值,先得算清楚原始模型到底占多少显存。以 Qwen3.8 的 27B 模型为例,它的原始量化精度是 BF16,即每个参数占 2 字节。
权重所需显存的粗略计算:27B 参数 × 2 字节 ≈ 50.23 GB。再加上 KV Cache 等额外开销,实际峰值显存需求大约会达到 56 GB。

按这个需求,BF16 原厂模型需要以下级别的显卡才能承载:
- A100 / H100(80GB 显存)
- Pro 6000(96GB)
- 6000D(84GB)
- Pro 5500(84GB)
这几款显卡都能满足 27B 原厂模型的部署需求。
FP8 及更低精度量化方案
如果采用更激进的量化策略,显存需求会大幅下降,对应的硬件门槛也随之降低:
| 量化方案 | 显存需求 | 推荐显卡 |
|---|---|---|
| BF16(原厂) | ~56GB | A100/H100/Pro 6000 |
| FP8 | 26–29GB | Pro 5000 Blackwell |
| INT4(Q4_K_M) | 更低 | 5000D / 4090 |
| INT3 | 更低 | 4080 |
| INT2 | 最低 | RTX 3060 / 4070 |
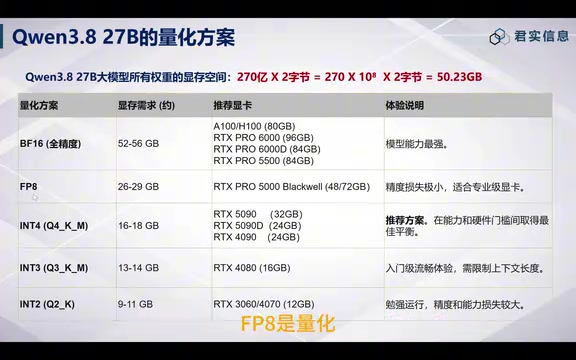
可以看到,从 BF16 到 FP8,显存需求几乎砍半,一张 Pro 5000 Blackwell 就能搞定;而 INT4 量化后,消费级的 4090 甚至 5000D 都能跑起来。
量化精度的实践建议
量化并非免费的午餐——精度越低,模型的能力和输出质量损失越大。基于实际经验给出几条建议:
- 生产环境:优先使用 BF16,保证模型精度和能力完整。
- 测试环境:可以使用 INT4 做验证,在精度和资源之间取得平衡。
- 底线:不要低于 INT4。INT3、INT2 虽然能在低端显卡上运行,但精度和能力损失明显,仅适合极端资源受限的演示场景。
量化(Quantization) 是指将模型权重从高精度浮点数压缩为低比特整数表示的过程。BF16(Brain Float 16)每个参数占 2 字节,FP8 占 1 字节,INT4 仅占 0.5 字节,INT2 则只有 0.25 字节——因此从 BF16 到 INT4,理论上权重体积可压缩至原来的 1/4。Q4_K_M 是 llama.cpp 生态中一种混合量化格式:对模型中对精度更敏感的层保留较高精度,其余层使用 4-bit,在压缩率与质量之间取得平衡,是目前社区最常见的量化发布格式之一。KV Cache 是推理时存储注意力机制中键值对的缓存区域,其大小随上下文长度和并发数增长,这也是实际显存峰值高于纯权重估算的主要原因。
结语
大模型本地部署的核心,是在工具选型、模型规模和量化精度三者之间找到平衡。个人开发用 Ollama 配合量化版小模型即可低成本起步;企业生产则需要 vLLM 加上足够的 GPU 资源,并根据预算在原厂 BF16 与 FP8/INT4 量化之间做出取舍。理解清楚显存计算逻辑,就能在采购显卡前做出更精准的成本预估,避免资源浪费或性能不足。
相关推荐

Opus 5.5实测:一个Skill把PDF变成交互式动画电子书
开发者基于 Claude Opus 5.5 打造开源 Skill「Papermorph」,通过 PDF→规划→分镜→旁白→动画测验的流水线,把静态 PDF 自动转化为带交互测验的动画网页电子书,且暂未使用图像模型。本文拆解其工作流与技术亮点。

Perplexity押注垂直整合:Vera芯片替代x86背后的Agent基建野心
Perplexity宣布垂直整合其智能体基础设施,自建沙箱并押注Vera架构替代x86,开始部署Perplexity Computer。本文解析这一战略背后的技术逻辑与行业意义。

Extra Big Ass Intelligence:一场对AI炒作的幽默反讽
Extra Big Ass Intelligence是一个在Hacker News走红的恶搞项目,用幽默反讽调侃AI行业的过度炒作与命名通胀,引发技术社区对AI营销泡沫的集体反思。