#大模型推理
共 52 篇相关文章
两台DGX Station跑GLM-5.3:vLLM张量并行实战
NVIDIA工程师演示如何用两台DGX Station和vLLM张量并行在本地运行7530亿参数的GLM-5.3,涵盖RDMA网络配置、启动参数、NCCL验证与性能基线。
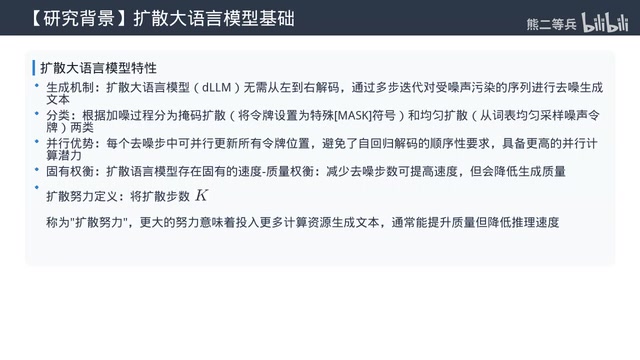
推测扩散双权衡框架:解锁大模型推理帕累托最优
深度解析Speculative Diffusion双权衡框架:扩散语言模型与推测解码结合,通过联合优化扩散努力与接受宽容度,扩展大模型推理速度-质量帕累托前沿,含理论证明与实验发现。

无需训练:LongCapHarness 如何激发大模型长上下文推理潜能
LongCapHarness 提出一种无需数据合成和模型后训练的长上下文推理增强框架,通过递归自我改进驾驭模型潜在能力,在 HELMET 和 RULER 基准上显著优于数据合成基线,开发成本不到 NExtLong 和 PolicyLong 的一半。

Q64:冻结大模型主干,联合适配读出网络提效
Q64 候选打分系统冻结 64 层 Qwen3.8-27B 主干,复用混合前缀状态,联合训练残差适配器与四层解码器读出网络。四基准宏准确率从 66.46% 升至 74.32%,仍低于原生基线 75.68%;合成负载中位冷请求延迟 2.237 秒,原生基线 5.383 秒。
 科技前沿
Llama-modchip:无GPU跑284B DeepSeek大模型
Llama-modchip项目宣称在64GB内存、无GPU的硬件上运行284B参数的DeepSeek大模型,本文分析其技术思路、无GPU推理的价值与局限,以及对本地部署开发者的启示。

大模型推理瓶颈与KV Cache:核心机制与主流优化方案
从自注意力机制的重复计算出发,解析KV Cache如何缓存K、V矩阵加速大模型推理,并分析其显存碎片与重复存储挑战,对比vLLM、SGLang、LMDeploy的优化方案与选型建议。

KV Cache 泄漏事故:Cloudflare AI 串聊 155 次的技术真相
Cloudflare Workers AI 因 KV Cache 页面未清零与跨机器交接缺陷,导致 155 次用户对话串流泄露。本文拆解 KV Cache 原理、故障链条与三方修复方案,并给出开发者可复用的缓存安全启示。

ProVe解码:大模型当提案者,投机解码反着来
ProVe解码反转投机解码角色,让大模型当提案者一次预测token块,32B模型实现2.5倍吞吐且无需草稿头,小验证者下可达2.7倍但精度略降。

投机解码为何能加速大模型推理?
投机解码为什么能加速大模型推理?本文解析其先猜后验的并行验证机制,说明接受率、草稿模型选择与批量大小如何影响加速效果,并澄清输出无损的原理。

接受率≠加速:有损投机解码的"长度膨胀"陷阱
有损投机解码中,松弛验证虽将每轮接受token数提升至1.34倍,却使完成长度膨胀1.54倍,抵消加速收益。研究指出接受率不能单独衡量解码速度,需同时报告完成长度与验证轮数。

32GB笔记本跑80B大模型:纯C引擎把专家流式塞进SSD
纯C推理引擎Genus在32GB内存无显卡笔记本上跑80B大模型,靠MoE专家流式加载实现24 tokens/s,内置MCP服务器与OpenAI风格接口,可对接VS Code代码补全。

端侧大模型推理:规格表不会告诉你的真实取舍
端侧大模型推理远不只是"没网络的云"。本文深入剖析内存硬限制、量化精度权衡、冷启动延迟与无自动扩容四大取舍,并附一份可直接落地的工程检查清单。

LoopOPD:让循环语言模型自我蒸馏,实现递归自我提升
arXiv 新论文提出 LoopOPD 与动态版 D-LoopOPD,一种针对循环语言模型(LoopLMs)的跨循环在线策略蒸馏框架,让模型用自身更深的递归计算作为监督来源,实现递归自我提升。仅用数学数据训练即可泛化到通用推理与代码生成任务。

外部引导何时真正帮助大模型推理?GA-GRPO的偏差-方差理论
新论文提出GA-GRPO统一框架,用偏差-方差理论回答外部引导何时帮助大模型推理,给出最优引导权重闭式解与极小极大下界,并在Qwen2.5-Math-7B上验证性能持平或更优且节省31% GPU成本。

FluidPD:原地弹性调度破解LLM推理的P/D资源失衡难题
arXiv新论文FluidPD提出面向Prefill-Decode分离LLM服务的SLO感知原地弹性方案,通过FluidToken和FluidRole两大机制应对资源失衡,在Azure生产负载上SLO达成率最高提升94.6个百分点。
一台机器跑8并发:Qwen3本地部署多任务实测
B站UP主实测在一台英伟达设备上用懒猫微服AI平台跑Qwen3 Flash Next模型,实现8路并发多任务并行。本文解析本地部署方案的硬件选择、并发表现及企业应用场景。

12GB显存跑180B大模型?Strata引擎本地部署深度解析
Strata推理引擎如何让12GB显存的RTX 5070跑起180B参数的Qwen大模型?本文深度解析其MoE稀疏激活、四层存储调度、CPU-GPU协同与投机解码架构,并核查44.8 token/s与"快3倍"数据的可信度。

Strata神项目实测:12G显卡本地跑176B千问大模型
开源项目Strata通过GPU+CPU+内存+SSD三层存储整机协同,让12G显卡也能流畅跑176B的Qwen3.8 Flash Next大模型,短聊天速度达93 token/s。本文详解其核心技术、量化档位选择与部署方法。

32GB显卡本地跑大模型:AMD R9700 对决 Intel B70
海外博主实测 AMD Radeon AI Pro R9700 与 Intel Arc Pro B70 两张 32GB 显卡本地跑大模型的真实差异:密集模型 AMD 领先 60%,MoE 场景打平,软件生态是最大分水岭。附每 token 成本与选购建议。
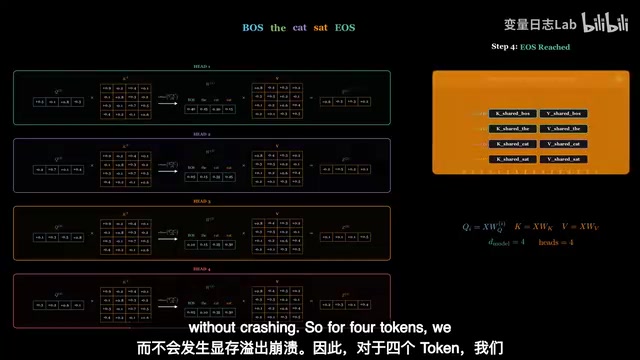
MQA与GQA详解:KV Cache如何降低大模型推理显存
深入解析 MQA 与 GQA 两种大模型推理优化技术:KV Cache 如何膨胀、MQA 如何通过共享键值削减 75% 显存、GQA 如何用组数 G 在速度与质量间取得平衡,以及它为何成为 LLaMA、Mistral 等主流模型的默认选择。