大模型对决中医师:真实临床案例评测揭示AI潜力与风险
大规模评测显示顶尖大模型在中医诊断推理上可媲美医师,但处方环节存在安全隐患,不宜独立使用。
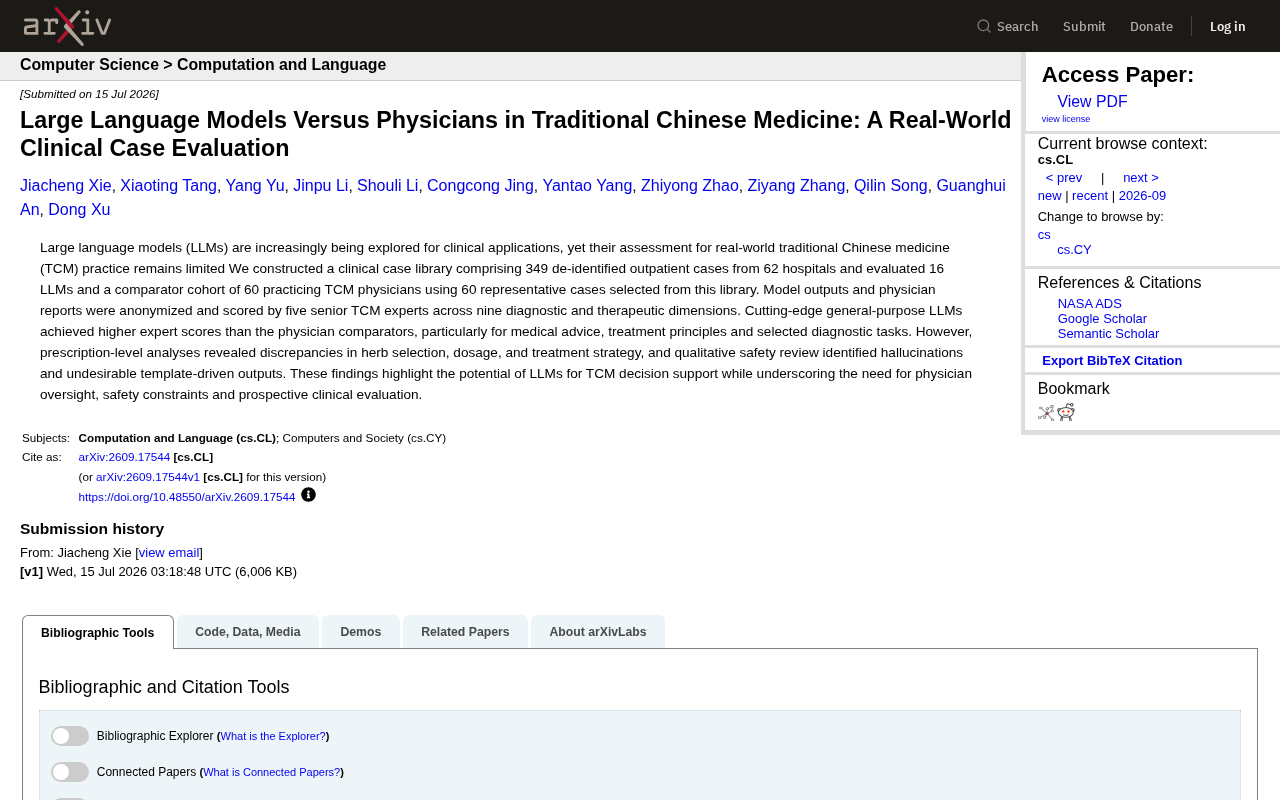
一项基于62家医院349份真实门诊病例的研究,对16个大语言模型与60位执业中医师进行了系统性对比评测。结果显示,顶尖通用大模型在医疗建议、治疗原则和部分诊断任务上的专家评分高于医师对照组,体现了其在知识整合与条理化表达方面的优势。然而,在处方开具这一临床核心环节,模型在药材选择、剂量把控和治疗策略上与专家判断存在明显偏差,同时还暴露出幻觉生成和模板化输出两类安全隐患。研究团队据此建议,大模型应定位为决策支持辅助工具,必须配合医师监督、安全约束和前瞻性临床评估方可应用于实际诊疗场景。
大语言模型(LLM)正加速渗透医疗领域,但在传统中医(TCM)这一高度依赖辨证论治与经验积累的场景中,它们的真实表现如何,此前一直缺乏系统性验证。一项基于真实门诊病例的大规模评测研究给出了迄今为止较为详实的答案:在部分诊疗维度上,顶尖通用大模型的专家评分甚至超过了执业中医师,但在处方开具的关键环节,模型暴露出用药、剂量与治疗策略上的明显缺陷,安全风险不容忽视。
研究如何设计:349份真实病例的严苛检验
这项研究的价值首先在于其数据的真实性与规模。研究团队构建了一个临床病例库,涵盖来自62家医院的349份去标识化门诊病例,并从中筛选出60份具有代表性的病例作为评测集。
评测对象包括16个大语言模型,以及一个由60位执业中医师组成的对照组。为保证公平,模型输出与医师报告均经过匿名化处理,再交由五位资深中医专家从九个诊断与治疗维度进行打分。这种"双盲式"设计有效避免了评审者对AI或人类身份的先入为主,让评分更接近对诊疗质量本身的判断。
用真实临床病例而非标准化考题来评测大模型,是这项研究区别于许多基准测试的核心。中医诊疗涉及望闻问切的综合判断,病例的复杂性和个体差异远超题库式评估,这样的设计更能反映模型在实际应用中的能力边界。
结果一:顶尖大模型在部分维度胜过医师
研究最引人注目的结论是,前沿通用大模型在专家评分上高于医师对照组,尤其在医疗建议、治疗原则以及部分诊断任务上表现突出。
这一结果并不意味着AI已经全面超越中医师。更合理的解读是,大模型在信息整合、条理化表达和知识覆盖广度上具备天然优势。面对一份病例,模型能够快速调动海量文献中的诊疗原则,给出结构完整、逻辑清晰的分析,而这恰恰是评审专家看重的维度之一。
换个角度看,这也反映出通用大模型经过海量中医典籍与临床文本训练后,已经能够较好地掌握"辨证论治"的框架性知识。对于治疗原则的阐述、诊断思路的梳理,模型展现出了可用于决策支持的实力。
辨证论治是中医核心诊疗方法论,指通过四诊(望、闻、问、切)收集患者症状与体征,将其归纳为特定"证型"(如气虚血瘀、肝阳上亢),再依据证型确定治则与处方。这一过程高度依赖医师的主观经验判断,与西医依赖客观检测指标的诊断体系存在根本差异。大模型在这一环节表现相对较好,原因在于中医文献中存在大量"证型—治则"的结构化知识对应,模型可以通过模式匹配较为准确地重现这类推理链条。然而,真实门诊中患者往往呈现"证型兼夹"或"证型转化"等复杂情形,这类动态判断远超文本模式匹配的能力范围,是模型在处方细节上失准的根本原因之一。
结果二:处方环节暴露关键短板
真正拉开AI与人类医师差距的,是处方层面的细致分析。研究发现,模型在药材选择、剂量把控和治疗策略上与专家判断存在明显偏差。
中医处方是辨证论治的最终落点,君臣佐使的配伍、剂量的精确拿捏,往往依赖医师多年的临床经验和对患者个体状态的动态把握。大模型虽然能给出看似合理的方剂,但在具体到某味药是否该用、用多少的问题上,缺乏真实临床所要求的精准与谨慎。
更值得警惕的是定性安全审查发现的两类问题:一是幻觉(hallucination),即模型生成了看似专业实则错误或虚构的内容;二是模板化输出,模型倾向于套用固定框架,缺乏针对具体病例的个性化调整。在医疗场景下,这两类问题都可能带来直接的用药安全风险。
中医处方配伍中的"君臣佐使"理论是理解这一缺陷的关键背景。君药是针对主病或主证起主要治疗作用的药物,臣药辅助加强君药效力,佐药协助治疗兼证或制约君臣药的毒性,使药则引经报使或调和诸药。这套体系要求医师在整体辨证基础上,对每味药的地位、用量比例和配伍禁忌进行动态权衡。大模型在生成处方时,往往能复现"某证用某方"的知识映射,但无法真正理解配伍背后的动态平衡逻辑——比如附子的炮制程度与剂量直接影响毒性,细辛的用量自古有"不过钱"之说,这类临床经验性约束很难从文本训练中被可靠地内化。幻觉问题在此处尤为危险,因为错误的药材搭配或剂量不仅无效,还可能对患者造成实质性伤害。
对中医AI应用的启示
这项研究给出的判断相对审慎:大模型在中医决策支持中具备真实潜力,但绝不能脱离医师监督独立使用。
研究团队明确强调了三点必要条件:医师监督(physician oversight)、安全约束(safety constraints)以及前瞻性临床评估(prospective clinical evaluation)。这意味着大模型更适合定位为辅助工具——帮助医师梳理诊断思路、提供治疗原则参考,而处方决策和用药安全仍需由人类专家把关。
从产业视角看,这一结论为中医AI产品的落地路径提供了清晰指引。追求"AI替代医师"既不现实也不安全,真正有价值的方向是构建人机协同的诊疗辅助系统,让模型在其擅长的知识整合与思路提示环节发力,同时通过安全机制约束其在处方等高风险环节的自由发挥。
结语
这项覆盖62家医院、349份真实病例的评测,为大模型在传统中医领域的能力画出了一幅相对完整的图景:知识广度和条理化表达上可圈可点,但临床落地所需的精准性与安全性仍有明显欠缺。对于正在探索中医智能化的开发者与机构而言,这既是一剂强心针,也是一记警钟——AI能做得很好的地方要用足,做不好的地方更要设防。
相关推荐
冰岛Treble获1800万美元融资,押注语音仿真平台
冰岛语音仿真公司Treble完成1800万美元融资,其平台服务于语音AI模型开发者、AI可穿戴设备及机器人公司。本文解析语音仿真技术价值与融资背后的行业信号。
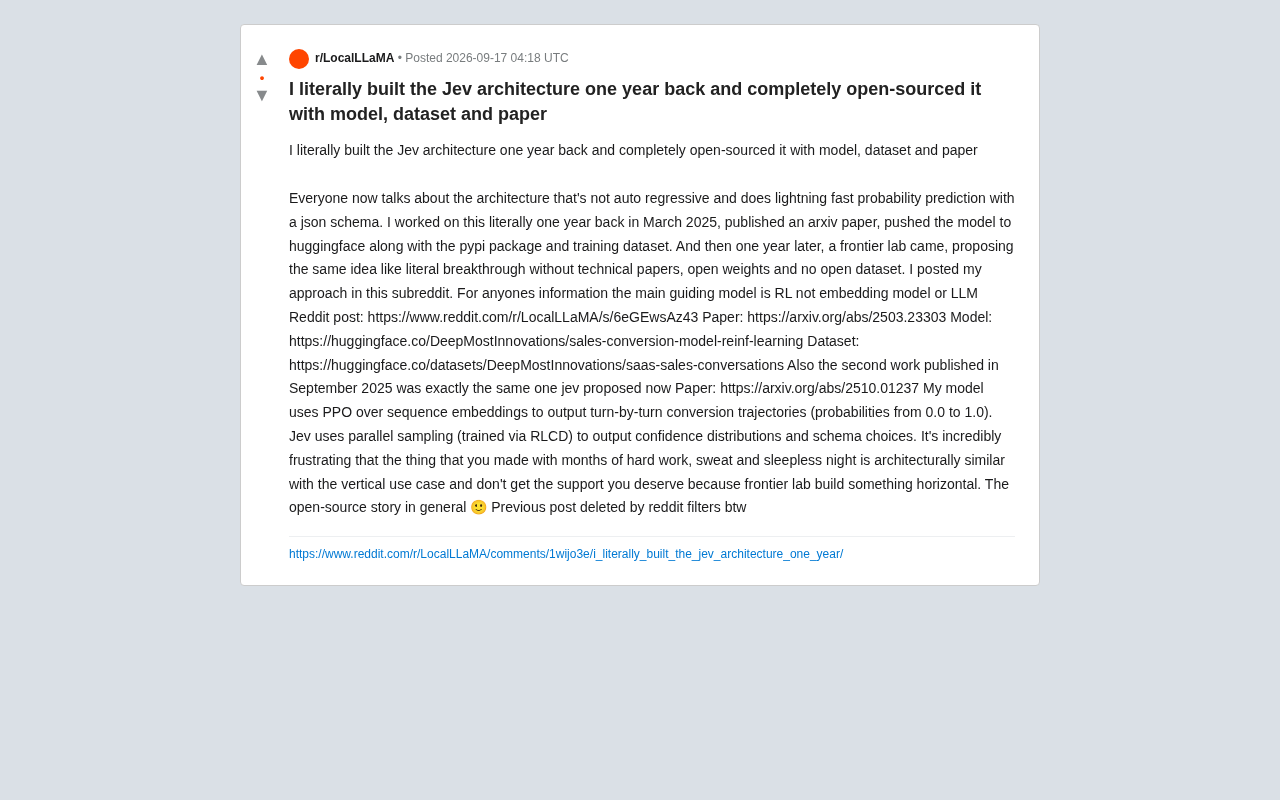
开源之痛:非自回归架构的先行者,为何被前沿实验室抢了风头
一位独立开发者在 Reddit 发帖称,其一年前开源的非自回归 RL 架构,被前沿实验室重新包装为突破。本文拆解 PPO 序列嵌入与 RLCD 并行采样两种路线的异同,并探讨开源生态的溯源与署名困境。
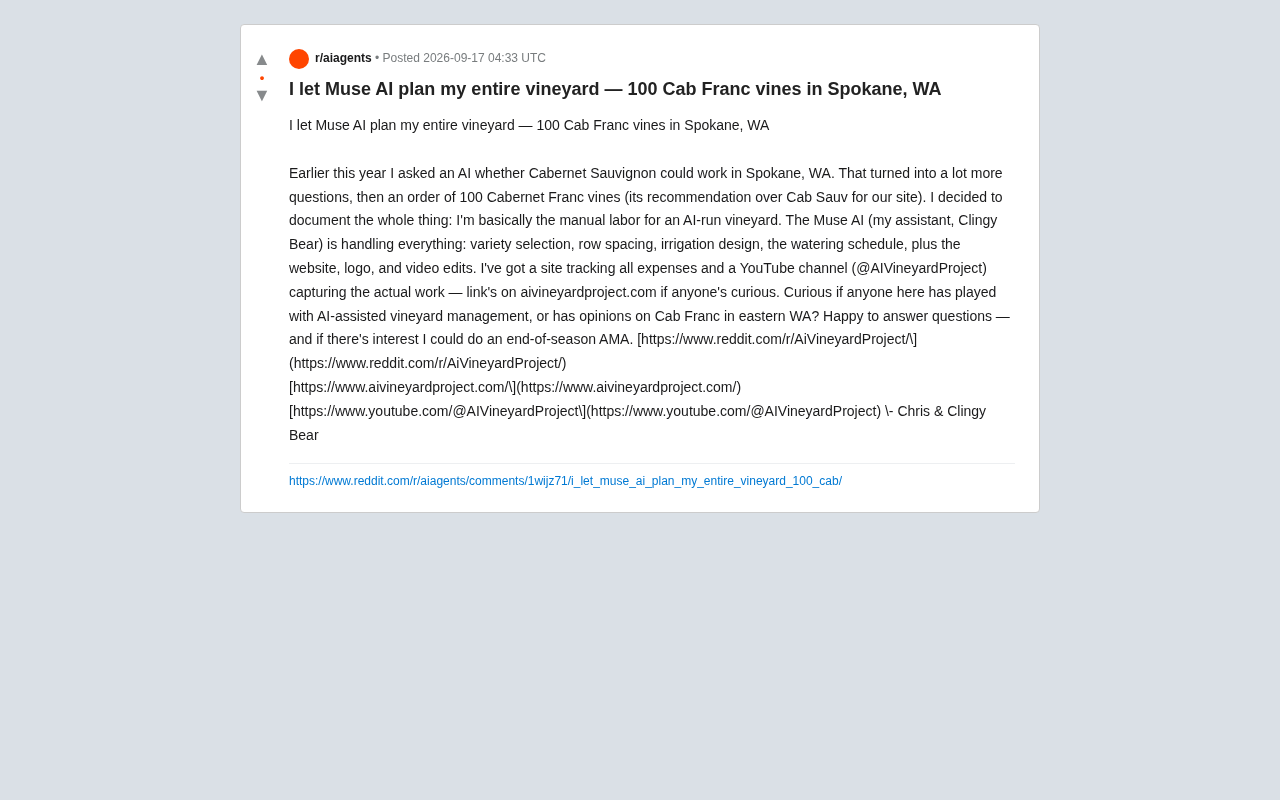
AI全程规划葡萄园:一场100株葡萄藤的真实实验
华盛顿州斯波坎一位爱好者让Muse AI全程规划葡萄园,从品种选择、行距到灌溉全部交给AI,最终种下100株品丽珠。这场AI主导、人类执行的公开实验,揭示了AI辅助农业的机会与边界。