开源之痛:非自回归架构的先行者,为何被前沿实验室抢了风头
独立开发者称自己比前沿实验室早一年完整开源了类似非自回归RL架构,揭示开源原创性与传播影响力的结构性失衡。
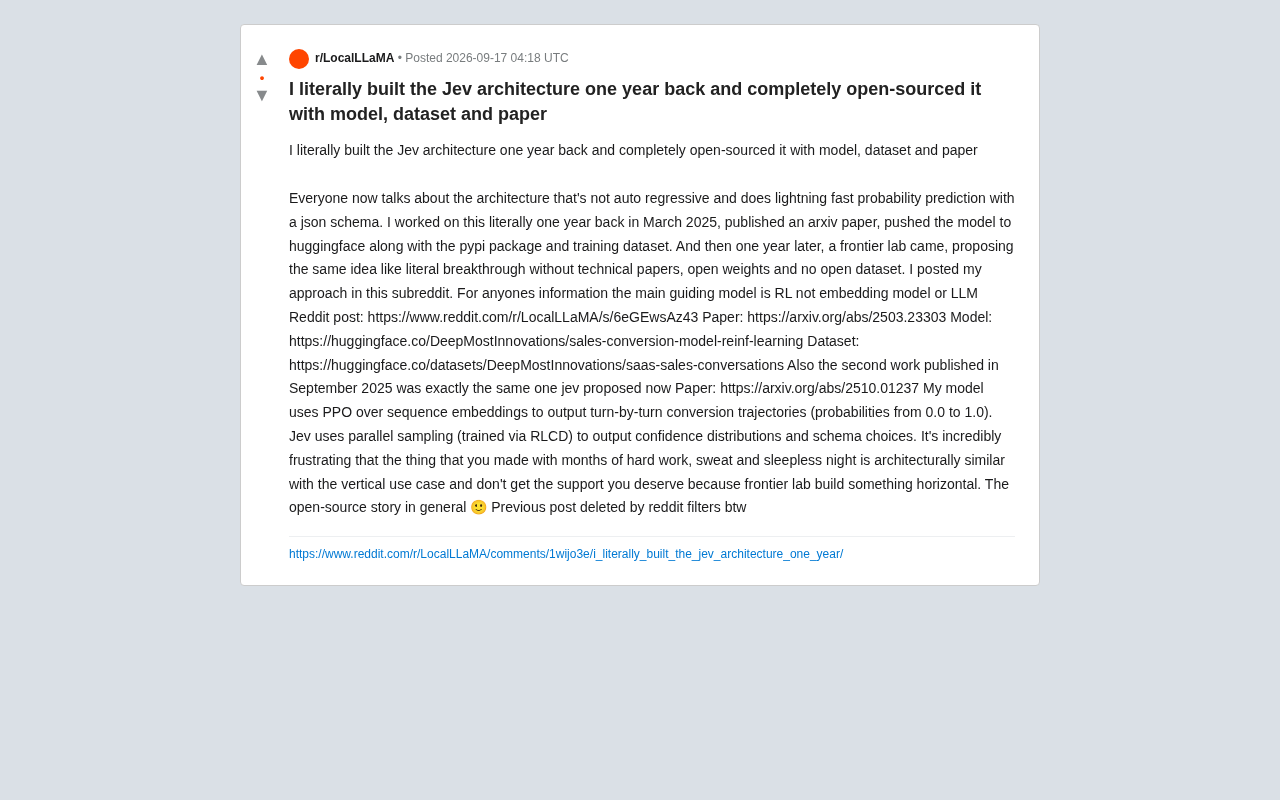
一位独立开发者在Reddit上发帖称,当前被前沿实验室作为"突破性创新"推出的非自回归架构,其核心思路他早在一年前便已完整实现并开源,包括论文、模型权重与训练数据集。他的方案基于PPO在序列嵌入上输出逐轮转化概率,应用于销售对话场景;被对标的方案则采用并行采样与RLCD输出置信度分布,定位更为通用。帖子触及了开源生态的结构性矛盾:完整开源并不自动带来影响力,前沿实验室凭借品牌与资源即便后发也能迅速占据话语权。需要注意的是,架构相似性的判断目前仅来自作者本人,尚无独立第三方验证。
一个开发者的开源困境
近日,Reddit 的 r/LocalLLaMA 社区里出现了一篇引发共鸣的帖子。一位独立开发者声称,如今被热议、被前沿实验室当作"突破性创新"推出的某种非自回归(non-autoregressive)架构,其核心思路他早在一年前就已经完整实现,并且以更彻底的开源方式发布了——模型、数据集、论文一应俱全。
这位来自 DeepMostInnovations 的作者写道:"现在大家都在谈论那种不做自回归、能配合 JSON schema 实现闪电般概率预测的架构。而我一年前就在做这件事了。"他随后附上了 arXiv 论文、Hugging Face 上的模型与训练数据集,以及 PyPI 包的链接。
帖子背后的情绪很直白:当一个人耗费数月心血、无数不眠之夜做出的东西,被一家前沿实验室以"横向通用"的形态重新包装后大受追捧,而原创的"垂直场景"版本却无人问津,这种落差令人沮丧。他还提到,之前的类似帖子曾被 Reddit 的过滤器删除。
两种技术路线的异同
抛开情绪,这篇帖子真正有价值的地方在于它清晰对比了两种技术实现,值得从架构角度拆解。
作者的方案:PPO over Sequence Embeddings
根据作者描述,他的模型使用 PPO(近端策略优化) 在序列嵌入(sequence embeddings)之上进行训练,输出逐轮(turn-by-turn)的转化轨迹——即从 0.0 到 1.0 的概率值。这是一个典型的强化学习驱动的建模思路,应用场景相当垂直:销售对话中的转化率预测。
作者特别强调了一点,供大家参考:"主要的引导模型是 RL(强化学习),而不是嵌入模型或 LLM。"这意味着系统的决策核心由强化学习策略掌控,嵌入只是输入表示的一部分。他将这一工作发表在 arXiv(论文编号 2503.23303),并在 2025 年 3 月完成。
PPO(Proximal Policy Optimization,近端策略优化)是深度强化学习中最常用的策略梯度算法之一,由 OpenAI 于 2017 年提出。其核心思想是在每次参数更新时,通过"裁剪"目标函数来限制策略的变化幅度,从而在探索效率与训练稳定性之间取得平衡。相比早期的 TRPO(信任域策略优化),PPO 实现更简单、计算开销更低,因而成为 RLHF(基于人类反馈的强化学习)流水线中微调大语言模型的主流方法。在本文描述的场景中,PPO 被用来直接优化序列嵌入上的策略,而非生成离散 token,这使得模型可以输出连续的概率值(0.0 到 1.0 的转化轨迹),而非自回归地逐字生成文本。这一设计跳过了传统语言模型的解码过程,让推理速度大幅提升,但代价是模型的通用性受限于特定的结构化输出任务。
被对标的方案:并行采样 + RLCD
作者所对标的架构(他称之为 Jev)则采用 并行采样(parallel sampling),通过 RLCD 进行训练,输出的是置信度分布(confidence distributions)和 schema 选择。
两者的共同点在于:都放弃了传统自回归的逐 token 生成,转而通过强化学习方式直接输出概率化的结构结果。差异在于建模粒度与采样机制——作者的方案聚焦逐轮轨迹预测,对标方案则强调并行置信度分布。作者认为二者"在架构上相似",区别主要落在垂直用例与横向通用之间。
RLCD(Reinforcement Learning from Contrast Distillation,对比蒸馏强化学习)是一种无需人工标注偏好数据即可进行强化学习对齐的方法。其基本思路是让同一模型在不同提示条件下生成"正向"与"负向"样本对,再以这些对比样本替代人类反馈来训练奖励模型或直接优化策略。与 RLHF 相比,RLCD 降低了对大规模人工标注的依赖,更适合资源有限的研究团队。并行采样(parallel sampling)则是指在推理阶段同时生成多条候选输出,再从中选取置信度最高或最符合 schema 约束的结果,而非串行地逐 token 生成单一序列。两者结合,使得该架构能够在不依赖自回归解码的前提下,高效输出符合 JSON schema 约束的结构化结果,这正是其被认为具备"闪电般概率预测"能力的技术基础。
开源生态的结构性问题
这篇帖子之所以能引起讨论,不只是个人抱怨,而是触及了开源社区一个反复出现的结构性矛盾。
作者的核心不满在于:他做了"更负责任"的开源——公开论文、开放权重、公开数据集——而前沿实验室推出类似想法时,往往没有技术论文、没有开放权重、也没有开放数据集,却被当作"重大突破"广泛传播。
这里存在一个残酷的现实:技术的原创性与传播影响力并不成正比。前沿实验室拥有品牌、算力、市场触达能力和横向通用的产品定位,即便晚一年提出相似思路,也能迅速占据话语权。而独立开发者即便更早、更开放,也可能因为垂直场景的受众狭窄、缺乏推广资源而被忽视。
需要说明的是,这篇帖子的所有主张目前仅来自单一来源,即作者本人的陈述。架构"相似"的判断也出自作者自己的对比,外界尚无独立的第三方技术验证。因此在评价"谁先谁后""是否被抄袭"这类问题时,应保持审慎。
在学术与工程社区中,"优先权"(priority)的认定通常依赖于可查证的公开时间戳,如 arXiv 预印本的提交日期、代码仓库的 commit 记录或会议论文的接收时间。然而,优先权的存在并不等同于影响力的归属。在 AI 领域,一个思路从"被某人实现"到"被广泛引用"之间,往往存在巨大的传播鸿沟。知名实验室发布的工作通常能在数天内获得数千次引用和媒体报道,而独立研究者的同类工作即便早发布数月,也可能长期停留在个位数的引用量。这种不对称性并非单纯的"剽窃"问题,更多源于信息传播的马太效应:已有影响力的主体更容易获得更多影响力。这也是为什么 arXiv 的时间戳虽然客观存在,却无法自动转化为社区认可——技术发现的"被发现"本身,仍然需要社会资本与传播资源的加持。
给开源开发者的启示
无论这场具体争议的是非如何,帖子折射出的几点对开源开发者颇有参考价值。
完整开源(模型 + 数据 + 论文 + 可安装包)在学术诚信和可复现性上无可指摘,但它并不自动带来影响力。想让工作被看见,除了发布,还需要持续的传播、社区运营和场景落地的证明。
垂直场景的先发优势也容易被横向通用方案覆盖。当一个通用平台把某种能力做成"人人可用"的功能时,早期在细分领域的探索很容易被遮蔽。这提醒开发者,在选择技术方向时,要么把垂直场景做深做透形成壁垒,要么尽早抢占更通用的叙事。
对整个社区而言,如何建立更公平的溯源与署名机制——让真正的先行者获得应有的承认——仍是开源文化中一个悬而未决的老问题。这位开发者用一句无奈的话概括了处境:"这就是开源的故事。🙂"
相关推荐
冰岛Treble获1800万美元融资,押注语音仿真平台
冰岛语音仿真公司Treble完成1800万美元融资,其平台服务于语音AI模型开发者、AI可穿戴设备及机器人公司。本文解析语音仿真技术价值与融资背后的行业信号。
AI全程规划葡萄园:一场100株葡萄藤的真实实验
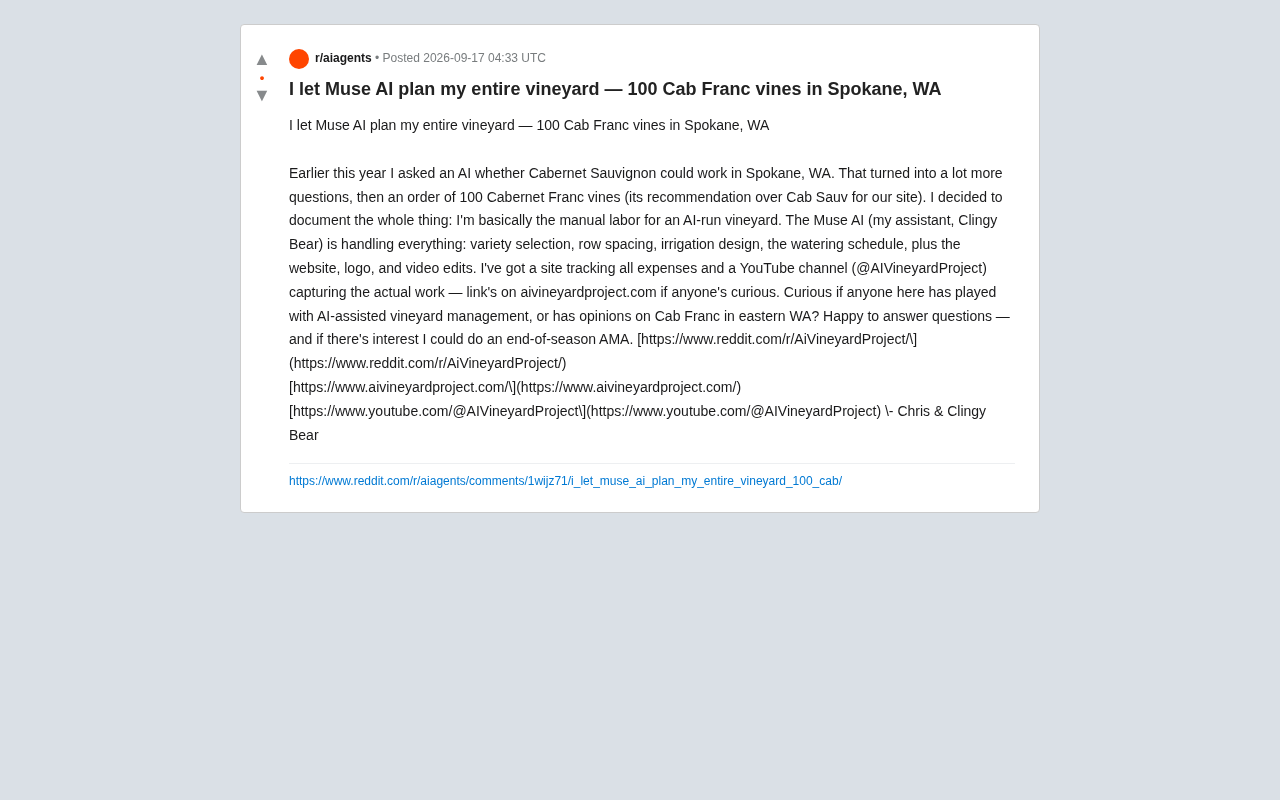
华盛顿州斯波坎一位爱好者让Muse AI全程规划葡萄园,从品种选择、行距到灌溉全部交给AI,最终种下100株品丽珠。这场AI主导、人类执行的公开实验,揭示了AI辅助农业的机会与边界。
让Qwen跑63小时攻克黎曼猜想:一次开源模型自主推理实验
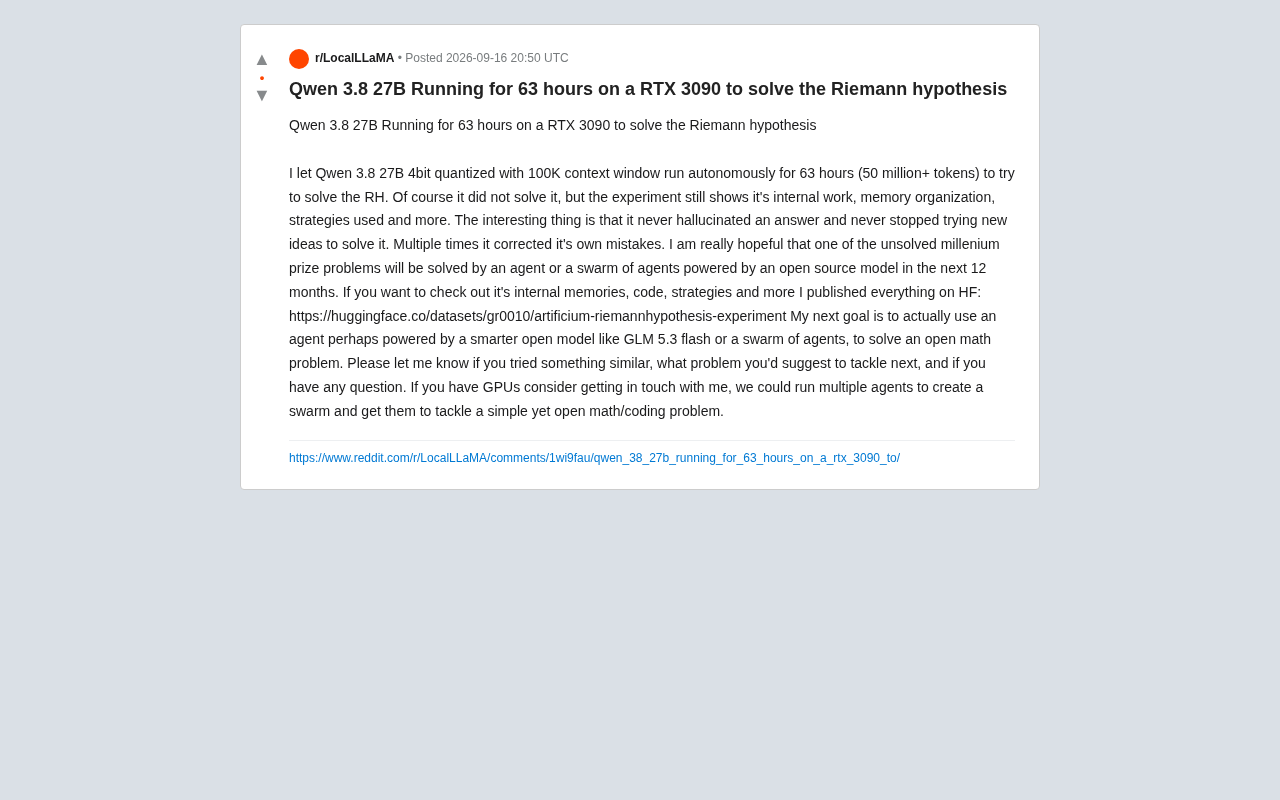
一位开发者让Qwen 3.8 27B在RTX 3090上自主运行63小时、生成5000万tokens尝试证明黎曼猜想。虽未成功,但模型展现出无幻觉、持续尝试、自我纠错等特性,为AI Agent自主推理研究提供了宝贵数据。