大模型分布式训练全解析:DP/TP/PP/SP一次讲透
单卡显存装不下大模型,需用DP、TP、PP、SP组合并行来扩展容量与吞吐。
文章从大模型逐Token前向计算的原理出发,指出模型参数动辄数百GB而单卡显存仅数十GB,这一根本矛盾驱动了分布式并行。随后逐一拆解四类并行策略:数据并行(DP)复制模型、扩展吞吐但不降低单卡显存占用;张量并行(TP)在层内切分权重、通信频繁,适合节点内高带宽互联;流水线并行(PP)按层切分、通信量小可跨节点,但存在气泡问题需靠微批次填充;序列并行(SP)在序列维度切分激活值,常与TP配合应对长上下文。文章最后给出实践判断逻辑——先看模型能否放进单卡,再决定堆吞吐还是上模型并行,并澄清了量化不等于可单卡部署、DP不能扩展容量两个常见误区。
为什么单卡跑不动大模型?
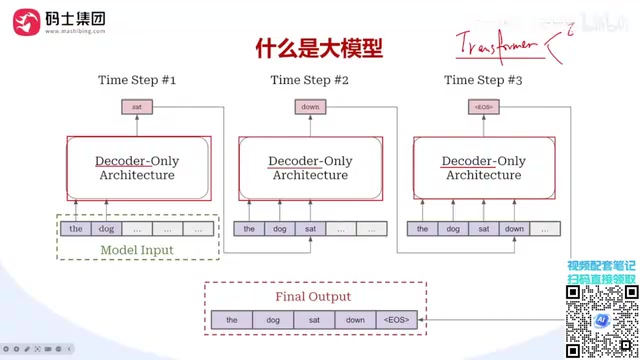
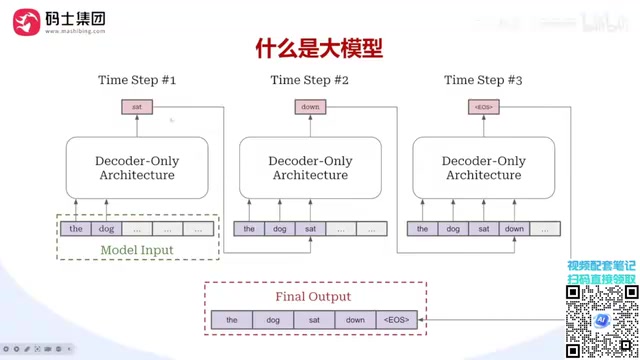
大模型本质上是一个Decoder-Only架构的神经网络,它逐Token生成输出,每生成一个词都需要进行一次前向计算。这个计算可以简化为:输入数据X乘以模型参数W,得到结果Y。为了让计算足够快,X和W都需要加载到GPU显存中。
问题在于,模型体积远超单张显卡的显存容量。据B站教程中的演示,当前主流大模型的参数文件动辄数百GB,而即便是较新的消费级或数据中心GPU,单卡显存也往往只有数十GB。讲者用自己台式机上的老显卡举例,显存仅十来个GB,根本无法直接加载数百GB的模型。
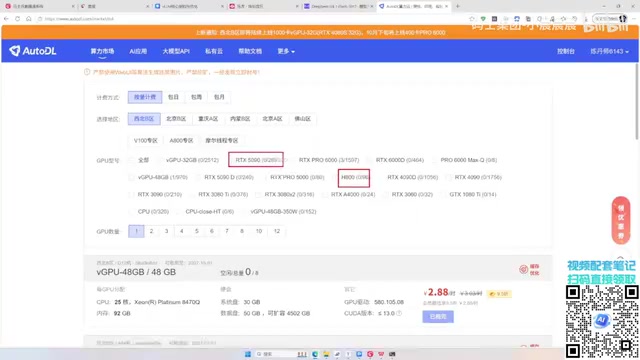
即便转向AutoDL这类GPU租赁平台,可选型号如H800、5090、A800、V100等,单卡显存从数十GB到80GB不等,仍然装不下一个满血版大模型。量化压缩能减小体积,但教程中展示的量化版本依然达到上百GB,单卡依旧无法承载。
这就是分布式并行训练与部署的根本驱动力:当模型放不进一张卡,就必须把计算和存储拆到多张卡上协同完成。
数据并行(DP):最直观的扩展方式
数据并行解决的是“计算量太大、单卡算得太慢”的问题。它的思路是把同一份模型参数复制到多张GPU上,每张卡处理不同的数据批次,各自计算梯度,再通过通信把梯度汇总同步。
这种方式的优势是实现简单、对模型结构无侵入,几乎所有训练框架都原生支持。代价是每张卡都要完整保存一份模型参数,显存占用没有降低——它扩展的是吞吐量,而不是模型容量。当模型本身大到单卡放不下时,DP就无能为力了。
模型并行(TP/PP):把模型拆开
模型并行针对的正是“模型装不下”的场景,它把模型本身切分到多张卡上。教程重点拆解了两种主流路线。
张量并行(TP)
张量并行在层内部做切分。以矩阵乘法为例,可以把权重矩阵按行或按列拆到不同GPU上,每张卡只计算一部分,再通过All-Reduce等通信操作拼出完整结果。它的粒度细、通信频繁,对卡间带宽要求很高,通常局限在单机或高带宽互联的节点内部。
All-Reduce 是分布式计算中最常用的集合通信原语之一:所有参与设备各自持有一份数据,通信结束后每台设备都得到所有设备数据的归约结果(如求和)。在张量并行中,按列切分的权重矩阵各自算出部分结果后,需要通过 All-Reduce 把各卡的部分和相加,才能得到完整的输出张量。与之配套的还有 All-Gather(把各卡分片拼接成完整张量)和 Reduce-Scatter(先归约再分片散发)。这些操作的耗时主要由卡间带宽决定,因此 TP 通常只在 NVLink 等高速互联的单机范围内使用;一旦跨节点走普通网络,通信开销会迅速吞掉并行带来的收益。
流水线并行(PP)
流水线并行按层切分。比如前若干层放在GPU 0,中间层放在GPU 1,后段放在GPU 2,数据像流水线一样依次流过各卡。它的通信量比TP小,适合跨节点扩展,但会引入“气泡”问题——部分卡在等待上游结果时处于空闲状态,需要靠微批次调度来填充。
“气泡”(Bubble)指的是流水线中设备空闲等待的时间。若把模型按层切成若干段依次放在不同 GPU 上,且一次只处理一个批次,那么同一时刻只有一张卡在工作,其余卡都在等上游输出,设备利用率极低。解决办法是把一个大批次拆成多个微批次(Micro-batch),让各段设备像工厂流水线一样连续处理不同微批次,从而把空闲时间填满。气泡比例大致与“流水线级数减一”成正比、与微批次数量成反比,因此增加微批次或减少切分段数都能提升利用率,但前者受显存限制、后者受单卡容量限制,需要在实践中权衡。
序列并行(SP):长上下文的补充手段
序列并行是在序列维度上做切分,把一条长序列拆成多段分给不同设备处理。它常用于长上下文场景,与张量并行配合使用,进一步降低单卡在激活值上的显存压力。教程将其定位为对DP/TP/PP体系的补充,而非替代。
实战视角:先判断瓶颈在哪
教程给出的实践逻辑很清晰:先判断模型能否放进单卡。放得下但算得慢,用数据并行堆吞吐;放不下,就上模型并行,层内用TP、层间用PP,长序列再叠加SP。实际部署中往往是混合并行——TP控制在小范围内保证通信效率,PP跨节点扩展,DP在最外层放大吞吐。
据B站该教程的讲解,这套并行体系与模型本身的神经网络结构耦合并不深,小白也能理解,对于私有化部署和模型训练都是很实际的需求。
常见误区
一个容易被忽略的点是:量化并不等于可以单卡部署。教程中演示的量化模型体积依然庞大,量化只是降低了单位参数的比特数,并不能改变“模型容量超过单卡显存”这一基本事实。另一个误区是把DP当成万能扩展手段——它只扩展吞吐,不扩展容量,模型装不下时DP帮不上忙。
理解DP、TP、PP、SP各自的切分维度和通信代价,才能在真实场景中组合出合理的并行方案。
量化(Quantization)指用更低的数值精度存储和计算参数,常见做法是把原本 16 位浮点的权重压缩到 8 位、4 位甚至更低,从而让模型体积按比例缩小。它分为仅量化权重(Weight-only)和权重与激活值同时量化两类,前者部署简单、精度损失较小,是私有化部署中最常见的形式。但量化有明确的下限:4 位量化大致只能把体积压到原来的四分之一,一个数百 GB 的模型量化后仍有数十 GB 以上,再加上推理时的 KV Cache 和激活值开销,单卡依然可能放不下。因此量化应被视为降低部署成本的优化手段,而非替代并行方案的容量解决方案。
背景补充
激活值(Activation)是前向计算过程中产生的中间张量,需要保留到反向传播时用于计算梯度,因此同样占用显存。模型参数是静态的、体积可预估,而激活值随批次大小和序列长度增长,在长上下文场景下甚至可能超过参数本身成为显存瓶颈。序列并行正是针对这部分开销:它把沿序列维度切分的激活值分散到各设备,在需要完整上下文的地方(如 LayerNorm、注意力中的部分运算)通过通信聚合。由于它切分的是激活而非权重,常与张量并行叠加使用,形成“权重切分 + 激活切分”的组合,进一步压低单卡显存压力。
相关推荐

Dify 工作流实战:本地部署与私有知识库智能体落地指南
基于 B 站 Dify 实战课程整理:Windows Docker 本地部署、MySQL 连接配置、五类应用与工作流节点案例、外部大模型接入选择,以及应用发布为站点或 API 的完整落地路径。
DeepSeek Harness保姆级教程:安装配置到插件实战
DeepSeek Harness保姆级教程:详解Node.js环境配置、客户端安装步骤,以及对话式、插件市场、命令行三种插件安装方式,助你快速上手这款开源AI Agent框架。
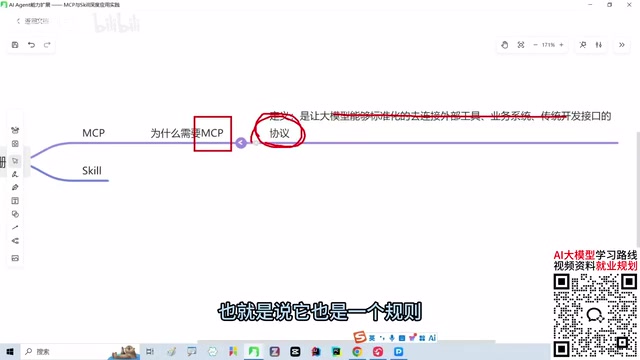
MCP入门指南:大模型连接外部工具的标准化协议
基于B站公开课内容,解析MCP协议的核心定义与价值:为什么大模型需要标准化工具连接协议,如何通过MCP封装复用传统软件接口,以及MCP与Skill的概念区分,为Agent开发者提供入门指引。