Dify 工作流实战:本地部署与私有知识库智能体落地指南

Dify 课程评测:从本地部署到数据库、工作流、模型接入与发布的完整落地路径。
本文评测了一套基于 Windows + Docker 的 Dify 实战课程,梳理其从部署、数据库接入、应用构建到发布的全链路内容。文章首先解释 Dify 的五种应用类型——聊天助手、文本生成、Agent 智能体、Chatflow 和 Workflow,并指出工作流分多轮对话与一次性输出两种形态。课程建议生产环境自部署以直连本机 MySQL,避免在线版的内网穿透麻烦。工作流学习采用“一个节点一个案例”的方式,强调节点间数据传递与分支逻辑才是难点。模型接入上推荐 DeepSeek 等付费外部模型,成本极低,文心一言和通义千问提供百万级免费 token,本机模型可经 Ollama 接入但需足够硬件。发布环节支持公开站点、嵌入网站和 API 三种出口,其中 API 接入业务系统实用价值最高。整体偏向工程落地,适合 Windows 环境开发者,但 Linux 部署细节覆盖较少。
为什么需要关注 Dify
B站上关于 Dify 的教程不少,但多数停留在界面点按层面。这期课程的价值在于它把「部署—数据接入—应用构建—发布」串成了一条完整的落地路径,而不是孤立地演示某个功能。从内容看,讲师基于 Windows + Docker 演示了 Dify 的本地部署,并配套 MySQL 8 的安装与连接配置,目标很明确:让你构建的 AI 应用能真正读写本机数据库,而不是只能做个玩具 Demo。
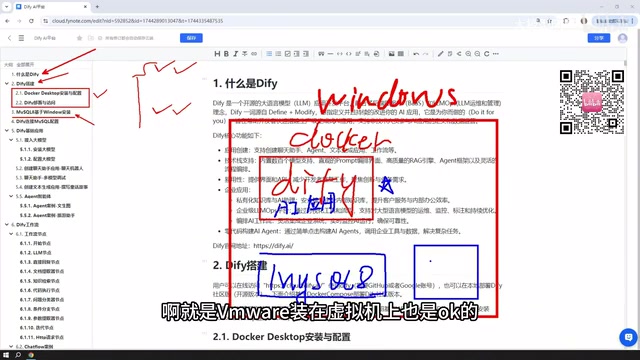
Dify 本质上是一个 AI 应用开发平台,在线版和自部署版界面几乎一致。但讲师建议生产环境走自部署,原因很实际——当你的应用需要访问内网数据库时,在线版得靠内网穿透把本机 IP 暴露到公网,既麻烦又多一层风险。本地 Docker 部署则能让 Dify 直接与 Windows 上的 MySQL 通信,虚拟机里的数据库也能互通,部署位置比较灵活。
Dify 的五种应用类型,先分清再动手
课程把 Dify 的应用归纳为五类:聊天助手、文本生成、Agent 智能体、Chatflow 和 Workflow。前三个属于基础应用,后两个是工作流的两条分支。
聊天助手和文本生成理解起来不费力,前者对话、后者产出文章或文档。Agent 智能体的差异点在于能调用工具,比如先抓取网页再做分析,这类多步任务它自己能编排。
工作流这一层值得多花点时间。Chatflow 支持与工作流进行多轮对话,Workflow 则偏向一次性输入输出。讲师在视频里坦言,没接触过 Dify 时听这个区别容易云里雾里,所以后面配了详实案例来展开。这个处理方式是对的——工作流的概念脱离具体节点去讲,很难讲透。
工作流节点与案例驱动
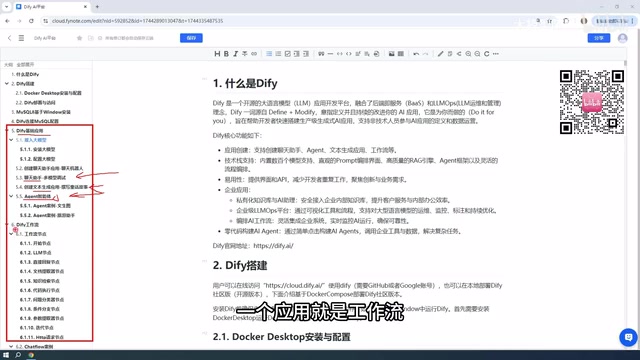
工作流由一个个节点组成,课程覆盖了 Dify 官方提供的大部分常用节点,每个节点配案例讲解。据讲师的说法,仅节点部分就准备了十几个案例,加上 Chatflow 和 Workflow 的完整流程案例,体量不算小。
这种「一个节点一个案例」的排布方式,对初学者比较友好。工作流的难点往往不在单个节点,而在于节点之间的数据传递和分支条件设计。先建立节点级别的肌肉记忆,再去拼装完整流程,学习曲线会平缓一些。
Dify 工作流中的节点是构成流程的基本单元,常见类型包括开始节点、LLM 节点、知识检索节点、代码执行节点、条件分支节点、HTTP 请求节点、变量聚合节点和结束节点等。每个节点都有输入和输出变量,节点之间通过变量引用传递数据。例如,LLM 节点可以引用开始节点传入的用户问题,也可以引用知识检索节点返回的文档片段。条件分支节点则根据上游变量的值决定后续走向,是实现复杂逻辑的关键。理解节点的输入输出契约,是避免工作流运行报错的前提。
大模型接入:付费模型优先的现实考量
课程明确建议接入外部付费模型,而不是本机跑小模型。理由很直接:本地部署的模型一般规模较小,实际效果不够理想。讲师的建议是优先考虑 DeepSeek广告 这类付费服务,充值十元能用很久——他展示自己的账户,用了不到一块钱就撑了很长时间。
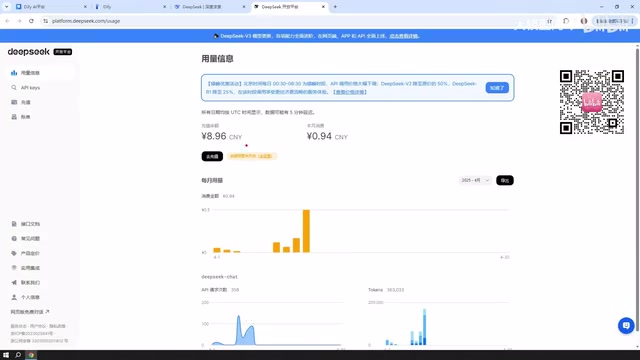
对于想零成本起步的人,百度文心一言和阿里通义千问广告注册后都有免费 token 额度,据讲师描述在百万级别,日常测试基本够用。课程也会给出各平台的申请入口。
本机模型这条路并非完全堵死。Dify 支持整合 Ollama 部署的本地模型,课程也配了案例。如果你的机器性能足够好,或者走企业级集群部署,下载参数量很大的开源模型(比如 DeepSeek 开源的最大版本,体积达到数百 GB 量级),效果会明显好于小模型。
Ollama 是一个开源的本地大模型运行工具,支持在 Windows、macOS 和 Linux 上一键下载并运行 Llama、Qwen、DeepSeek 等开源模型。它通过兼容 OpenAI 的 API 接口对外提供服务,因此 Dify 可以将其作为自定义模型供应商接入。本地运行的效果取决于模型参数量和机器显存,7B 至 14B 的小模型在消费级显卡上即可运行,但推理能力和上下文长度有限;70B 以上的模型通常需要多卡或大内存服务器。使用 Ollama 的好处是数据完全不出本地,适合隐私敏感场景,代价是硬件成本与推理速度。
从构建到发布:别让应用困在本地
Dify 构建好的应用有多种出口。课程提到可以发布为公开 Web 站点生成可访问链接,也可以嵌入到自己开发的网站,或者通过 API(包括 Python API)的方式调用。公开站点这条路同样涉及内网穿透,这和在线版遇到的是同一类问题。
这个发布环节常被教程忽略,但它决定了你花时间搭出来的东西是自娱自乐还是真正交付。API 方式尤其值得留意——把 Dify 应用作为后端能力接进现有业务系统,比单独开一个聊天页面更有实用价值。
内网穿透(NAT 穿透)是指通过公网服务器中转,将内网服务映射到公网可访问地址的技术,常见工具包括 frp、ngrok、cpolar 等。Dify 在线版部署在云端,无法直接访问你本机或公司内网中的 MySQL 数据库,因此需要借助内网穿透把数据库端口暴露到公网,再让云端 Dify 连接。这种做法会引入额外的网络延迟,并且将数据库端口暴露在公网存在安全风险,需要配合防火墙和访问控制。自部署 Dify 时,Dify 与数据库处于同一内网,可以直接通过内网 IP 通信,无需穿透,这也是讲师建议生产环境自部署的核心原因之一。
整体评价
这套课程的结构是「概念—部署—数据库—工作流—模型接入—发布」的完整链路,偏向工程落地而非功能罗列。适合有 Windows 环境、想在自己机器上跑通私有知识库问答或工具型智能体的开发者。需要留意的是,视频中提到的 Dify 工作流当时仍是测试版本,讲师判断已比较稳定,但版本迭代带来的界面变化需要自行对照最新文档。另外课程以 Windows + Docker 为主线,Linux 服务器部署的细节覆盖较少,生产环境用户需要补充这方面的知识。
相关推荐
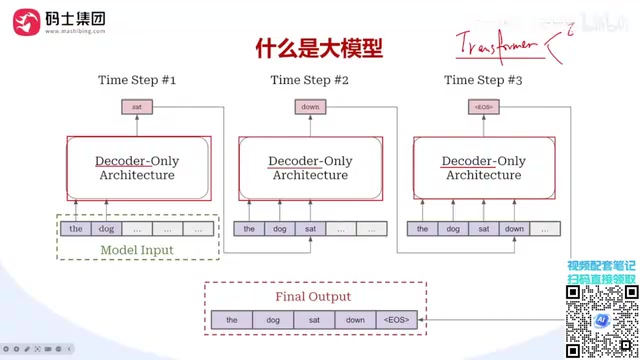
大模型分布式训练全解析:DP/TP/PP/SP一次讲透
从单卡显存瓶颈出发,系统讲解大模型分布式训练中的DP数据并行、TP张量并行、PP流水线并行与SP序列并行,剖析各自切分维度、通信代价与混合并行实战选型逻辑。
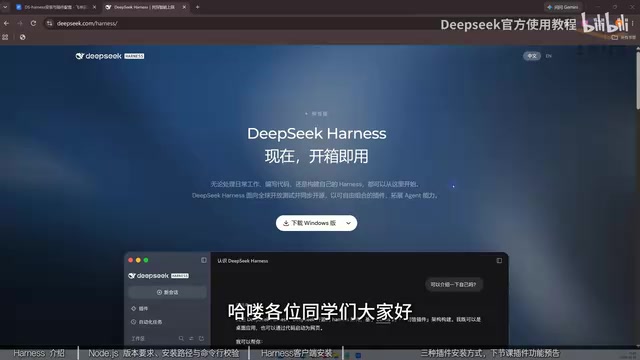
DeepSeek Harness保姆级教程:安装配置到插件实战
DeepSeek Harness保姆级教程:详解Node.js环境配置、客户端安装步骤,以及对话式、插件市场、命令行三种插件安装方式,助你快速上手这款开源AI Agent框架。
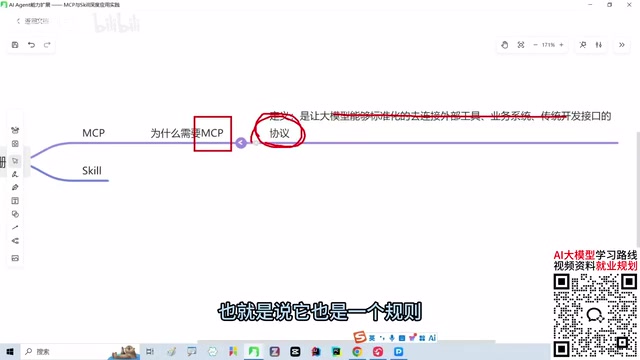
MCP入门指南:大模型连接外部工具的标准化协议
基于B站公开课内容,解析MCP协议的核心定义与价值:为什么大模型需要标准化工具连接协议,如何通过MCP封装复用传统软件接口,以及MCP与Skill的概念区分,为Agent开发者提供入门指引。