大模型应用开发入门:从Prompt到Agent的LLM全栈学习路线

系统梳理从机器学习基础到大模型训练、分词生成及应用场景的LLM全栈入门知识地图。
文章以一套入门课程为蓝本,梳理了从人工智能、机器学习、深度学习到生成式AI和大模型的概念演变脉络,介绍了监督学习、无监督学习与强化学习三种范式。重点讲解了大模型训练三阶段——预训练、监督微调(SFT)和基于人类反馈的强化学习(RLHF),并总结了大模型规模大、数据广、适应性强、算力需求高四大特点,以及语言大模型与多模态大模型的分类。随后解释了分词、Token和自回归生成的工作流程,并以通义千问及其通义灵码、听悟、法睿等垂直应用为例展示落地场景。最后给出转行学习建议,强调把握三条主线,为Prompt工程和Agent开发打下概念基础。
大模型应用开发入门:从Prompt到Agent的LLM全栈学习路线
大模型正在重塑软件开发的底层逻辑。对于希望转行或拓展技能边界的开发者来说,理解LLM的核心概念、训练流程和应用场景,已经成为一项绕不开的基本功。本文基于一套系统性的入门课程内容,梳理从机器学习基础到大模型应用的完整知识脉络,帮助你建立清晰的LLM全栈认知框架。
从人工智能到大模型:概念演变的四条线索
理解大模型,需要先理解它所在的坐标系。人工智能是一个广泛的交叉学科领域,涵盖计算机科学、统计学、语言学、神经科学乃至哲学。机器学习是人工智能的核心子集,而深度学习又是机器学习的分支,主要依赖神经网络(输入层、隐藏层、输出层)对数据进行学习和表征。
生成式人工智能则是深度学习当中增长最快的子集。它基于大规模无标注数据对深度模型进行预训练,使机器能够理解语言和图像,并根据问题生成答案。大模型正是生成式AI的核心载体——2021年斯坦福大学研究员发表论文,提出了“基座大模型”(Foundation Models)概念,定义为具有十亿级以上参数、能在广泛数据上训练并适用于多种任务的预训练深度模型。
2022年11月,OpenAI发布ChatGPT,它在语言理解和生成能力上实现了重大突破,被业界视为AI产业发展的标志性事件。此后,国内大厂纷纷跟进:百度的文心一言、阿里巴巴的通义千问广告、商汤科技、华为盘古、科大讯飞、字节跳动、京东、腾讯等相继推出自研大模型。其中阿里巴巴在2023年8月发布通义千问系列开源大模型,推出7B、72B等不同规模版本,目前已升级至通义千问2,具备自然语言处理、视觉理解、音频处理以及AI Agent等多模态交互能力。
Transformer架构是理解当前大模型绕不开的技术基石。它由Google在2017年的论文《Attention Is All You Need》中提出,核心创新是自注意力机制(Self-Attention),允许模型在处理序列中的某个位置时,同时关注序列中所有其他位置的信息,并动态计算它们之间的关联权重。相比此前主流的RNN和LSTM必须按顺序逐步处理数据,Transformer可以并行处理整个序列,极大提升了训练效率。同时,自注意力机制让模型能够捕捉长距离的语义依赖,解决了RNN在长文本上容易“遗忘”早期信息的问题。正是这一架构使得参数量扩展到十亿甚至千亿级别成为可能,是GPT、BERT、通义千问等几乎所有主流大模型的底层骨架。
参数是大模型的“记忆容量”。它指的是神经网络中可学习的权重和偏置,每个参数本质上是一个数值,模型通过训练不断调整这些数值以拟合数据中的规律。参数量越大,模型能存储和表达的模式越复杂,但相应地需要更多训练数据和算力。十亿级参数意味着模型内部有十亿个可调旋钮,这也是“基座大模型”概念的量化门槛。
机器学习三种范式:监督、无监督与强化学习
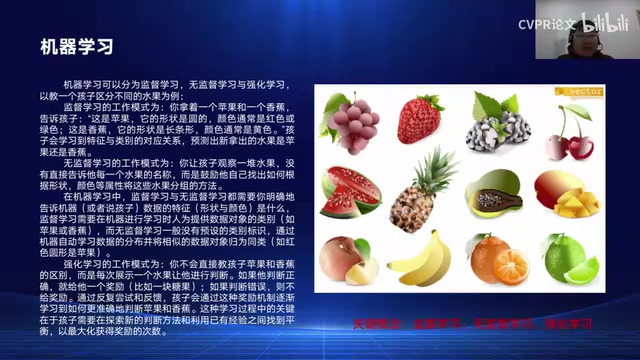
课程中用“教小孩认水果”的类比来解释机器学习,形象且易于理解。
监督学习就像拿着苹果和香蕉告诉小孩:这个是苹果,圆的、红色或绿色;这个是香蕉,长条形、黄色。小孩学到特征与类别的对应关系后,面对新水果就能做出判断。这要求人为提供标注好的数据类别。
无监督学习则是让小孩观察一堆水果,不告诉名称,鼓励他自己发现形状、颜色等属性并进行分组。机器在没有预设类别标识的情况下,自动对数据对象进行归类和聚类。
强化学习是一种引导式学习。每次展示一个水果让小孩判断,判断对了给糖果作为奖励,错了则不给。反复尝试和反馈之后,小孩逐渐找到获取最多奖励的策略。这种奖励机制正是大模型对齐人类偏好的关键手段。
深度学习:模拟大脑的算法架构
深度学习模拟人脑神经网络的工作方式,通过对大量数据的学习自动提取特征和模式,进而实现图像识别、语音识别、自然语言处理等任务。按照网络架构不同,可分为卷积神经网络(CNN)、循环神经网络(RNN)、Transformer等。
课程中同样用水果场景做类比:带小孩去超市,不解释每种水果的特点,小孩通过自己的观察和比较,慢慢学会辨认。对应到模型层面,深度学习可以自动从复杂的视觉、嗅觉等信息中提取层次化特征(圆形、条形、颜色、气味),并基于这些特征完成识别任务。
大模型训练三阶段:预训练、SFT与RLHF
大模型的训练分为三个核心步骤,课程用“人的成长”做类比非常直观。
预训练:从婴儿到大学毕业
预训练阶段,模型像一个人从出生到大学毕业,学习语言习惯、知识体系和各类通识内容。对大模型而言,它在这个阶段学习海量语料,掌握语言的统计规律和一般知识。但预训练模型只学会了“补全句子”,并未真正领会人类意图——你问它“埃菲尔铁塔在哪个国家”,它可能不是回答“法国”,而是根据语料模式输出一个看似合理却不对题的答案。
监督微调(SFT):中学到大学的专业训练
SFT阶段类似于从中学进入大学,开始学习金融、法律等专业知识。模型在这个阶段学习人类对话语料和垂直领域知识,微调之后能够按照人类意图来回答专业问题。同样问埃菲尔铁塔的位置,SFT后的模型会正确回答“在法国”,而不是机械地做语料补全。
但SFT模型的回答有时仍不符合人类偏好,可能涉及暴力、歧视等不当内容。
RLHF:进入职场,根据反馈调整
RLHF(基于人类反馈的强化学习)类似大学生进入职场。模型对同一问题生成多个回答,人类对这些回答进行打分,模型学习输出分数最高的答案。这个过程就像员工根据领导和客户的表扬或批评来调整工作方式,争取获得更多正面反馈。
预训练的核心目标是自监督学习下的下一个Token预测。模型并不需要人工标注数据,而是从海量文本中自动构造训练信号:把一句话的前半段作为输入,让模型预测下一个词,再与真实文本对比来调整参数。这种“自监督”方式使得互联网上的书籍、网页、代码等无标注文本都能成为训练素材,极大降低了数据获取成本。预训练完成后,模型获得的是通用的语言能力和世界知识,但它的行为模式仍是“文本补全”而非“回答问题”,这也是为什么需要后续的SFT和RLHF来对齐人类意图。
RLHF中的奖励模型是连接人类偏好和模型优化的关键组件。具体流程是:先让SFT模型对同一问题生成多个不同回答,再由人类标注员对这些回答按质量排序或打分,用这些偏好数据训练一个独立的“奖励模型”(Reward Model),让它学会预测人类会给某个回答打多少分。随后,大模型在强化学习过程中以奖励模型的评分为优化目标,不断调整自身策略以获取更高奖励。这样就把难以直接优化的人类主观偏好,转化为可量化的数学目标。
大模型的四大特点与两大分类
四大核心特点
规模与参数量大:数亿级到千亿级参数,能捕获复杂的数据模式,理解和生成极为复杂的信息。
训练数据广泛:使用大量多样化数据进行预训练,掌握更广泛的知识和多语言、多模态特征。
适应性和灵活性强:通过微调即可实现少样本高效学习,具备跨域能力,能快速成为某一领域的“专家”。
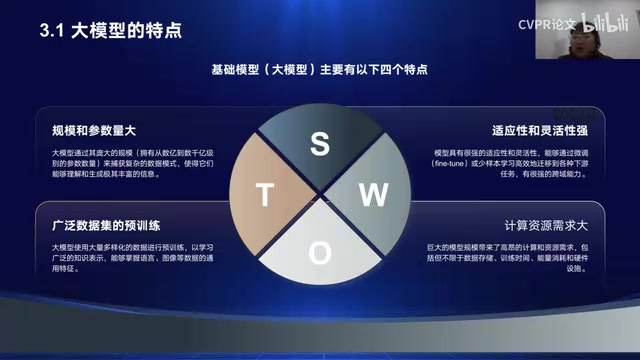
计算资源需求高:普通台式机或笔记本无法胜任训练任务,需要大规模算力、存储和能源支持,对硬件有较高要求。
语言大模型与多模态大模型
按应用场景,大模型大致分为两类。**语言大模型(LLM)**专注于自然语言处理,基于Transformer架构经大规模文本训练而来,能捕捉语法、语境乃至文化知识,典型应用包括文本生成、问答系统、文本分类、机器翻译和对话系统。代表模型有GPT系列、谷歌BERT,以及阿里云的通义千问。
多模态大模型能同时处理和理解文本、图像、音频、视频等不同感知渠道的信息,并在模态之间建立关联和交互,实现跨模态推理、生成和理解。应用涵盖视觉问答、图像生成、跨模态检索和多媒体内容理解。常见的模态组合包括视觉+文本、音频+视觉、音频+文字等。
大模型工作流程:分词、Token与自回归生成
大模型本身不认识汉字,需要通过“分词化”(Tokenization)将文本切分为更小的单元(Token)。这就像一本心话字典,模型根据映射表来识别人类语言。
分词有不同的颗粒度:词级别(Word Level)适用于英语等西方语言;字符级别(Character Level)主要针对中文,按单个汉字切分;子词级别(Subword Level)将单词拆分为词根、词缀等更小单位,能更好地处理新词和专业术语——因为新词的组成部分可能已存在于词表中。
每个Token会预先映射成一个Token ID,一句话会被标记为多个Token序列,供计算机处理。
在生成文本时,大语言模型根据前一个Token预测下一个Token。推理不是一步到位的,而是基于已有Token序列逐步预测、将预测结果加入序列、再预测下一个Token,这个过程称为自回归(Autoregressive),直到输出特殊的结束Token(如EOS)或达到长度限制。模型在每步预测中,会将概率最高的候选词作为下一个Token的输出结果。
分词器(Tokenizer)的选择直接影响模型的效率与表现。词级别分词对英语较为自然,但词表会因新词不断出现而膨胀;字符级别分词虽然词表小,但序列过长,计算成本高;子词级别则介于两者之间,通过BPE(Byte Pair Encoding)等算法,将高频词保留为整体、低频词拆分为子词,既控制了词表规模,又能处理未见过的新词。中文场景下,常见做法是混合使用字级别和子词级别,比如通义千问的Tokenizer就针对中文做了优化,常见词组不会被拆得过碎,从而在表达力和计算效率之间取得平衡。
自回归生成中的采样策略也值得了解。模型每步预测时会输出词表中每个Token的概率分布,如果永远选概率最高的那个(贪心策略),生成结果往往重复且死板;如果按概率随机采样,则可能产生不连贯的内容。实际应用中常用温度参数(Temperature)和Top-p采样来调节:温度高则分布更平坦、输出更多样;温度低则分布更尖锐、输出更确定。这些策略共同决定了模型生成文本的创造性与稳定性之间的平衡。
通义千问的典型应用场景
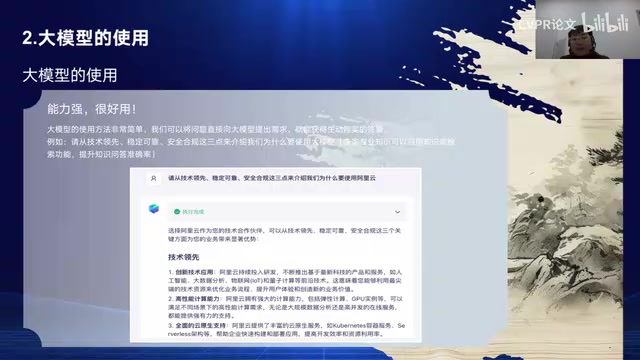
以阿里通义千问为例,其应用已覆盖多个垂直场景。通义灵码面向开发者,可在PyCharm等IDE中安装插件,帮助优化代码、生成代码、添加注释和编写单元测试。通义听悟基于通义千问,实现智能语音转文字和内容分析,适用于会议记录、采访录音、学习笔记生成、视频字幕等场景。通义法睿面向法律需求,融合法律知识,辅助合同审查、法律信息定位、文书起草和法律咨询。
基础的通义千问大模型本身也支持文案撰写、代码编写、问题解答、实时信息查询(如天气)以及复杂图表的解读分析。
转行学习建议
这套课程内容覆盖了从机器学习基础概念到大模型训练原理、工作流程和产品应用的完整知识链路,适合作为转行者的入门地图。建议在学习时重点把握三条主线:一是理解三种机器学习范式的区别与联系;二是吃透预训练、SFT、RLHF三阶段训练的逻辑;三是动手体验主流大模型产品,将理论概念与实际能力对应起来。Prompt工程和Agent开发是后续进阶方向,但扎实的概念基础会让后续学习事半功倍。
Prompt工程是入门后最先接触的进阶方向。它指的是通过设计输入提示词来引导大模型产生期望输出的技术,包括零样本提示、少样本示例、思维链(Chain-of-Thought)等技巧。Prompt工程不需要修改模型参数,成本低、上手快,但效果高度依赖提示词质量。
**Agent(智能体)**则是更高阶的应用形态。它让大模型不仅能回答问题,还能自主规划任务、调用外部工具(如搜索引擎、API、代码执行器)、观察执行结果并迭代调整,直到完成一个复杂目标。典型框架如ReAct(推理+行动)将思维链与工具调用结合,使模型能动态决定下一步该“想”还是该“做”。从Prompt到Agent,本质是从“让模型说对话”走向“让模型做对事”,这也是当前LLM应用开发最活跃的前沿方向。
相关推荐

OpenAI与Shield合作:Astra智能体如何革新IT故障修复
OpenAI与Shield合作推出Astra智能体,可自动登录电脑和遗留系统,实时修复IT故障,比传统模型快35%到40%,仅在需要人类判断时引入人工。

iPhone Duo续航实测:一天一充跑不掉,大屏是耗电元凶
iPhone Duo续航实测:重度使用一天需至少充电一次,6.5小时亮屏约剩30%电量。大屏展开频率是耗电关键,MagSafe电池背夹可救场,长期衰减同样值得关注。

Kimi K3.1 Pro开源发布:2.8万亿参数逼近Opus
Moonshot发布开源MoE模型Kimi K3.1 Pro,2.8万亿总参数、1040亿激活参数,Terminal Bench 4.0仅落后Opus 5.5不到1分,单任务成本约三分之一,API价格减半,开源权重11月4日开放。